
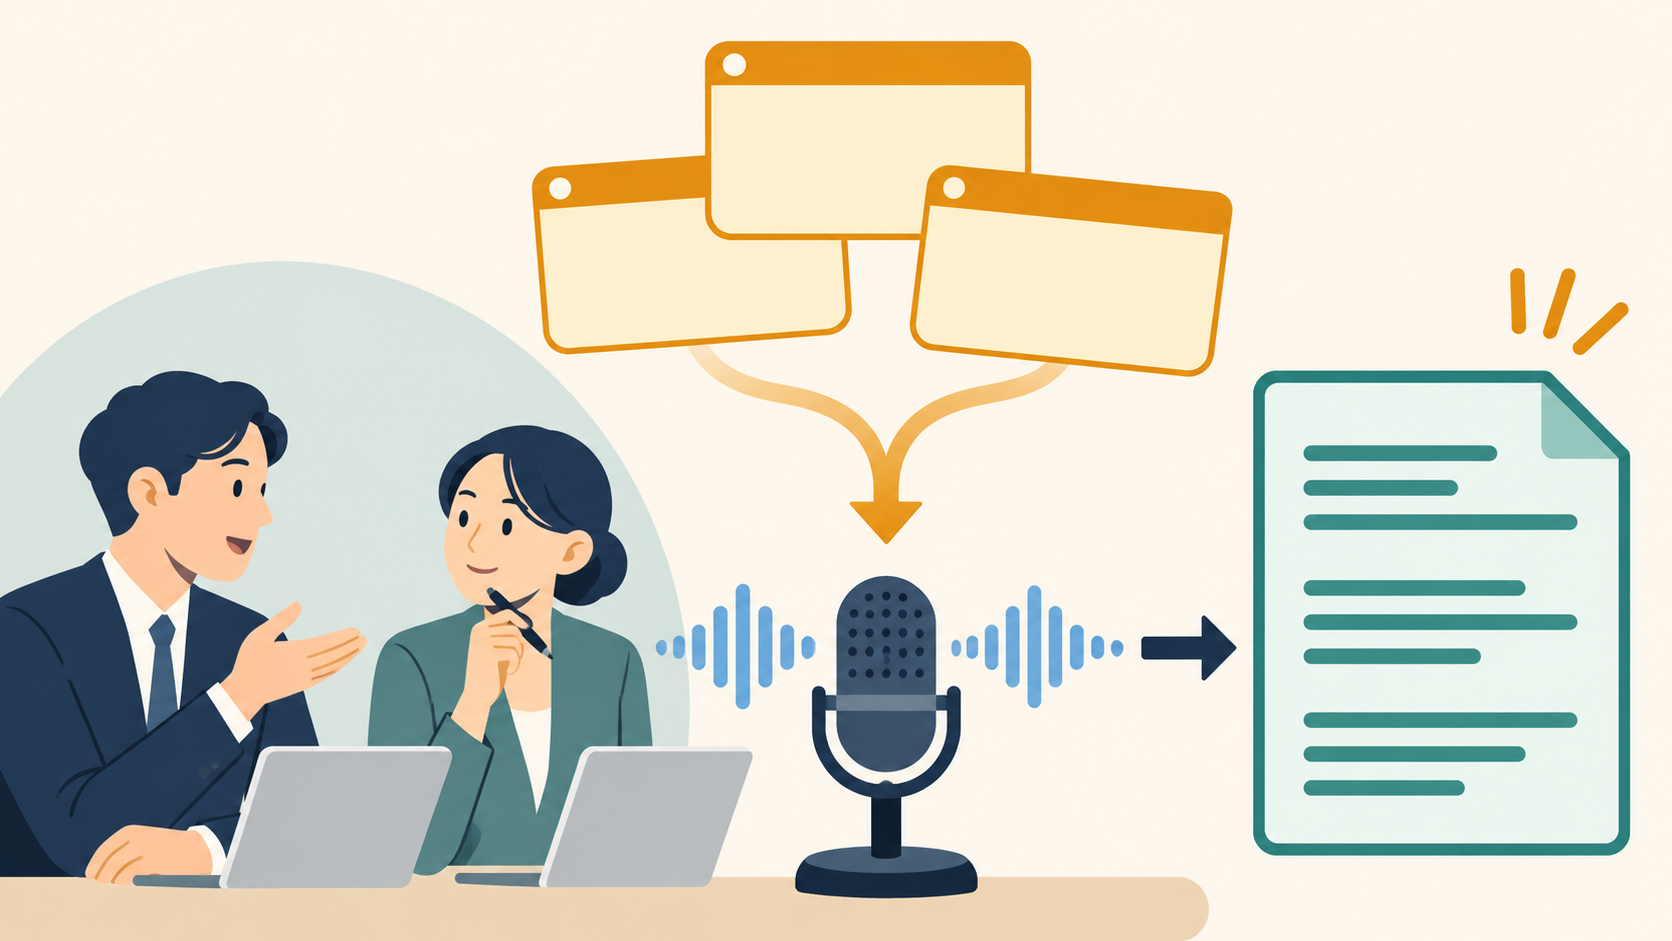
Una transcripción puede ser correcta en casi todo y confundir el código decisivo de un producto. La patente de iFLYTEK y la Universidad de Ciencia y Tecnología de China utiliza términos candidatos para localizar información acústica, y esa información para discriminar los términos.
1. El peso de un código breve
Imaginemos una revisión de prototipos AX-17 y AX-70. Un sufijo equivocado puede llevar al responsable a consultar otro informe de ensayo o a preparar una agenda incorrecta.
El reconocedor suele disponer de más ejemplos de expresiones comunes que de nombres internos. Los sonidos compartidos por ambos códigos no bastan para distinguirlos.
La concesión de la patente europea conjunta EP4156176B1 se publicó el 10 de septiembre de 2025. Describe el uso de un vocabulario contextual durante la conversión de voz a texto.
2. Codificar por separado voz y contexto
El sistema codifica el audio y la lista de términos relevantes por separado. Aquí, hotword designa un término contextual, no necesariamente una palabra de activación.
La lista puede reunir nombres y siglas propios de una reunión. Su presencia en ella no prueba que se hayan pronunciado: sigue haciendo falta evidencia acústica.
Los candidatos intervienen durante la decodificación. No se trata simplemente de sustituir cadenas en una transcripción ya terminada.
3. Dos etapas de atención
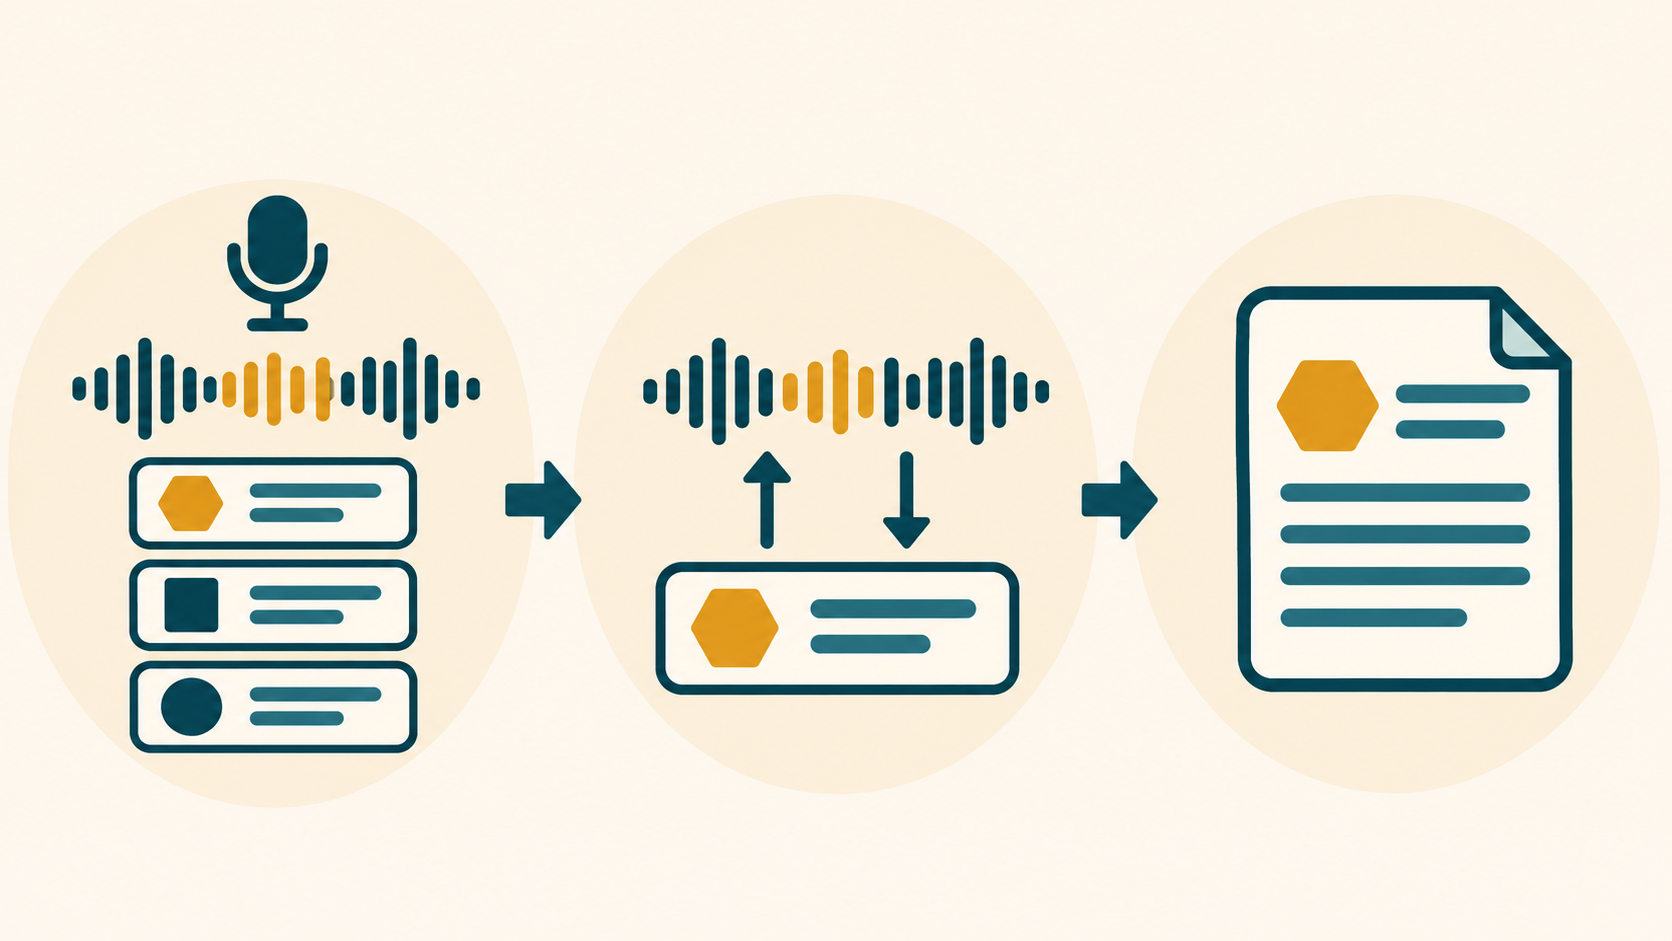
La primera etapa combina la codificación de los términos con el estado del decodificador, que recoge la información previamente decodificada, para obtener la característica acústica pertinente.
La segunda utiliza esa característica para ponderar los términos candidatos. Ambas representaciones se combinan antes de la decodificación y la clasificación.
El clasificador contempla caracteres comunes, candidatos añadidos dinámicamente y el supuesto de que no haya un término de la lista. Registrar una palabra no obliga a insertarla.
4. La comparación entre AX-17 y AX-70
En la reunión hipotética, el sonido compartido AX puede activar ambos candidatos. La terminación acústica y el contexto de decodificación ayudan a diferenciarlos.
La ilustración muestra el intercambio de información entre audio y vocabulario; no comunica una tasa de acierto medida ni confirma la compatibilidad de un servicio comercial con esos códigos.
La evaluación debe incluir palabras corrientes y expresiones ajenas a la lista. Un sesgo excesivo puede introducir un término contextual donde se pronunció otra cosa.
5. Separar patente y producto
La documentación consultada de transcripción en tiempo real de XFYUN limita los términos personalizados del servicio estándar a caracteres chinos en UTF-8, sin cifras ni letras latinas. AX-17 ilustra la patente, no una entrada admitida por ese servicio.
La información oficial de AINOTE 2 describe por separado transcripción, traducción y resúmenes de reuniones. Esa presentación no acredita la ejecución de reivindicaciones concretas de la patente.
Un código erróneo puede propagarse a la traducción o al resumen. La fluidez del texto final no basta para detectar el fallo inicial de identificación.
6. Cómo documentar la diferencia técnica
Conviene delimitar y versionar el vocabulario de cada reunión. Además de la tasa global de error, deben observarse los códigos críticos, las inserciones indebidas y el efecto sobre el lenguaje común.
La descripción técnica debe concretar los codificadores, la entrada del estado del decodificador, el orden de atención y la valoración de candidatos ordinarios y contextuales.
El mecanismo propuesto, las restricciones del servicio y los resultados medidos requieren registros distintos. Comparar el mismo audio con y sin contexto permite explicar qué aporta el procesamiento.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
La reunión y los códigos son hipotéticos; la descripción de un producto no acredita la aplicación de reivindicaciones específicas.
Documentación de transcripción de XFYUN
Información oficial de AINOTE 2
La patente de aprendizaje de Socra AI: distintos errores, distintas preguntas
Poda temprana de NVIDIA: cuándo estabiliza su estructura una red menor
Consulte los proyectos de IA y materiales de preparación de IPLEX sobre reconocimiento de voz y decodificación contextual.
Conozca la experiencia de Yongduck Kim en IA