
本記事では「Deep Residual Learning for Image Recognition(画像認識のための深層残差学習)」を取り上げます。
(本文へ移動)
紙はCVPR 2016で出版され、多くの注目を集めました。 これは、Imagenetの競争でこの論文で提案されたResNetが理由です。
この論文の主な特徴は、ネットワークを深くするために残留学習を使用することです。
理論は、ネットワークをより深くし、データからより豊富な機能が抽出され、性能が高まります。 しかし、典型的なネットワークでは、性能ではなく、レイヤーが実際に深くなるという問題です。 本記事では、残留学習方法を用いて、これらの問題を改善します。
[バックグラウンド]
条件付きニューラルネットワーク(CNN)では、各フィルタは、特定のレイヤーのコンボレーション操作を行い、出力からアクティベーションマップを抽出します。 ここでは、複数のフィルタのそれぞれが異なる特性値を抽出するために訓練されます。
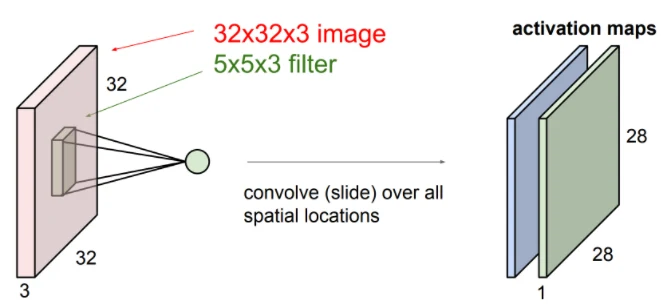
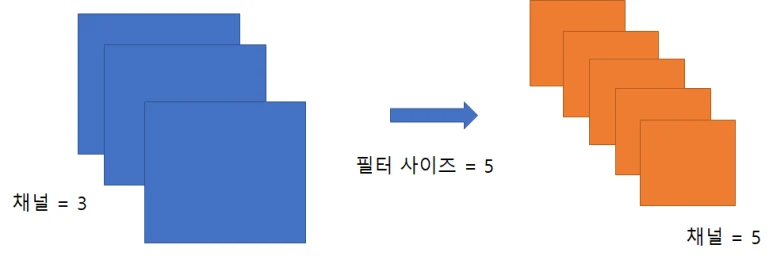
たとえば、3つのチャネルからなる入力値があるとします。 5つのフィルタ(各5つのフィルタを3つの入力チャネルに分割して、コンボリューション操作を実行する)の合計を使用して、コンボリューション操作を実行すると、5つのアクティベーションマップ(異なる特性情報を含む各々)が出力層から引き出されます。 これは、アクティベーションマップの幅と高さが入力値の幅と高さよりも少ないフィルタの数と同じです。 その結果、レイヤーを深くし、出力レイヤーのチャンネルが増え、幅と高さが小さくなります。 入力層にパッドを入れないと、コンボリューション操作を行うと、高さと幅が低下する一般的な現象です。
一方、ResNet の前に Imagenet を獲得した VGG ネットワークは、レイヤーの深さが向上し、小型のフィルタを多く使用しました。
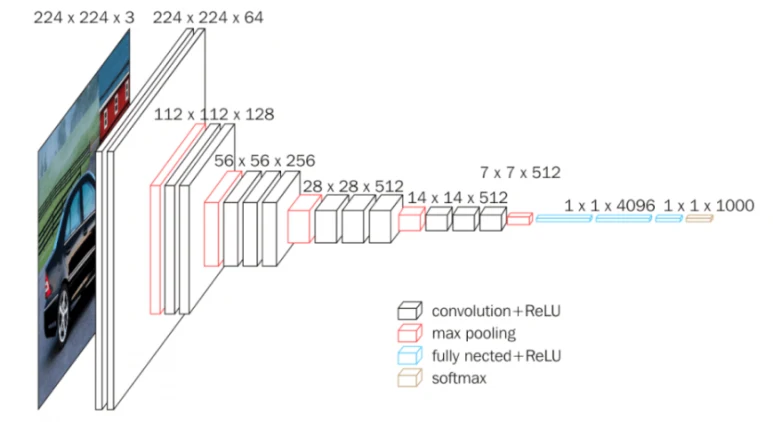
VGGネットワーク
これらのVGGネットワークは、パラメータの数を増やすという欠点を持っていますが、彼らはconvolutionレイヤーを利用しています。 多くのネットワークは、バックボーンネットワークとして使用していますが、単にVGGネットワークのレイヤーを増加させることで、より良いものにしません。 多数のパラメータで固定する必要もあります。 Resnetは、これらの問題を解決するために立ち上がりました。
【記事の主な考え方】
一般的に、レイヤーの奥深さ、モデルの学習難しさが高まり、意図どおりに最適化するのは容易ではありません。
VGGネットワークに基づいて、複雑なニューラルネットワークを構築するだけで、学習が不可能なため、学習作業を行うために、残りのブロックを使用するには、この論文で重要な考えです。 ここには、残りのブロックは1つのネットワークの最適化の難しさを減らす機能を実行します。
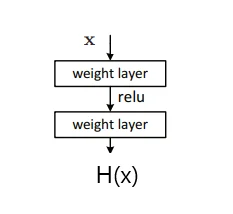
この論文では、実際に学習するための組み込みマッピングはH(x)であり、すぐに学ぶことが難しいと述べています。 そのため、H(x)の代わりにF(x)を学習することは、F(x) = H(x) - xとして再定義されたマッピングでもう少し難しくなります。
* * * * *
より具体的には、x が重みレイヤーなどの重みレイヤーに入ったとき、機能が抽出され、その機能は、relu などの活性化機能を受けます。 ネットワークが構成されると、ネットワーク全体が非線形動作を実行します。 その後、ネットワークは、連続した回帰層の形で構成されます。
各重みレイヤーは別々なので、各重みレイヤーごとにすべての重み値を知る必要があります。 すると強度が増加します。 この層の奥深く、悪くなる。 その結果、理想に機能する関数H(x)を学習することは困難です。
* * * * *
この論文では、よりよく学習されたフォームであるF(x)の機能としてH(x)を使うというコアの考え方を提案しています。 ここで特定の変更はありませんが、finite 値(F(x)の複数のレイヤーに入力値(x)を追加するだけです。
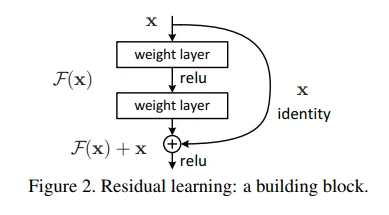
詳細はこちら。 F(x)+xは、以前のレイヤーから学んだ情報(x)を取り、追加情報(F(x))を学習して追加します。つまり、 つまり、xそのままに、まだ学習する必要がある残りの情報を取ると、F(x)+x。(これはH(x)です)教育よりもはるかに簡単です。 このようにネットワークを変更することで、学習がより速く、高いパフォーマンスを発揮することができます。
数学の式を詳細に見れば、まず以下のようにF(x)関数を定義できます。
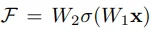
入力値 x が入ると、最初の重み値 (W1) でそれを乗算し、活性化 fuction (relu) を書いて、2番目の重み値 (W2) で結果を乗算します。 これは、F(x) 関数を定義する方法です。 ここにxを追加しています。 最終的な値は、以下のフォームで表現できます。
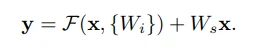
この式を見てみると、重み値が何度も使えるのがわかります。 これは、複数の複雑なレイヤーと呼ばれます。 また、既存の入力値をインポートし、複数のコンボレーションレイヤーに追加するために、ショートカット接続を使用できます。 ここでは、Ws は、線形投影を介して複数の対流層の出力寸法で入力寸法をマッチングする機能を実行します。
この記事は公表時点の情報に基づいています。個別の事情については、当事務所にご相談ください。