
Este artículo se titula “Deep Residual Learning for Image Recognition”.
El periódico fue publicado en CVPR 2016 y atrajo mucha atención. Esto se debe a que ResNet, que se propuso en este documento en la competencia Imagenet.
La característica principal de este trabajo es que utiliza el aprendizaje residual para profundizar la red.
La teoría es que cuanto más profunda sea la red, más ricas características pueden extraerse de los datos, más alto es el rendimiento. Sin embargo, en una red típica, el problema es que la capa en realidad se vuelve demasiado profunda, en lugar de rendimiento. Este artículo mejora estos problemas utilizando un método de aprendizaje residual.
[Background]
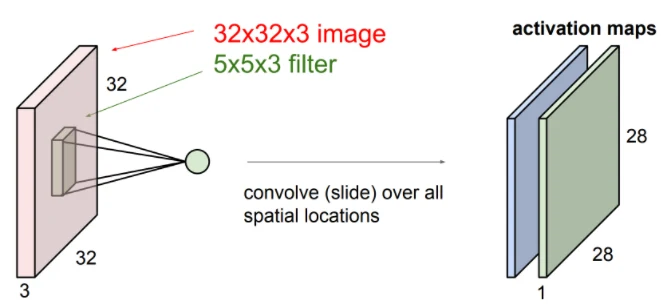
En una Red Neural Convocional (CNN), cada uno de los diferentes filtros realiza una operación convolutiva para una capa dada por entrada, y extrae el mapa de activación de la salida. Aquí, cada uno de los filtros múltiples es entrenado para extraer diferentes valores característicos.
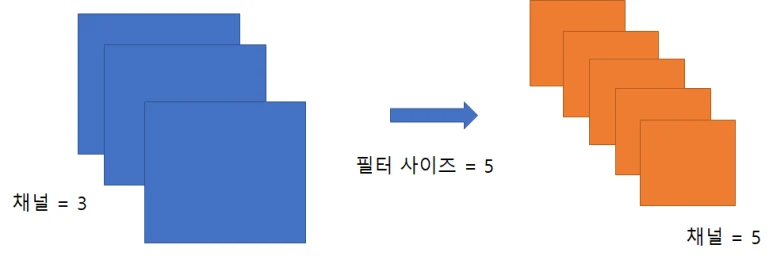
Por ejemplo, suponga que usted tiene un valor de entrada que consiste en tres canales. Si realizas una operación de convolución usando un total de cinco filtros (desgastando cada uno de los cinco filtros en los tres canales de entrada para realizar una operación de convolución), cinco mapas de activación (cada uno que contiene información característica diferente) se sacan de la capa de salida. Esto equivale al número de filtros, donde la anchura y la altura del mapa de activación son inferiores a la anchura y la altura del valor de entrada. Como resultado, cuanto más profunda es la capa, más canales en la capa de salida, y más pequeño el ancho y la altura. Este es un fenómeno común en el que la altura y la anchura se reducen si no se acopla ningún relleno a la capa de entrada al realizar operaciones convocionales.
Mientras tanto, la red VGG, que había ganado Imagenet antes de ResNet, utilizó muchos filtros de tamaño pequeño (3*3 filtros de convolución), lo que aumentó la profundidad de la capa para realizar bien.
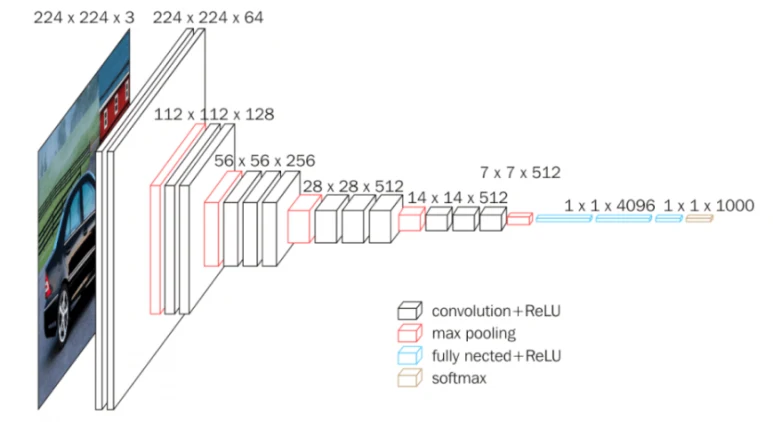
VGG Network
Estas redes VGG tienen la desventaja de aumentar el número de parámetros, pero han aprovechado la capa de convolución. Mientras que muchas redes lo utilizan como red de columna vertebral, simplemente aumentar las capas en la red VGG no lo hace mejor. También debe fijarse debido al gran número de parámetros. Resnet surgió para resolver estos problemas.
[La idea principal del artículo]
En general, cuanto más profunda es la capa, mayor es la dificultad de aprendizaje del modelo, por lo que no es fácil optimizar como se pretende.
Simplemente construir una red neural convocional basada en una red VGG es una idea clave en este trabajo para utilizar bloques residuales para hacer el trabajo de aprendizaje porque el aprendizaje no es posible. Aquí, el bloque restante realiza una función que reduce la dificultad de la optimización para una red.
En este artículo, afirmamos que el mapeo incorporado para aprender realmente es H(x), y argumentamos que es difícil aprenderlo de inmediato. Por lo tanto, se argumenta que aprender F(x) en lugar de H(x) es un poco más difícil por el mapeo redefinido como F(x) = H(x) - x.
* * * * *
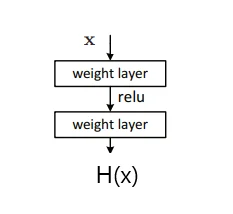
Más específicamente, cuando x se introduce en una capa de peso como una capa de convolución, la característica se extrae, y la característica se somete a una función de activación como un relu. Cuando la red está configurada, toda la red realiza una operación no lineal. La red se configura entonces en forma de una capa de convolución continua.
Puesto que cada capa de peso está separada aquí, es necesario aprender todos los valores de peso por separado para cada capa de peso. Luego aumenta la intensidad. Cuanto más profunda es esta capa, peor se vuelve. Como resultado, es difícil aprender una función H(x) que funciona idealmente.
* * * * *
Este artículo propone la idea básica de usar H(x) como una función de F(x), que es una forma más bien aprendida. No hay ningún cambio particular aquí, sólo la adición del valor de entrada (x) a las múltiples capas del valor finito (F(x).
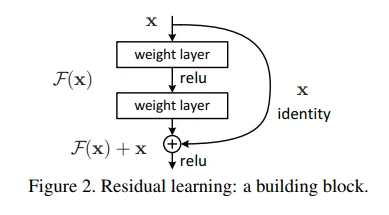
Toma. F(x)+x va a tomar la información (x) que hemos aprendido de la capa anterior, y vamos a añadirla a ella aprendiendo la información adicional, F(x).Quiero decir eso. Eso es, xSi lo tomas como es, y tomas la información restante que todavía necesitas aprender, F(x)+x.(Esto es H(x))Esto es mucho más fácil que enseñar. Al cambiar la red de esta manera, el aprendizaje puede ser más rápido y más alto rendimiento.
Si miramos la fórmula matemática en más detalle, primero podemos definir la función F(x) como sigue:
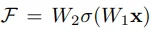
Cuando el valor de entrada x entra, multiplicalo por el primer valor de peso (W1), escribe la fucción de activación (relu), y multiplica el resultado por el segundo valor de peso (W2). Así se define la función F(x). Añadimos x aquí. El valor final se puede expresar en el siguiente formulario.
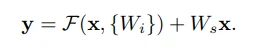
Si miras esta fórmula, puedes ver que el valor de peso se puede utilizar muchas veces, no solo dos veces. Esto se llama múltiples capas convolutivas. Además, podemos utilizar una conexión atajo para importar los valores de entrada existentes y añadirlos a las múltiples capas convolutivas. Aquí, Ws realiza la función de igualar la dimensión de entrada con la dimensión de salida de múltiples capas convolutivas a través de proyección lineal.
Este artículo del archivo refleja la situación en su fecha de publicación. Contacte con el despacho para analizar su caso.