
StarGAN:複数ドメイン間の画像変換のための統合型敵対的生成ネットワーク
本稿では、マルチドメインでの翻訳が可能なStarGANネットワークを提案しています。
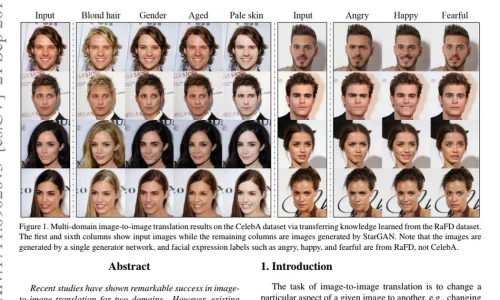
画像をクリックすると、テキスト全体が表示されます。
【内容概要】
CycleGANやIcGANなどの非StarGANネットワークでは、1つのドメインから別のドメインへのドメイン翻訳を行うため、複数のネットワークをネストする必要があります。 以下の例からご覧いただくと、スキルは良くありません。
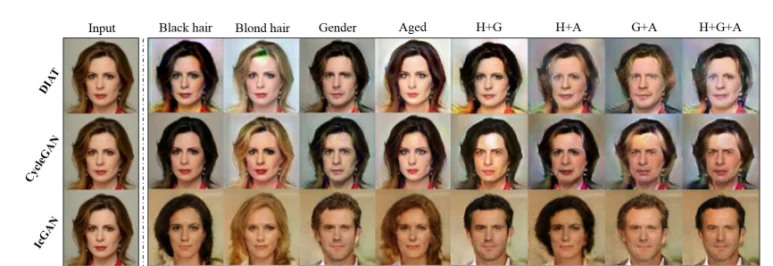
しかし... StarGANは複数の属性を一度に1つのネットワークのみで翻訳できます。
入力画像(クラス1)は古いです、2)は茶色の髪があり、3)は他のドメインイメージに翻訳するためにStarGANに分類されますので、他のネットワークよりもドメインの翻訳が優れていることがわかります。
簡単に言えば、StarGANは若いブロンドの女性のイメージです。(入力)古い黒髪の男にどのように変化するかを見ることができます。 (H+G+A)
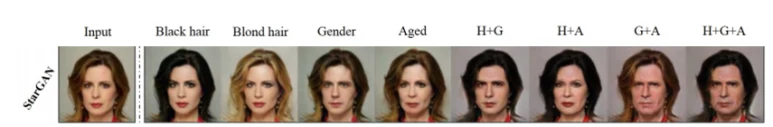
StarGAN の例
[バックグラウンド技術の説明]
モデリング(生成モデル)
創造モデルとは、存在しないモデルを指しますが、存在する可能性のあるイメージを作成します。 作成モデルが作成できるデータはイメージだけでなく、様々なデータ(例)です。 テキサス州のデータをデータ化できます。 ただし、画像データを生成する生成モデルに関する研究は、他のデータよりも最も有効です。
差別化モデルと生成モデルは以下の通りです。
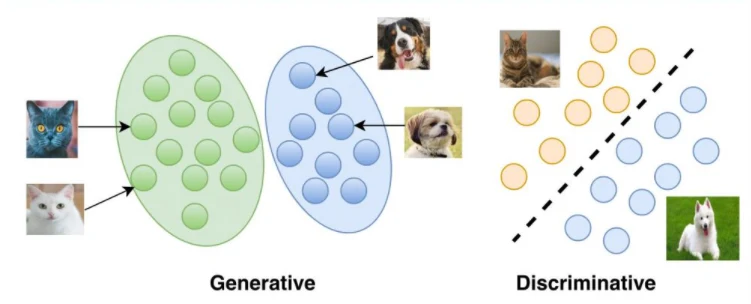
生成モデルと差別モデル
差別化されたモデルは、既存のデータ間での決定境界を学び、1つのデータが入ってくるときにデータがどのクラスにあるかを分類します。私はそれをします。
平均時間では、 生成モデルは、既存のデータから分布を学び、学習した分布、すなわち実際のデータ分布に従う。(リアルタイムデータ)プリントするモデル。汎用モデルは、共同確率分布を学習するために使用することができます。
たとえば、鼻の大きさや目の大きさに関連した機能に関連した機能があるとします。 人のイメージを身につけると、通常の鼻の大きさと通常の目の大きさが決定されます。 鼻径10cmの典型的な鼻径を想定し、鼻径10cmの確率値が最高です。 3cmの通常の目の大きさを想定し、3cmの目の大きさの確率値が最高になります。 したがって、各機能の最も可能性が高い機能値(10 cmの鼻の大きさと3 cmの目の大きさ)を使用して画像の生成は、実際の人物のように見える画像になります。
結果として、 世代モデルは、既存の学習データが持っている、つまり、ユニークな分布を実際の分布を学習します。
作成モデルを訓練するための最も一般的に使用されるアーキテクチャは、Generative Adversarial Networks(GAN)です。
GAN: ジェネレーション・アドバーサリアネットワーク
前の投稿では、ガンスについて書いていますが、今回は詳しく解説します。 【ガンポスト】
GAN は、発電機と分担器を 2 つのネットワークで利用します。です。 ガンで発電機の学習が完了すると、発電機に1つのノイズを入力することで提示できるイメージを作成することができます。
具体的には、ジェネレーターは 1 つのデータインスタンス (fake data) を 1 つのレイト ン ベクトルが入力されたときに作成することができます。 Discriminator は、単一のデータインスタンスが入っているときに、このデータが実質的な分布(実質的または偽物)に従うかどうかを示す確率を出力します。全て。
学習プロセスでは、ジェネレータによって生成されるデータインスタンス(偽像)がディスクリミネーターで実際の画像であることを決定できるように、ジェネレータは学習を実行します。
一方、学習プロセスでは、ジェネレータが生成したデータインスタンス(偽像)が実際の分布に従わないこと、実際の画像(実画像)が実際の画像を決定するために教えられます。
ここで重要なことは、 ジェネレータ出力が出力されるデータインスタンスは、実際のディストリビューションに従うようにします。
条件付きガン(cGAN)
通常、GAN を作成すると、新しいイメージを作成するためにレイト・ベクターを変更できます。 ただし、レイトンベクトルのみ変更することで、ガンを使用して意図した画像を作成することは困難です。
そのため、ガン内で別の条件情報を入力することができるcGANです。 つまり、 cGAN は GAN を調節しました。
cGANモデルのオブジェクト関数を見てみると、y 値が GAN と同じオブジェクト関数に新しい条件式を入力することがわかります。
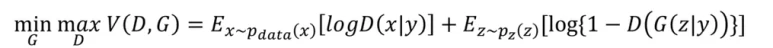
*****
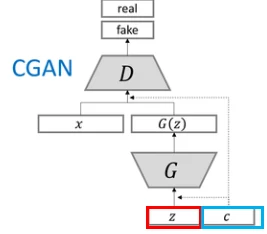
下記の写真をご覧ください。 z(定性ベクトル) 価値 c(条件ベクトル) ジェネレータ(G)に値が入力されていることがわかります。 詳細はこちら。 c 値は、クラスがデータを生成するラベル情報です。可能です。 ジェネレータは z と c を一緒に入力し、そのクラス(c) の対応するデータを作成します。
*****
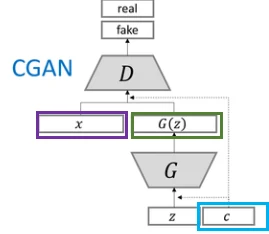
ジェネレーターによって生成される。 偽データ(G(z)))ディスクリミネーター(D)を入力してください。 C 値c の対応するラベルを使って。 実際のデータ(x)一緒に入れましょう。 この構造でネットワークを学習する際には、特定のクラスに適したデータを作成するために、cGANs が訓練されます。
Pix2pixの特長
Image to Image の翻訳は、特定の画像から特定の側面を選択し、特定の画像が存在するときに他の機能と置き換えるというタスクを実行することです。つまり、 と... 画像翻訳アーキテクチャへのイメージそこに行く。
Pix2pixは学習プロセスの条件としてイメージを書き入れるcGANの一種です。 cGANはラベル値を持っていますが、pix2pixはイメージを持っています。 つまり、偽物画像を作成すると、特定の条件に従う画像を作成します。
例えば、輪郭だけを持っている手描きの絵(x)を持っていると、実際の画像(G(x))に変更したいとすれば、輪郭だけを持っている手描きの画像(x)はここに条件です。 ここで、pix2pixは、手描き図(x)が挿したときに輪郭の内部を埋める学習の形態です。
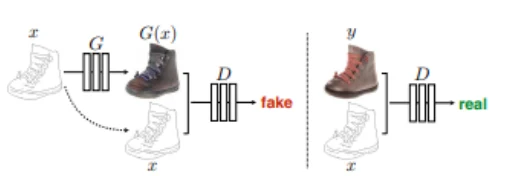
Pix2pix では、2 つの異なるドメイン X と Y のデータをペアリングすることで学習できます。なるほど。 この場合、この画像から色を抽出することによって生成された色付きの画像(既存の画像)と画像のペアは、トレーニングデータセットを作成します。 電車に使うこともできます。
しかし... トレーニングデータのペアを作成することは、多くの場合困難です。 たとえば、直接撮影した画像を入力することで、風景を作成するタスクにセットされたトレーニングデータを用意しているとします。 撮影した画像や対応する風景が見つからず、ペアリングするのは簡単ではありません。 撮影した画像を使って風景を作ることも困難です。 トレーニングデータセット(実際に作ることができるが、時間がかかり、費用もかかる)を作成するのは困難です。 つまり、 この点ではPix2pixに制限があります。
cGANの制限
タスク中に特定のイメージを使用して、cGAN を使用して zebra 画像を zebra に変えるだけです。
しかし... cGAN が上記のタスクを続行するために学んだ場合、cGAN は、以前に作成した zebra イメージだけを出力する問題があるかもしれませんが、他のスピーチ画像が入力された場合でも。
Discriminator では、以前作成した zebra イメージが実際に存在し、特定のクラスに分類される可能性があるため、出力のみになります。 つまり、インプットイメージのアイデンティティを追うことなく、特定のドメインに対応するイメージを作成することで、ジェネレーターを操作できます。
サイクルガン
CycleGANは、cGANの制限を解決するモデルです。です。 CycleGANは、ジェネレータが作成した偽物画像を元の画像に戻すことができます。
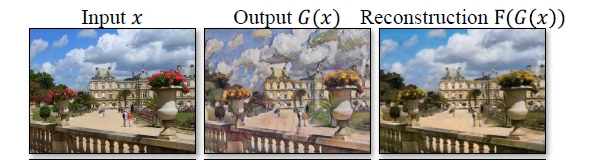
入力イメージ(x)がある場合、偽のイメージ(G(x)を作成し、偽の画像に逆関数を作成し、元の画像に戻します。
言い換えると、元の入力イメージに似て1つのインバースマッピングが作成され、偽の画像は学習する損失の形で元の画像に戻ります。 これにより、ドメイン(スタイル)に関連付けられている特性だけを変更するために学習される元の画像のコンテンツについての情報が可能になります。 サイクル一貫性の損失と呼ばれます。
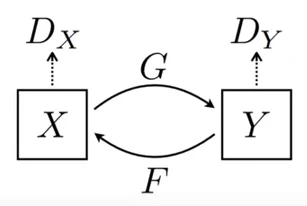
これらのタスクを実行するには、2つの翻訳者が使われます。
一つはXからYへの変換を実行する発電機です。 (G:X→Y)
一方は Y から X に再び変換する反転マッピングを実行する関数です。 (F:Y→X)
その結果、CycleGANはF(G(X))をXのように見せるように訓練され、G(F(Y)はYのように見える。
WGAN-GP
WGANは機能が1-Lipshichtzの状態に会うことを、安定した学習に導くことを保障します。 しかし、WGAN は重みのクリッピングを使用して、制約を満たしています。 そのため、他の問題を引き起こす可能性があります。 WGAN-GPは、WGANのパフォーマンスを向上させるために、WGANへの勾配ペナルティの追加によって特徴付けられます。
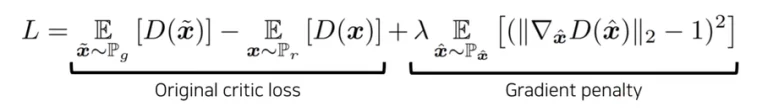
スターガン
背景技術で説明したアーキテクチャを使用する場合、複数のネットワークは、ドメインを複数のドメインごとに画像に変換する必要があります。 しかし... スターガン 1つのモデル複数のドメインの画像変換を実行するために使用します。.. . この場合、複数のネットワークを使用しないため、パラメータの面でスペース効率が良いと考えられています。多くの異なるドメインで使用されるデータセットと一緒に使用できるため、一般的な機能を学ぶことができるので、パフォーマンスを向上させることができます。 スターガンが使用したのがこの考え方です。
*****
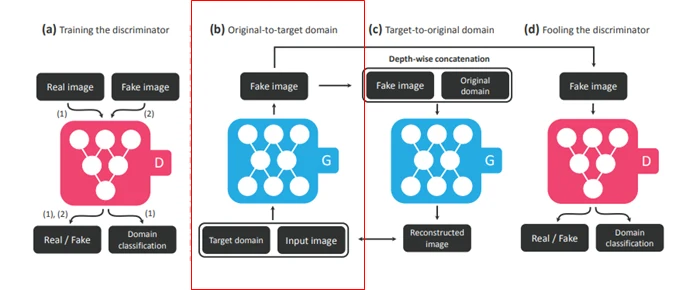
まず、ジェネレータは、入力イメージとターゲットドメインのベクトル値を入力すると、入力イメージが対象ドメインに変更された偽のイメージを作成できます。
*****
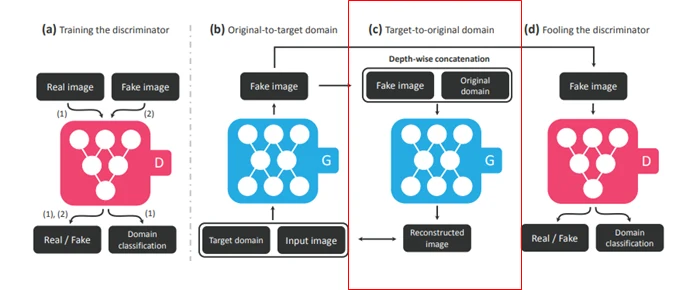
偽のイメージは元のドメインにバインドされ、元のイメージと同じ形でイメージが表示されるように発電機に入ります。 これにより、再構築されたイメージを作成できます。 したがって、ネットワークをサイクルで設定することで、入力イメージのアイデンティティが維持され、ドメイン関連情報のみが変更できます。
*****
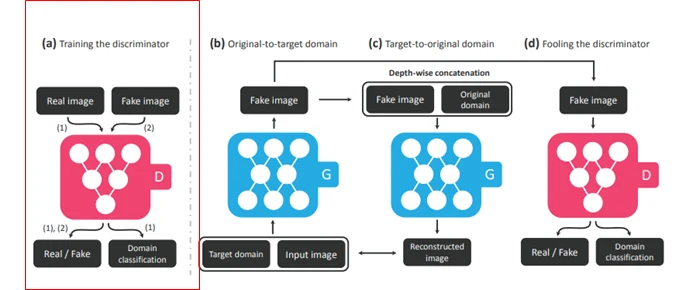
一方、Discriminatorは実際のイメージを実際のところ分割し、偽物のイメージを偽物に分けることを引き起こします。 また、Disciminatorは、実際の画像が入力されたときにドメインクラスに関する情報の出力を可能にします。
発電機のために、発電機が適したイメージを作成することができるように偽のイメージが付いている差別化器を作ることができます。
cGANにサイクル・コンシスタンス・ロスを加え、複数のドメインで動作できるようにする発電機のパフォーマンスを増加させるスターガンです。
StarGANのROS値は、Adversarial損失、ドメイン分類損失、および再構築損失のプラスです。
*****
対価損失は同じです。
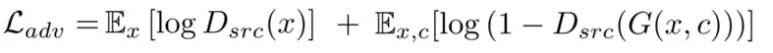
Adversarial損失は、デフォルトのガンの損失を特定のドメイン(c)に変更する概念を追加します。 Adversarial損失の場合、WGAN-GPの考え方は、ペナルティが与えられた形で損失値を構築するために使用することができます。
*****
ドメイン分類損失は以下のとおりです。
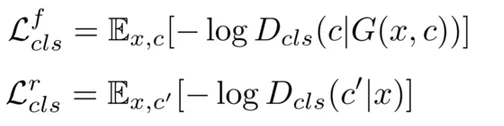
偽の画像のドメイン分類損失はジェネレータに使用され、特定のドメインに画像が特定のドメインに分類できるように学習が行われます。
実際の画像のドメイン分類損失は、ディスクリミネーターに使用され、入力したときに実際の画像の領域値(c)として実際の画像を分類するために学習が行われます。
*****
再建損失は次です。
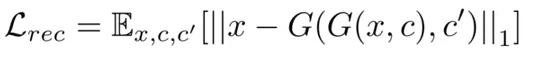
復元損失は、ジェネレータによって生成された画像が翻訳プロセス中に元の画像のコンテンツを保持できるように、サイクルの一貫性の損失を使用しています。 それから、元のイメージに復元するときは、実際の元のデータと最終変換されたデータが似ているように、再構築損失を構成します。
*****
最終目標は以下の通りです。
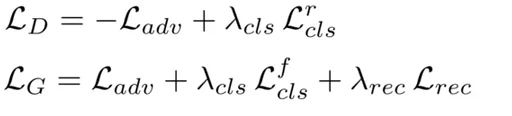
差別化要因の目的機能は、マイナスを追加することにより、逆転損失を最小限に抑えることです。これは、逆転損失自体を最大化することを意味します。 これは、実際の画像のドメイン分類損失を追加することによって行われます。
ジェネレータのオブジェクト関数を見てみると、各イメージが実際のイメージとして分類できるように、広告主の損失値を最小限に抑えることがわかります。 偽物画像のドメイン分類損失と再構築損失を追加します。
*****
ハニバル マスクベクターを使用して複数のデータセットで学習を進めるなるほど。 マスクベクターはラベルのマスクです。
ヘアカラー(マニーポジティブ)に関連付けられたラベルと、感情(プラス)に関連するラベルが設定されているデータがある場合、それは髪色、感情に関連付けられているラベル、およびマスクベクトルを連結する方法で使用されます。
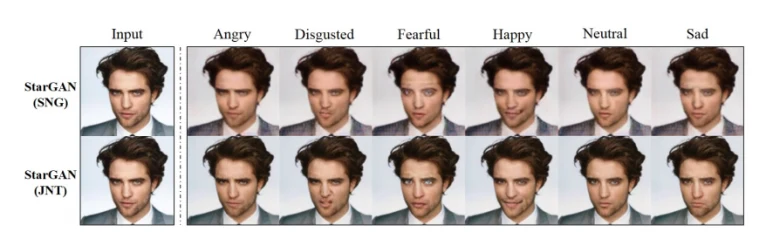
感情に関連したラベルを持つデータ(SNG)のみが使用される場合、データセットの量が小さいため、学習が適切に行われず、パフォーマンスが低下します。 (スターガン(SNG))
しかし、複数のデータセット(JNT)を使用して、マスクベクターとして使用するラベルを決定する場合、感情に関連したラベルのデータセットや、ヘアカラーのデータセット(より多くの人の顔に含まれているより多くの感情情報を使用して)を使用しているため、学習を実行できます。 (StarGAN(JNT)) この結果は、学習のために使用されるデータ集計回数の増加に増加し、パフォーマンスの増加をもたらします。
より具体的にリキャップしましょう。
*****
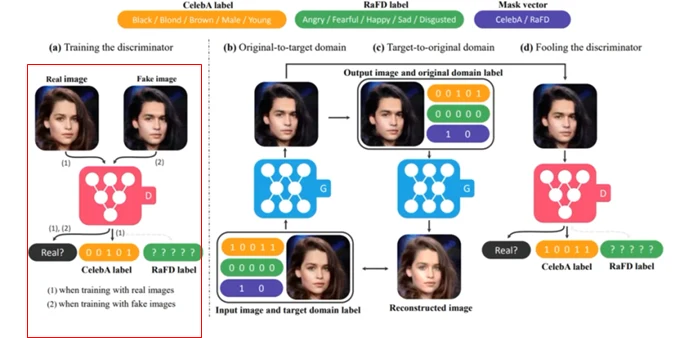
データセット全体。
ディスクリミネーターは、実際の画像が入力されたときにラベルが何であるかを学習します。 一方、差別化者は偽物画像を入力すると、偽物の画像に偽物を印刷し、ラベル値を使用しないことを学びます。
*****
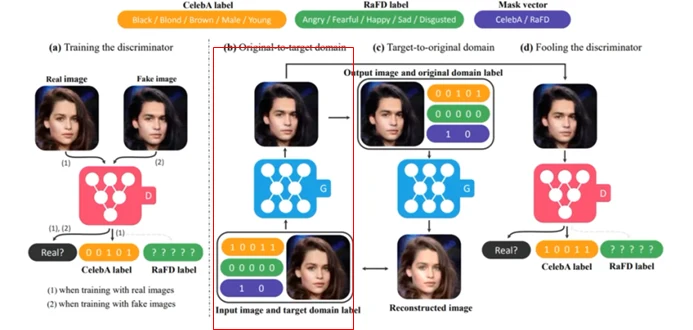
ジェネレータは、 celebA ラベル値 (1 0 0 1 1)、 RaFD ラベル値 (0 0 0 0 0 0 0 0 0 )、 マスク ベクター値 ( 1 0 ) を入力イメージで連結します。 ここでは、マスクベクター値(1 0)は、最初のラベル、celebAラベルのみが使用されることを意味します。 celebAラベル(1 0 0 1 1)の解釈は、「黒髪、男性、女性」を意味することができます。したがって、左ジェネレータの出力は、入力イメージに類似した外観で黒い頭の若い男性の画像の出力を示しています。
*****
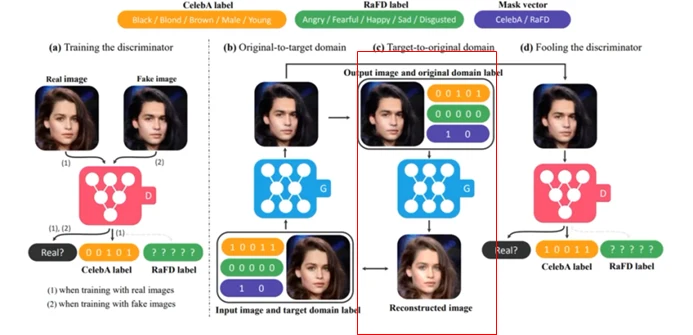
その後、偽の画像が作成されると、元の画像に関する情報、すなわち、celebAラベル値(0 0 1 0 1)、 RaFD ラベル値(0 0 0 0 0 0 0 0 0)、マスクベクトル値(1 0 )が偽の画像で正しいジェネレータに連結されます。 celebAラベル(0 0 1 0 1)の解釈は、「茶色の髪、女性、子供」を意味することができます。したがって、正しいジェネレータの出力は、元の画像に似た再構成イメージが再び表示されることを可能にします。
*****
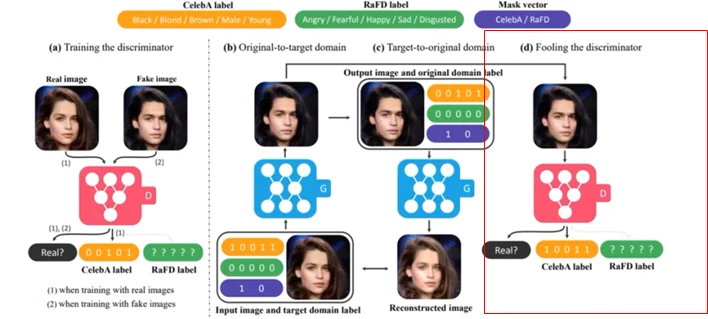
最後に、ジェネレータによって生成された偽物画像は、ディスクリミネーターに入力されると、意図したターゲットドメインとして分類できるように、実際のところ分割されます。 そのため、対象ドメインに翻訳された出力を作成するときに、顔のコンテンツ、すなわちアイデンティティが維持できます。
この記事は公表時点の情報に基づいています。個別の事情については、当事務所にご相談ください。