
この投稿では、ディープラーニングモデルに使用できる2つのテクニックがあります。1. ミックスアップトレーニングと2. このスモックのことを説明しましょう。
画像をクリックすると、テキスト全体が表示されます。
1) 混合の訓練および2) このペーパーで記述されるLableの滑らかになることは深い学習の建築を変えることなく深い学習の性能を改善できます。.
【Mixup Training】
Mixup Training は複数の学習データから2つのサンプルデータをランダムに抽出し、新しい学習データを作成します。 データ拡張に関する技術です。
猫と犬の画像分類タスクたとえば、より具体的にするには、以下を参照してください。
学習用猫画像データは「このイメージは猫」ラベル(例)です。 [0,1] を添付し、トレーニング中の犬画像データが「この画像は犬」ラベル(例)です。 [1, 0] が、この方法で学習データをラベル付けすることが一般的です。
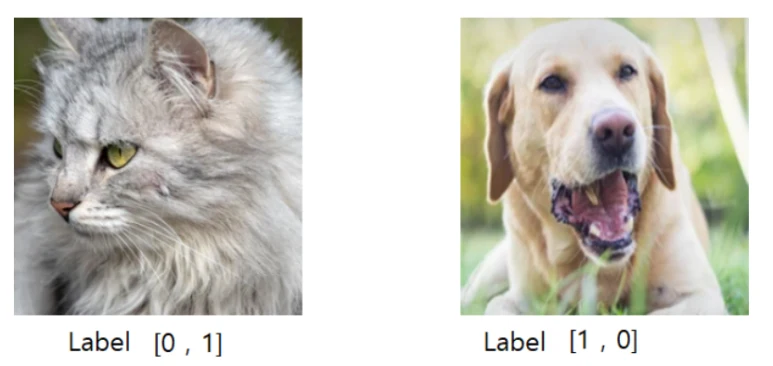
学習データをラベル付けする一般的な方法
ミックスアップトレーニング上記の方法を使用して、 学習のための2つのサンプルを結びつける方法です。
各犬と猫の学習データをペアで混合した後は、実際に学習データとしてmixupデータを使うための混合訓練です。
ミックスアップのトレーニングを実行すると、2つの画像をミックスするだけでなく、ラベルをミックスすることもできます。やってみよう。 詳細はこちら。 lamdaは2つの画像が混在する価値です。です。 lamba 値が 0.5 に設定されている確率は低く、特定のイメージが一般的により大きな割合を占めるように学習データを構成できます。 β分布では、ラムダ値がランダムに使用されます。やってみよう。
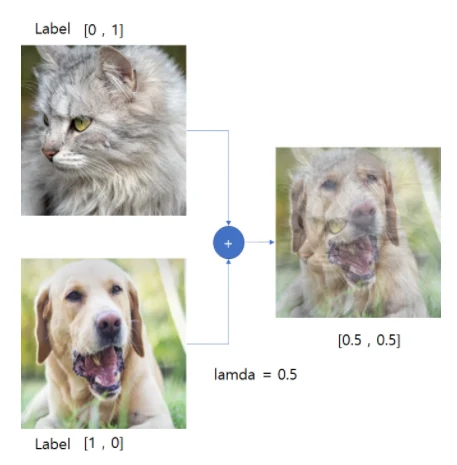
ミックスアップトレーニング
上記の例から見ることができるように、2つの学習画像は半分に混合され、少し厄介に見えるかもしれません。 しかし、犬の目では、このイメージは「猫と犬」と表示されています(例)。 [0.5, 0.5] 学習します。 過度の苦難を避けるこれを行うことができます。 データの観点だけでなく、 学習データが増えるにつれて、パフォーマンスが向上します。
[ラベルスムース]
ラベルスムースとは、ラベルのスムースを施すことで、一般化のパフォーマンスを向上させる技術です。 Mixupのトレーニングと大きな違いは、トレーニングイメージを変えずにラベルだけを滑らかにするということです。
具体的には、複数の画像データシートと3つのクラスがあるとしましょう。
犬が撮った画像データが画像データの場合、犬のクラスに1の確率値と0のクラスの残りの値を与えることは一般的です。これは、ハードラベルメソッドと呼ばれます。
| 犬の犬 | カレンダー | 新年のご挨拶 | |
| 画像データ 1 | 1 | 0 | 0 |
| 画像データ2 | 0 | 1 | 0 |
| 画像データ 3 | 1 | 0 | 0 |
「ハードラベル」
一方、画像データが犬によって撮影された画像データの場合、犬のクラスは1、残りのクラス0を与えません。 正しいクラス以外のクラスに特定の確率値を与えるため。ソフトラベルと呼ばれます。
| 犬の犬 | カレンダー | 新年のご挨拶 | |
| 画像データ 1 | 0.9 | 0.05 | 0.05 |
| 画像データ2 | 0.05 | 0.9 | 0.05 |
| 画像データ 3 | 0.9 | 0.05 | 0.05 |
「ラベルスムース」タグ付きの投稿
ラベルのスムース法により、画像が与えられたとき、画像が不信を犯すことなく、画像が正規化効果を楽しむことができます。また、一般的に本人自身でデータラベル作成が行われるため、本人が誤ってラベルを付けるデータがある場合があります。 この場合、特定のデータに対して特定のクラスで高い自信を持たせると、さまざまな問題が発生する可能性があります。 この辺で。 ラベルのスムースなトレーニングラベルをラベル化して、一般化を改善します。です。
混合の訓練およびラベルの喫煙はモデルが自信がないことを確かめるのに類似しています。
この記事は公表時点の情報に基づいています。個別の事情については、当事務所にご相談ください。