본 포스팅에서 분석할 논문은 "Deep Residual Learning for Image Recognition"이다.
(논문 링크)
이 논문은 CVPR 2016에서 발표된 논문으로 발표 당시 많은 이목을 끌었다. 이미지 분류 대회인 Imagenet 대회에서 본 논문에서 제안한 ResNet이 우승했기 때문이다.
본 논문에서 제안하는 내용의 가장 큰 특징은 네트워크를 깊게 만들기 위해 잔여 학습(residual learning)을 이용했다는 것이다.
네트워크가 깊어지면 깊어질수록 더욱 풍부한 특징들을 데이터로부터 뽑아낼 수 있어 더 높은 성능을 가질 수 있다는 것이 이론이다. 하지만, 일반적인 네트워크에서는 실제로 레이어가 너무 깊어지면 오히려 성능이 떨어지는 문제가 발생하는데 대표적인 문제는 vanishing gradients 문제이다. 본 논문은 잔여 학습을 이용해서 이러한 문제를 개선했다.
[등장배경]
컨벌루션 뉴럴 네트워크(Convolutional Neural Network, CNN)에서는 각각의 서로 다른 복수의 필터가 입력으로 주어진 레이어에 대해서 특정한 영역 별로 컨벌루션 연산을 진행해서 액티베이션 맵(activation map)을 출력으로 뽑아낸다. 여기서, 복수의 필터들 각각은 서로 다른 특징 값을 추출할 수 있도록 학습된다.
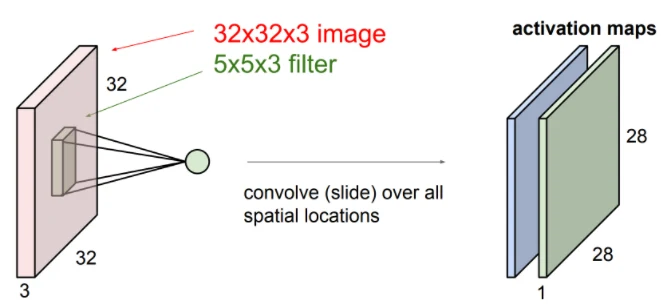
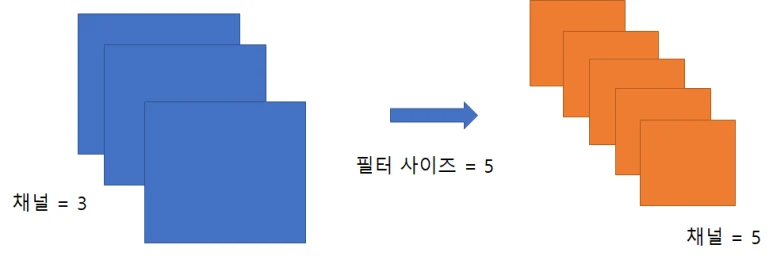
예를 들어, 3개의 채널로 구성된 입력 값이 있다고 가정해보자. 이를 총 5개의 필터를 이용해서 컨볼루션 연산을 수행(3개의 입력 채널에 5개의 필터 각각을 슬라이딩시키면서 컨벌루션 연산을 수행)하면, 아웃풋 레이어로 5개의 액티베이션 맵(각각이 서로 다른 특징 정보를 포함하고 있음)이 뽑아진다. 이는 필터의 개수와 동일한데 여기서, 액티베이션 맵의 너비와 높이는 입력 값의 너비와 높이보다 작아지게 된다. 결과적으로 CNN에서 레이어가 깊어질수록 출력 레이어에서의 채널의 수가 많아지게 되고, 너비와 높이는 줄어들게 되는 것이다. 이는 컨벌루션 연산 수행 시 입력 레이어에 별도의 패딩(padding)을 붙이지 않으면 높이와 너비가 줄어드는 일반적인 현상이다.
한편, ResNet 이전에 Imagenet 대회에서 우승했던 VGG 네트워크는 작은 크기의 필터(3*3 컨볼루션 필터)를 많이 사용하면서 레이어의 깊이를 늘려 우수한 성능을 보였다.
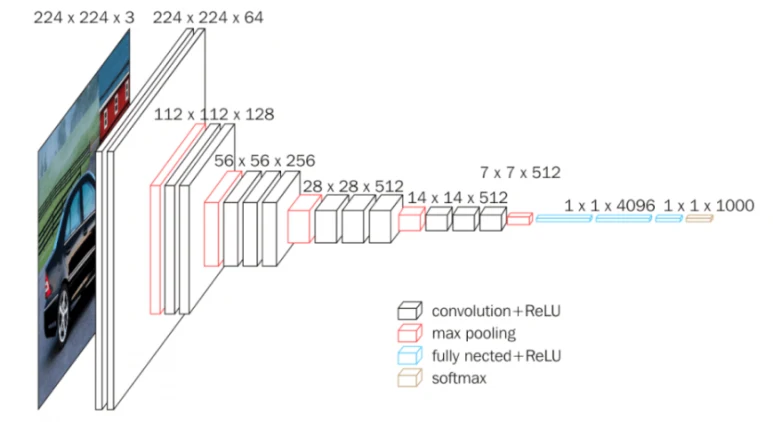
VGG 네트워크
이러한 VGG 네트워크는 파라미터의 개수가 많아진다는 단점이 있지만 컨벌루션 레이어의 장점을 잘 살렸다. 많은 네트워크에서 backbone 네트워크로 많이 활용하고 있지만 VGG 네트워크에서 레이어를 단순히 증가시킨다고 성능이 더 좋아지는 것은 아니다. 또한 파라미터 수가 많아지기 때문에 이를 해결할 필요가 있었다. 이러한 문제점들을 해결하기 위해서 ResNet이 등장했다.
[본 논문의 핵심 아이디어]
일반적으로 레이어가 깊어질수록 모델의 학습 난이도가 높아지기 때문에 의도한 대로 최적화를 시키는 것이 쉽지 않다고 본 논문에서 주장하고 있다.
VGG 네트워크를 기반으로 하는 컨벌루션 뉴럴 네트워크를 단순히 깊게 쌓는 것만으로는 학습이 잘 이루어지지 않기 때문에 학습이 잘 될 수 있도록 잔여 블록을 사용하겠다는 것이 본 논문의 핵심 아이디어이다. 여기서, 잔여 블록은 하나의 네트워크에 대해서 최적화(optimization) 난이도를 낮추어주는 기능을 수행한다.
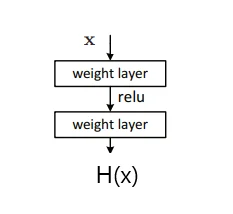
본 논문에서는 실제로 학습을 하고자 하는 내재된 mapping을 H(x)라고 명시하고, 이를 바로 학습하는 것은 어렵다고 주장한다. 따라서, 조금 더 학습하기 쉬운 mapping을 F(x) = H(x) - x로 새롭게 정의해서 H(x) 대신에 F(x)를 학습을 시키는 것이 조금 더 난이도가 쉽다고 주장하고 있다.
* * * * *
좀 더 구체적으로 살펴보면, 일반적으로 x가 convolution layer와 같은 weight layer에 입력되면 특징이 추출되고, 특징이 relu와 같은 activation 함수를 거치게 된다. 이렇게 네트워크가 구성되면 전체 네트워크가 non-linear 한 동작을 수행한다. 그 다음 이어서 연속적으로 convolution layer를 거치는 형태로 네트워크를 구성하게 되는 것이다.
여기서 각각의 weight layer가 분리되어 있기 때문에 각각의 weight layer에 대해서 가중치 값들을 개별적으로 모두 학습 시킬 필요가 있다. 따라서 수렴 난이도가 높아지게 된다. 이런 현상은 레이어가 깊어질수록 더 심하게 발생하게 된다. 결과적으로 이상적으로 동작하는 함수 H(x)를 학습시키는 것은 어렵다.
* * * * *
본 논문은 H(x)를 좀 더 학습이 잘 되는 형태인 함수 F(x)로 변경해서 이용하자는 것을 핵심 아이디어로 제안하고 있다. 여기서 특별히 달라진 점은 없고 인풋 값(x)을 레이어를 여러 번 거친 결괏값(F(x))에 단순히 더해주는 것만 추가되었다.
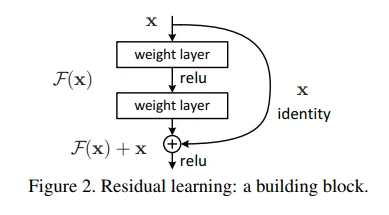
여기서, F(x)+x는 앞선 레이어에서 학습된 정보(x)를 그대로 가져오고 거기에 추가적으로 필요한 정보인 F(x)만 학습을 진행해서 더해주겠다는 것을 의미한다. 즉, x는 그대로 가져오고 아직 학습이 필요한 남아있는 잔여한 정보인 F(x)만 추가적으로 학습할 수 있는 형태로 만들어주면 F(x)만 추가적으로 학습시키면 되기 때문에 F(x)+x(이는 H(x)를 의미함)를 학습시키는 것보다 훨씬 쉽다는 것이 본 논문에서 주장하는 바이다. 이런 식으로 네트워크를 바꿨을 때 학습이 더 빨라지고 더 높은 성능을 낼 수 있다고 기재되어 있다.
좀 더 자세히 수학식을 보면서 살펴보면, 먼저 F(x) 함수는 다음과 같이 정의할 수 있다.
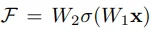
입력 값 x가 들어왔을 때 첫 번째 웨이트 값(W1)을 곱해주고, activation fuction(relu)를 씌워주고, 그 결과에 두 번째 웨이트 값(W2)을 곱해줍니다. 이렇게 F(x) 함수가 정의된다. 여기에 추가적으로 x가 더해집니다. 최종 결괏값은 아래와 같은 수식으로 표현될 수 있다.
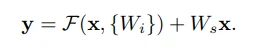
이 수식을 보면 웨이트 값을 단순히 2번만 쓰는 것이 아니라 여러 번 사용할 수 있다는 것을 확인할 수 있다. 본 논문에서는 이를 multiple convolutional layers라고 정의하고 있다. 그리고 추가적으로 shortcut connection을 이용해서 기존의 입력 값을 그대로 가져와서 multiple convolutional layers의 결괏값에 더해지도록 만들어준다. 여기서, Ws는 linear projection을 통해 입력 dimension과 multiple convolutional layers의 출력 dimension을 일치시키는 기능을 수행한다.
이 글은 표시된 게시일을 기준으로 작성된 자료입니다. 개별 사안에 대한 검토는 상담을 통해 안내합니다.