
本文解析《Deep Residual Learning for Image Recognition》,即用于图像识别的深度残差学习论文。
(跳转至正文)
论文在2016年CVPR发表,并引起了很多人的注意. 这是因为ResNet,这是本文中在Imagenet竞赛中提出的.
本文的主要特点是利用剩余学习来加深网络.
该理论认为网络越深,从数据中可以提取的特征越丰富,性能越高. 然而,在一个典型的网络中,问题在于层实际上变得太深,而不是性能. 本条采用留守学习方法改进了这些问题.
[背景]
在一个革命神经网络(CNN)中,每个不同的滤波器都通过输入对某一层进行革命操作,并从输出中提取激活图. 在这里,每个多滤波器都经过训练,可以提取不同的特征值.
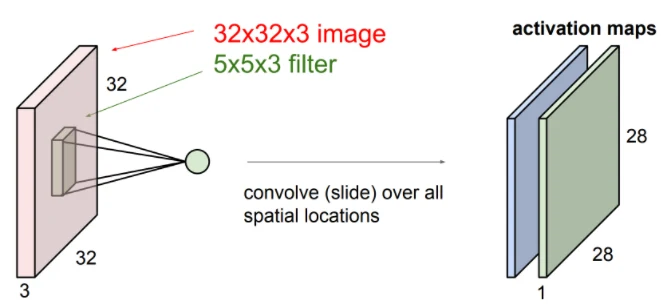
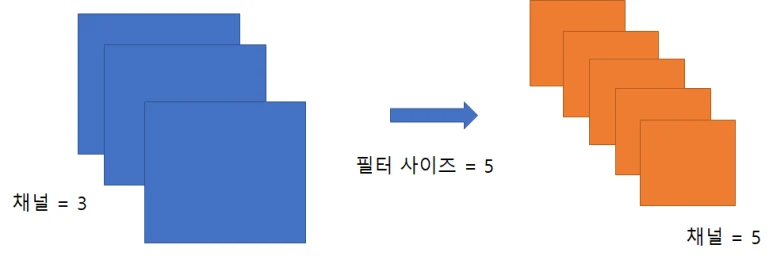
例如,假设您有一个包含三个通道的输入值. 如果使用总共5个滤波器(将5个滤波器各滑入3个输入通道进行转录操作)进行转录操作,则从输出层中抽出5个激活图(每个包含不同的特征信息). 这相当于过滤器的数量,其中激活图的宽度和高度小于输入值的宽度和高度. 因此,层层越深,输出层的通道越多,宽度和高度越小. 这是一种常见的现象,即如果在执行转录操作时没有粘贴在输入层上,高度和宽度就会降低.
同时,在ResNet之前就已经赢得了Imagenet的VGG网络使用了很多小尺寸的滤波器(3*3 convolution filter),这提高了层的深度以表现良好.
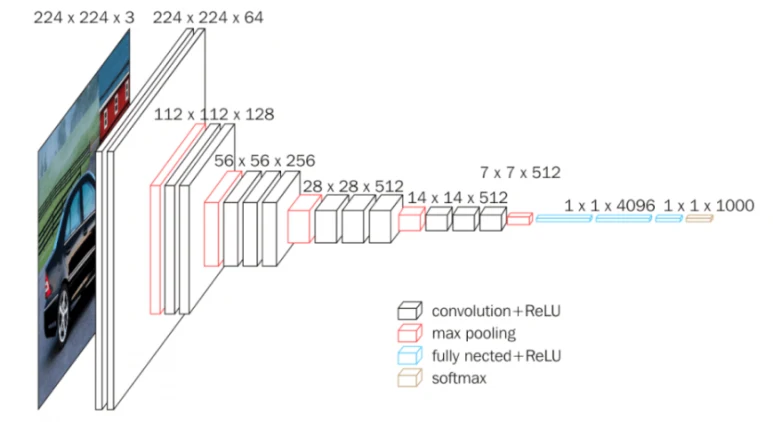
VGG网络
这些VGG网络的缺点是增加了参数的数量,但它们利用了演化层. 虽然许多网络使用它作为骨干网络, 由于参数很多,还需要加以固定。 Resnet来解决这些问题.
[本条的主要意
一般说来,层层越深,模型的学习难度越高,所以不易如意地优化.
简单地建立一个基于VGG网络的革命神经网络,是本文中一个关键的想法,即利用剩余块使学习发挥作用,因为学习是不可能的. 在此,剩余块执行一个功能,降低一个网络优化的难度.
在本文中,我们指出,实际学习的内置绘图是H(x),并争论说,立即学习是困难的. 因此,有人争辩说,通过重新定义为F(x)=H(x)-x的绘图,学习F(x)而不是H(x)比较困难.
* * * * *
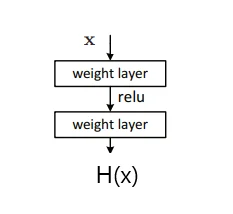
更具体地说,当x被输入到一个重层,如一个演化层时,特征被提取,特征会经历一个激活功能,如relu. 网络配置时,整个网络执行非线性操作. 然后,网络被配置成一个连续演化层的形式.
由于每个重量层在这里是分开的,所以有必要为每个重量层分别学习所有重量值. 然后,强度会增加。 这层越深,情况就越糟糕。 因此,很难学习到一个功能H(x)是理想的.
* * * * *
本文提出了使用H(x)作为F(x)函数的核心思想,F(x)是一种较为精通的学习形式. 这里没有特定的改变,只有输入值(x)加入到限定值(F(x))的多层中.
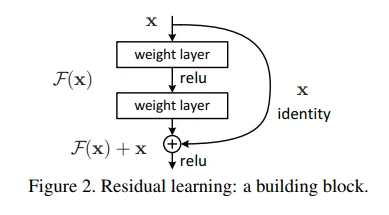
这里。 F(x)+x要从上层学习到的信息(x),通过学习附加信息F(x),加入到其中.我是认真的。 也就是说,X若按原样处理,则取尚需学习的剩余信息,F(x)+x.(这是H(x))这比教书容易得多。 通过这样改变网络,学习可以更快,更高的性能.
如果我们更详细地审视数学公式,我们首先可以定义F(x)函数如下:
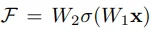
当输入值x出现时,将其乘以第一个重值(W1),写出激活引信(relu),并将结果乘以第二个重值(W2). F( x) 函数就是这样定义的 。 我们在这里加X。 最终值可通过以下形式表示.
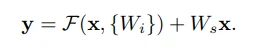
如果看这个公式,可以看到重量值可以被多次使用,而不只是两次. 这被称为多层演化层. 此外,我们可以使用快捷连接来导入已有的输入值,并把它们添加到多个演化层中. 在这里,Ws通过线性投影,实现将输入维度与多个演化层的输出维度相匹配的功能.
本文基于发表时的情况撰写。如需就具体事项咨询,请联系IPLEX。