
Технология анализа медицинских изображений и диагностики заболеваний с помощью искусственного интеллекта в последнее время быстро растет. Многие стартапы, такие как Buno, Lunett и J.K. Инспекция изучает технологию, а исследования активно ведутся для повышения точности анализа. В этой статье я хочу объяснить патент Рунета, связанный с технологией, которая повышает точность анализа медицинских изображений на основе искусственного интеллекта.
Если нажать на изображение, то можно увидеть регистрационный патент.
Патент.
Использование искусственного интеллекта для поиска подобных разделительных клеток на изображениях, полученных клетками, является ключевым аспектом настоящего изобретения. Модель ИИ, используемая в настоящем изобретении, представляет собой сверточную нейронную сеть (CNN). Модели сверточных нейронных сетей, используемые в настоящем изобретении, могут классифицировать псевдодивизиональные клетки и нормальные клетки на изображении. С другой стороны, для выполнения более точных прогнозов настоящее изобретение проходит два процесса обучения (этап 1 обучения и этап 2 обучения).
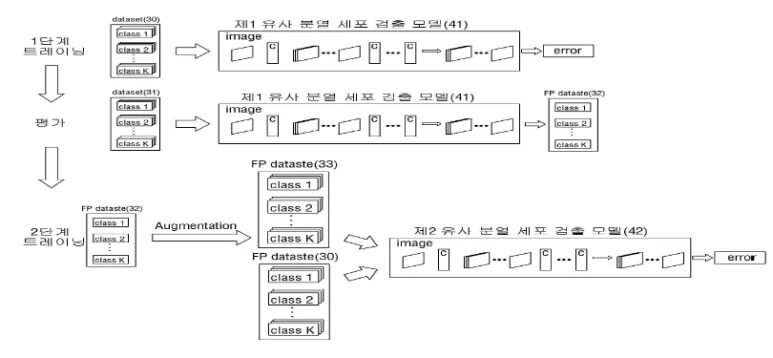
Уровень 1 Обучение
Первый этап обучения модели выполняется с использованием набора данных первой подготовки, предоставленных патологоанатомом в качестве результата классификации, указывающего на клетку митоза или нормальную клетку. До сих пор так распространено.
Подготовьтесь к 2-му этапу обучения.
После завершения обучения первого уровня подготовьте набор данных для обучения второго уровня. В частности, когда обучение на первом этапе завершено, модель оценивается для сбора ложноположительного набора данных (клетка псевдо-разделения, набор данных, классифицированный как нормальная клетка). Кроме того, для наборов данных FP выполняется увеличение данных (вращение изображения, добавление шума и т. Д.), Чтобы увеличить количество наборов данных FP. Подготовить первый набор обучающих данных и расширенный набор данных FP, используемый для выполнения первого этапа обучения. Здесь наборы данных FP — это наборы данных, которые модель ИИ неправильно классифицирует. В отрасли здравоохранения, похоже, ведется сбор данных о ФП, поскольку это наихудший случай существования заболевания, и ключевым фактором является уменьшение ошибок ФП (ложноположительных ошибок).
Уровень 2 Тренинг
Инициировать весы в модели CNN, используемой на шаге 1. При использовании модели CNN, используемой на первом этапе обучения без инициализации, веса фильтра точно настраиваются. В этом случае инициализация веса необходима, потому что точность не сильно улучшается. В случае инициализации весов модели CNN подготовленный набор данных (первый набор данных обучения + расширенный набор данных FP) используется для переучивания модели CNN (тренинг второго уровня). Если изображение классифицируется с помощью завершенной модели CNN, ошибка FP значительно уменьшается.
Мнения по патентам
В процессе проектирования модели ИИ важно уменьшить ложноположительные ошибки (FP), чтобы повысить точность модели. Однако, по моему опыту работы с большим количеством патентов на ИИ, у меня есть небольшой вопрос о патенте Lunit. Если изучить модель CNN по патенту Лунетта, то точность модели, скорее всего, будет плохой. Фактически, если вы увеличиваете набор данных FP для переучивания модели с существующим набором данных, набор данных обучения может быть смещен к набору данных FP. Тем не менее, этот метод можно использовать только для уменьшения ошибок FP.
Материал отражает ситуацию на дату публикации. Обратитесь в IPLEX, чтобы обсудить обстоятельства вашего дела.