
最近,通过人工智能分析医疗图像和诊断疾病的技术迅速发展。 许多初创企业如布诺,卢内特,以及J.K. 检查正在研究该技术,并积极进行研究以提高分析的准确性。 在此篇文章中,我想解释一个与技术相关的鲁昂专利,它提高了基于AI的医学图像分析的准确性.
点击图像即可看到注册专利.
专利
利用人工智能在细胞拍摄的图像中发现类似的分裂细胞是目前发明的一个关键方面. 本发明中使用的AI模型是革命神经网络(CNN). 本发明中使用的革命神经网络模型可以在拍摄的图像中将伪分裂细胞和正常细胞分类. 另一方面,为了进行更准确的预测,目前的发明经历了两个学习过程(第1步培训和第2步培训).
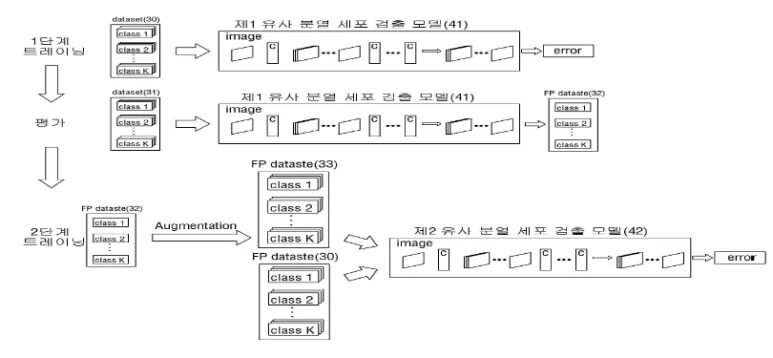
1级 培训
利用病理学家提供的一套初步训练数据,对模型进行第一阶段培训,这种分类结果指向弥氏细胞或正常细胞。 目前为止很常见.
准备进行第二阶段训练。
完成一级培训后,为二级培训编制数据集. 具体来说,在第一阶段训练完成后,该模型会被评价为收集假阳性数据集(一个伪分区单元格,一个分类为普通单元格的数据集). 此外,FP数据集的数据增强(图像旋转,噪音添加等)也是为了增加FP数据集的数量. 编制第一套训练数据集和用于进行第一阶段培训的强化的FP数据集。 在这里,FP数据集是AI模型错误分类的数据集. 在保健行业,它似乎正在收集FP数据集,因为这是疾病存在的最坏案例,减少FP错误(假阳性错误)是关键所在.
第2级 培训
初始化步骤1中使用的CNN模型中的权重. 在使用未初始化的第一阶段训练中使用的CNN模型时,滤波器的重量会微调. 在这种情况下,重量初始化是必要的,因为准确性没有很大的提高. 在初始化CNN模型的权重时,使用已准备好的数据集(第一训练数据集+增强的FP数据集)重新学习CNN模型(二级训练). 如果图像使用完成的CNN模型进行分类,则FP误差会显著减少.
关于专利的意见
在设计AI模型的过程中,必须减少假正差(FP)以提高模型的精度. 然而,在我处理很多AI专利的经验中,我对Lunit的专利有一个小问题. 如果你按照鲁内特专利学习CNN模型,模型的准确性很可能很差. 事实上,如果将FP数据集与现有数据集重新学习模型,训练数据集可能偏向于FP数据集. 然而,只有考虑这一方法才能减少FP错误.
本文基于发表时的情况撰写。如需就具体事项咨询,请联系IPLEX。