
El coste de mover datos en secuencias largas
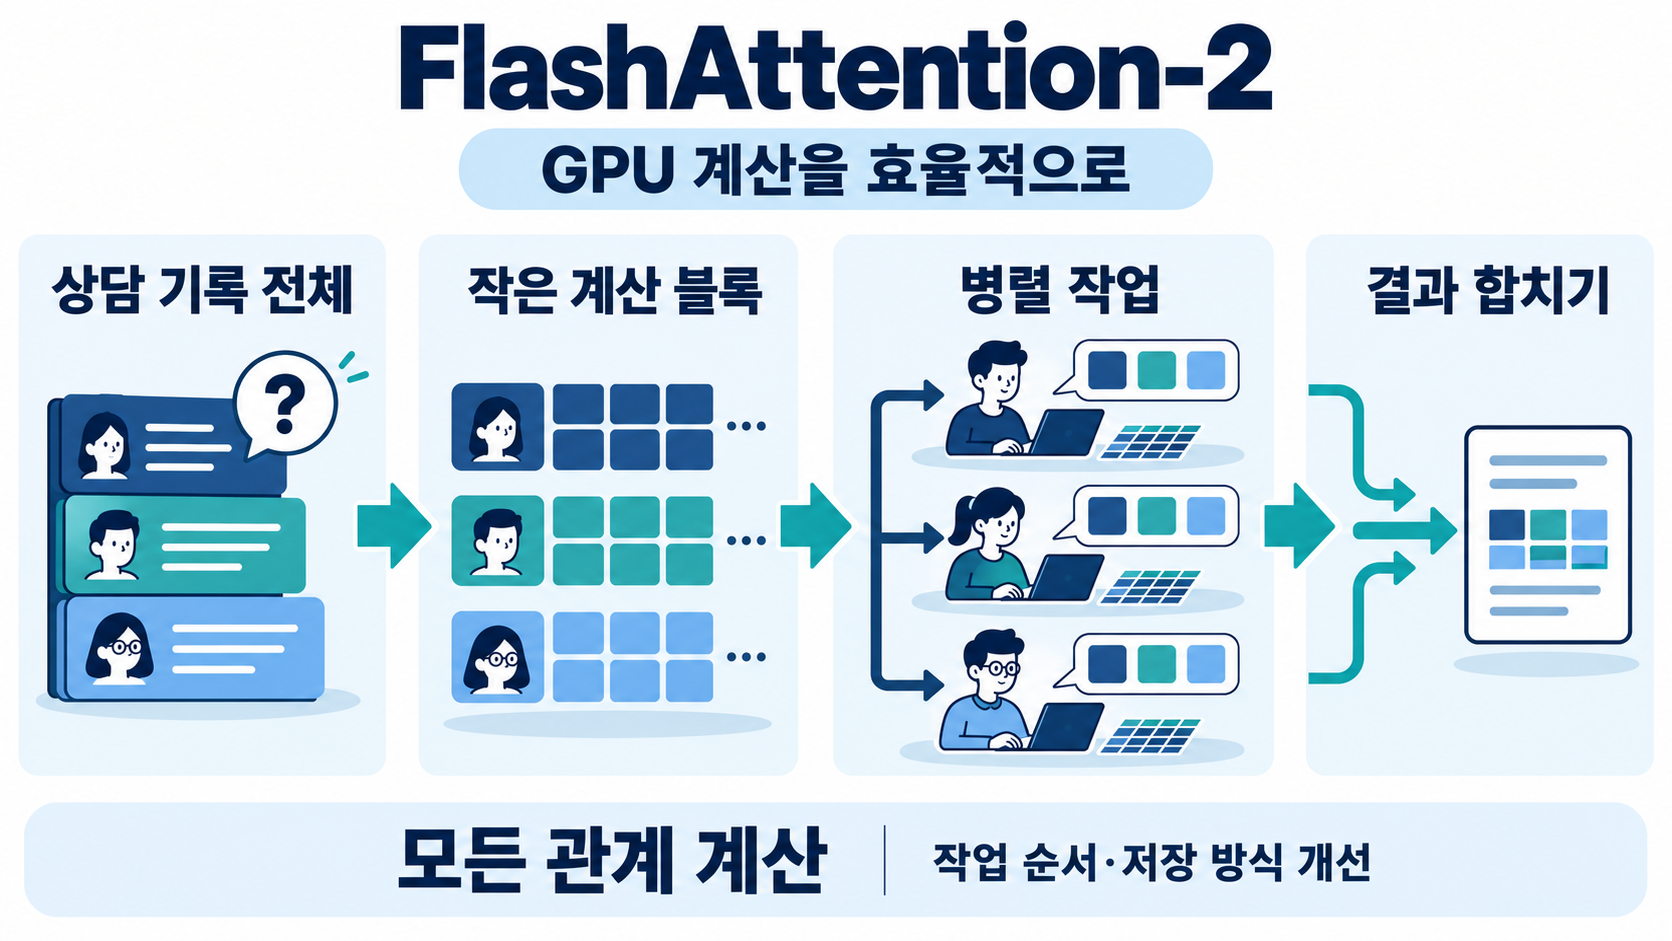
FlashAttention-2, presentado por Tri Dao en arXiv el 17 de julio de 2023, estudia cómo ejecutar la atención en una GPU. Los tokens son las unidades de texto que procesa el modelo; la atención compara sus representaciones y pondera la información aportada. Una implementación convencional materializa grandes matrices de puntuaciones y probabilidades, cuyo almacenamiento y transferencia resultan cada vez más costosos al crecer la secuencia.
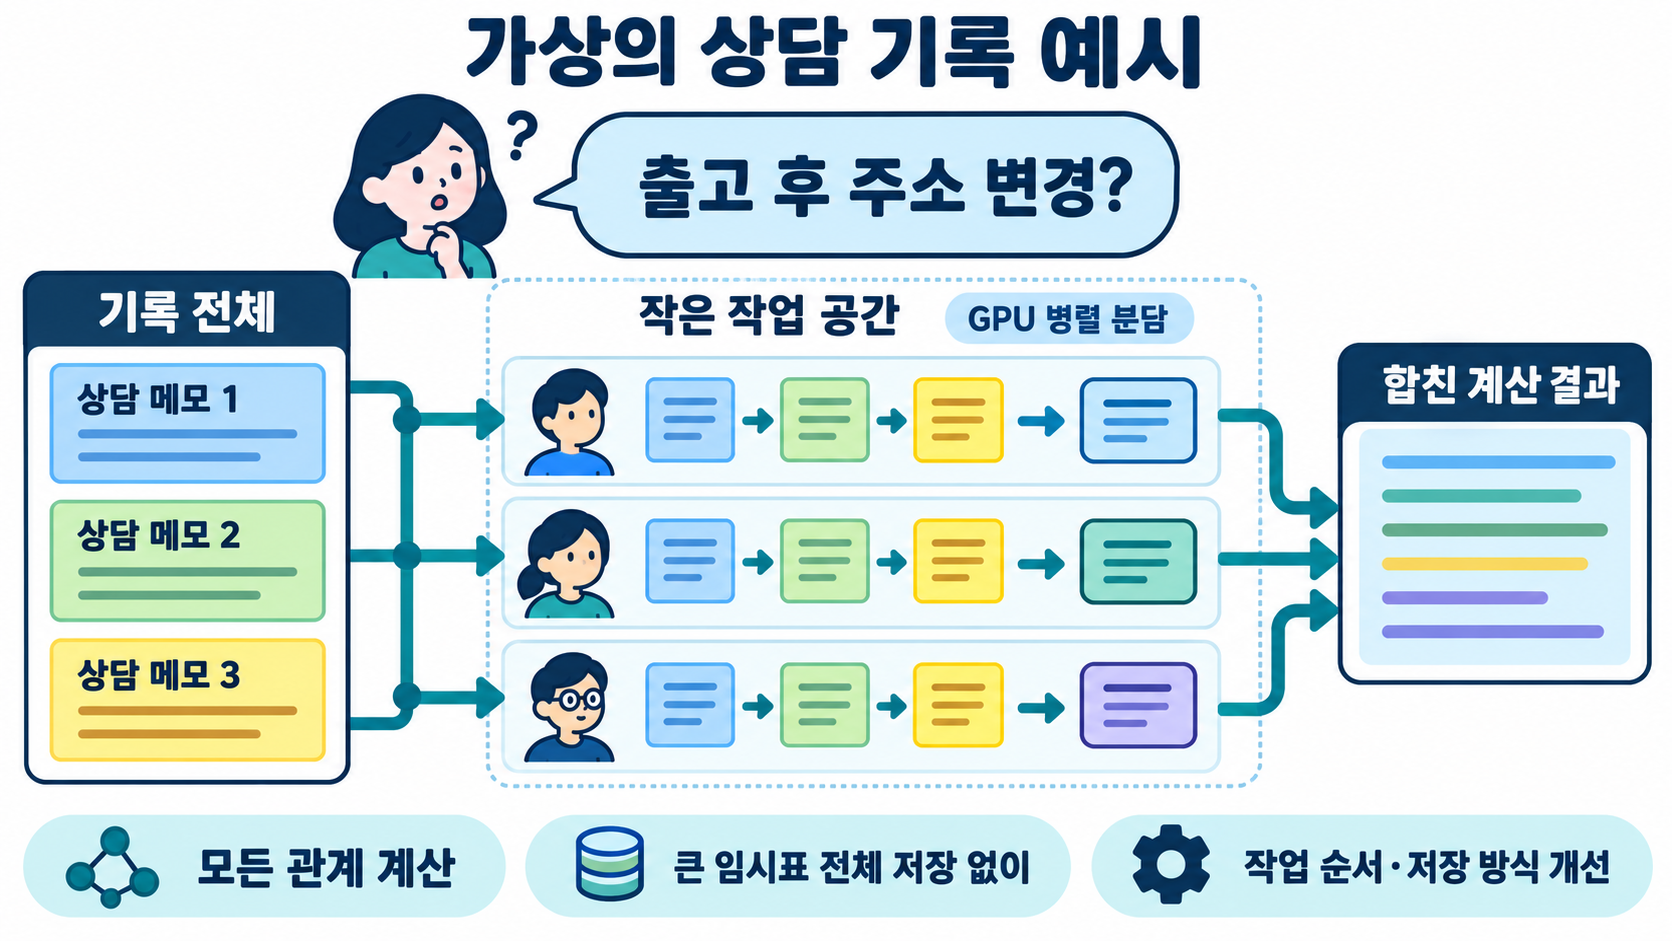
Imaginemos un servicio de atención al cliente que debe decidir, a partir de una conversación extensa, si puede cambiarse la dirección de un pedido ya enviado. Es un ejemplo ficticio para explicar el cálculo, no un ensayo de la publicación ni un resultado de un servicio real. La capacidad aritmética de una GPU se desaprovecha cuando sus unidades esperan demasiado tiempo a que lleguen los datos.
Bloques pequeños, normalización global
La primera versión de FlashAttention ya dividía los datos en bloques, los procesaba en memoria rápida integrada y evitaba guardar las matrices intermedias completas en la memoria de alto ancho de banda. El softmax en línea actualiza y reescala estadísticas y salidas parciales para mantener la normalización global. Normalizar cada bloque por separado y sumar sus resultados no equivale al mismo cálculo.
En la analogía, se revisan grupos pequeños de notas sobre una mesa limitada y se actualiza un resumen de trabajo. El modelo real opera con representaciones numéricas, no con los juicios humanos de la ilustración. El algoritmo conserva la atención exacta, pero el orden de las operaciones en coma flotante puede producir pequeñas diferencias. Se comparan salidas y gradientes dentro de tolerancias numéricas, sin exigir identidad bit a bit.
Tres mejoras en la utilización de la GPU
Primero se reducen operaciones distintas de la multiplicación de matrices, como parte del reescalado y del tratamiento de límites y máscaras causales. Así se aprovecha mejor el hardware matricial. Segundo, se reparten tareas a lo largo de la secuencia, además del lote y las cabezas de atención, para ocupar más unidades cuando las secuencias largas obligan a trabajar con lotes pequeños.
Tercero, en la pasada hacia delante se distribuyen las consultas Q entre warps, compartiendo las claves K y los valores V. Cada warp calcula su parte de la salida y disminuyen los intercambios y reducciones de resultados intermedios mediante memoria compartida. La mejora reside tanto en el reparto del trabajo y el movimiento de datos como en los pasos de cálculo.
Qué significa la mejora de aproximadamente dos veces
Los ensayos del núcleo de atención en una A100 80GB SXM4 muestran una velocidad aproximadamente doble frente a FlashAttention. Se comparan secuencias de 512 a unos 16k tokens, dimensiones de cabeza de 64 y 128 y variantes con o sin máscara causal, manteniendo 16k tokens totales por lote. Se mide la operación de atención de forma específica.
En otros ensayos de entrenamiento GPT con ocho A100 80GB SXM4, la mejora de extremo a extremo llega a aproximadamente 1,3 veces. Se utilizan modelos de 1.300 y 2.700 millones de parámetros y contextos de unos 2k y 8k tokens. Persisten otros cálculos y comunicaciones: no cabe prometer que cualquier chatbot responderá el doble de rápido. El coste aritmético sigue creciendo cuadráticamente con la secuencia y el ahorro de memoria no demuestra por sí solo una comprensión más precisa.
Cómo documentar una diferencia técnica
Compare el mismo modelo y las mismas entradas, registrando GPU, longitud, tamaño de lote, memoria y tiempo. Distinga el procesamiento inicial del contexto, o prefill, de la generación token a token, o decodificación: sus cuellos de botella pueden ser diferentes. Las figuras originales incluidas son ilustraciones conceptuales de este funcionamiento.
Una memoria técnica debe identificar qué matrices dejan de almacenarse, dónde se dividen las tareas y cómo se reduce la comunicación, con diagramas y pruebas comparables. IPLEX examina la implementación concreta y sus efectos al analizar invenciones de IA. Una mejora de rendimiento aislada no constituye una conclusión sobre patentabilidad.
Leer el artículo original en Tistory
Conocer nuestra práctica de patentes de IA