
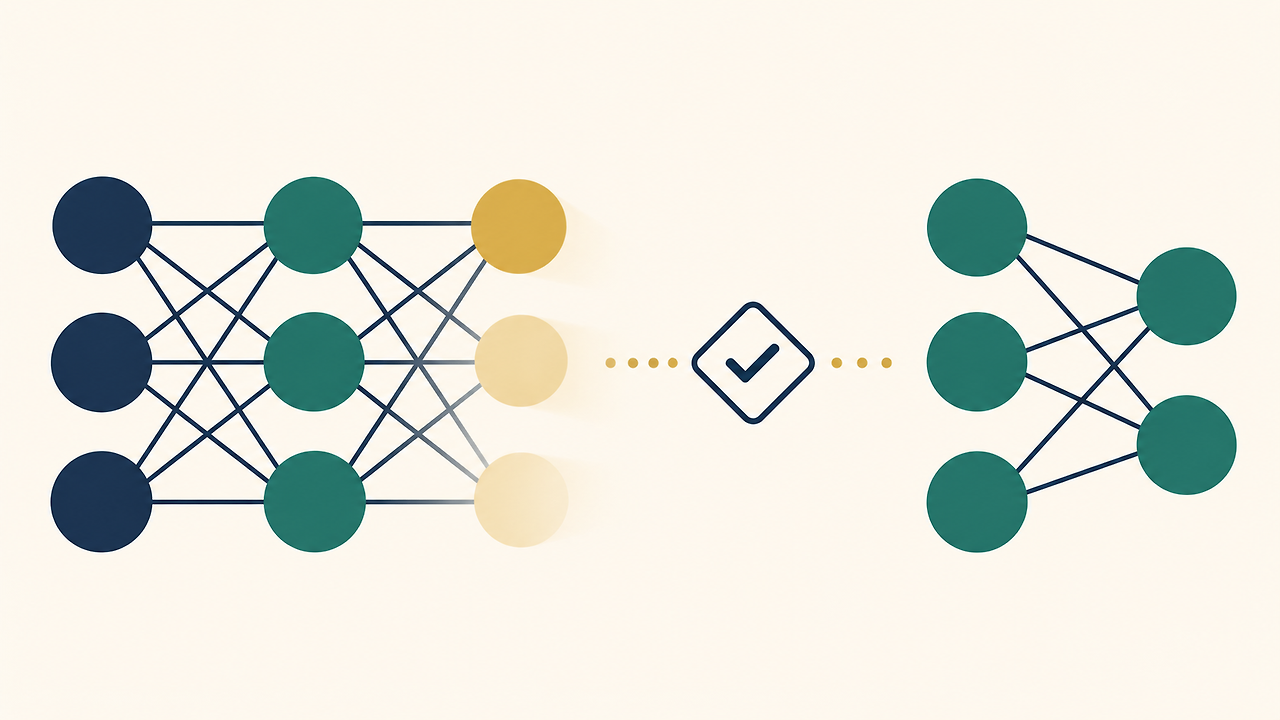
Reducir la red antes de completar el entrenamiento puede ahorrar procesamiento posterior. Pero una importancia inicial baja no demuestra que un nodo seguirá siendo prescindible: la patente de NVIDIA observa la estabilidad de la subred candidata.
1. Elegir qué eliminar y cuándo
Una red neuronal contiene capas de nodos de cálculo y pesos aprendidos. La poda estructural elimina nodos o estructuras comparables y reduce el modelo que seguirá entrenándose.
La importancia puede estimarse por magnitud de pesos o sensibilidad al gradiente. Seleccionar candidatos y determinar la estabilidad de su estructura son decisiones distintas.
US12792915B2 de NVIDIA se solicitó el 15 de marzo de 2021 y se concedió el 10 de noviembre de 2026. Vincula importancia, subred candidata, estabilidad y poda temprana.
2. La clasificación inicial es provisional
Un nodo poco importante al principio puede resultar útil después. Eliminarlo inmediatamente puede limitar el aprendizaje antes de estabilizarse la distribución de capacidad.
El método observa candidatos a lo largo del entrenamiento, sin considerar definitiva la primera clasificación por importancia.
Conviene documentar tanto la regla para retener nodos como la condición que determina cuándo ejecutar esa selección.
3. Qué compara EPI
El artículo de los mismos autores en CVPR 2022 presenta Early Pruning Indicator, EPI. Ordena los nodos y representa la subred mediante el número retenido en cada capa.
EPI promedia similitudes entre la estructura actual y las de épocas anteriores. El algoritmo 2 exige alcanzar un umbral y no quedar por debajo de ninguna de las cinco puntuaciones previas para pasar a podar en la siguiente época.
Recuentos parecidos no implican nodos idénticos ni pesos fijos. El indicador describe estabilidad estructural, no el fin del aprendizaje ni una garantía de precisión.
4. Un clasificador documental hipotético
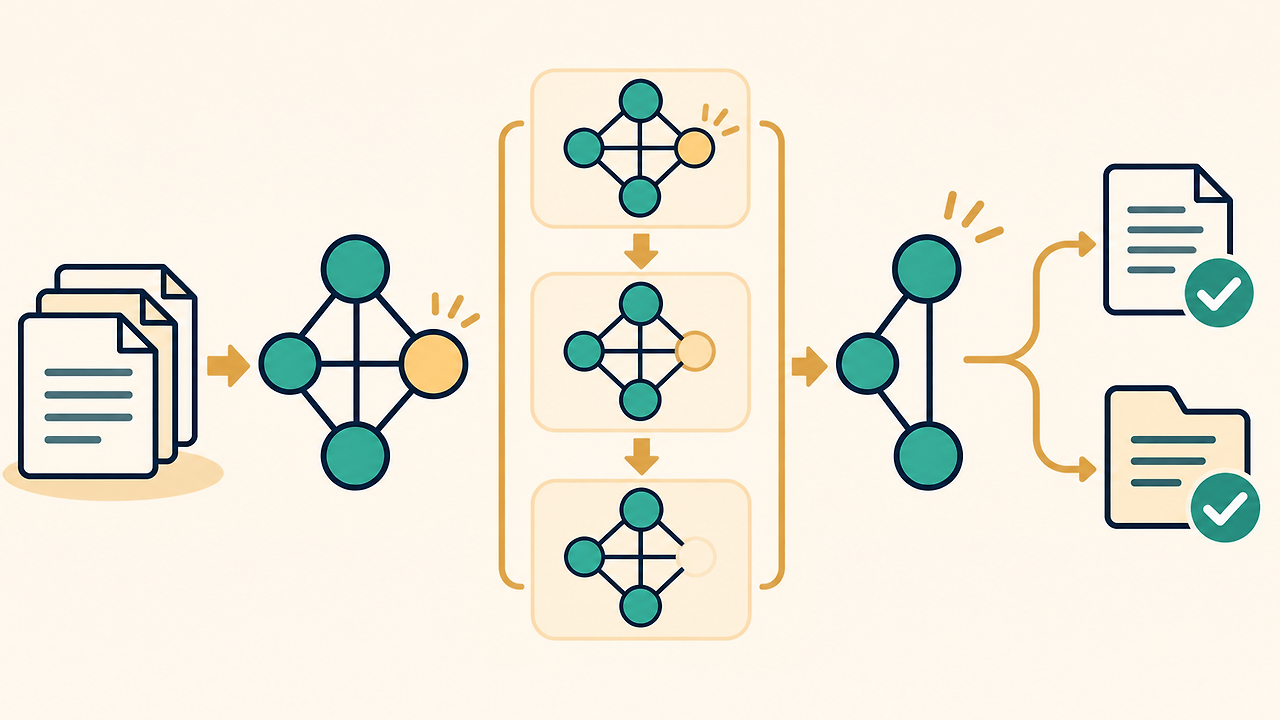
Imaginemos que compras clasifica pedidos, albaranes y facturas. Al principio puede variar considerablemente la distribución de nodos importantes entre capas superficiales y profundas.
Cuando esa distribución cumple el criterio de estabilidad, se eliminan nodos de menor rango y continúa el entrenamiento de la red reducida. No se eliminan categorías ni ejemplos documentales.
La figura explica el proceso, no un ahorro medido para ese clasificador. Sigue siendo necesario evaluar datos reservados, especialmente documentos de aspecto parecido.
5. Diferencia frente a podar un modelo preentrenado
Minitron, en NVIDIA Model Optimizer, parte de un punto de control preentrenado y usa información de importancia obtenida con calibración para reducir anchura o profundidad.
Después necesita entrenamiento adicional o destilación de conocimientos para recuperar rendimiento. No tiene el mismo punto de partida que decidir la poda durante el entrenamiento original.
Ambos reducen modelos, pero difieren en la evidencia disponible y la contabilización del coste. El nombre de una herramienta no acredita la ejecución del mecanismo patentado.
6. Registrar proceso y resultados
Conserve criterio de importancia, recuentos por capa, evolución de estabilidad, umbral y época de poda. Compare entrenamiento denso completo y poda temprana en condiciones equivalentes.
Mida por separado recursos de entrenamiento y velocidad de inferencia en el dispositivo objetivo. Una arquitectura menor no determina por sí sola la latencia real.
La descripción técnica debe unir selección y momento de actuación con entrenamiento posterior y calidad medida. Distinga los efectos observados de las suposiciones basadas solo en el tamaño.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
El clasificador es hipotético. EPI indica estabilidad estructural, no garantiza precisión ni aplicación en un producto.
Artículo CVPR 2022 When to Prune
Documentación de poda NVIDIA Model Optimizer
La patente de compresión de Nota: reentrenar un grupo de capas con sus entradas y salidas originales
La patente de aprendizaje de Socra AI: distintos errores, distintas preguntas
Consulte los proyectos de IA de IPLEX sobre compresión de modelos y control del entrenamiento.
Conozca la experiencia de Yongduck Kim en IA