
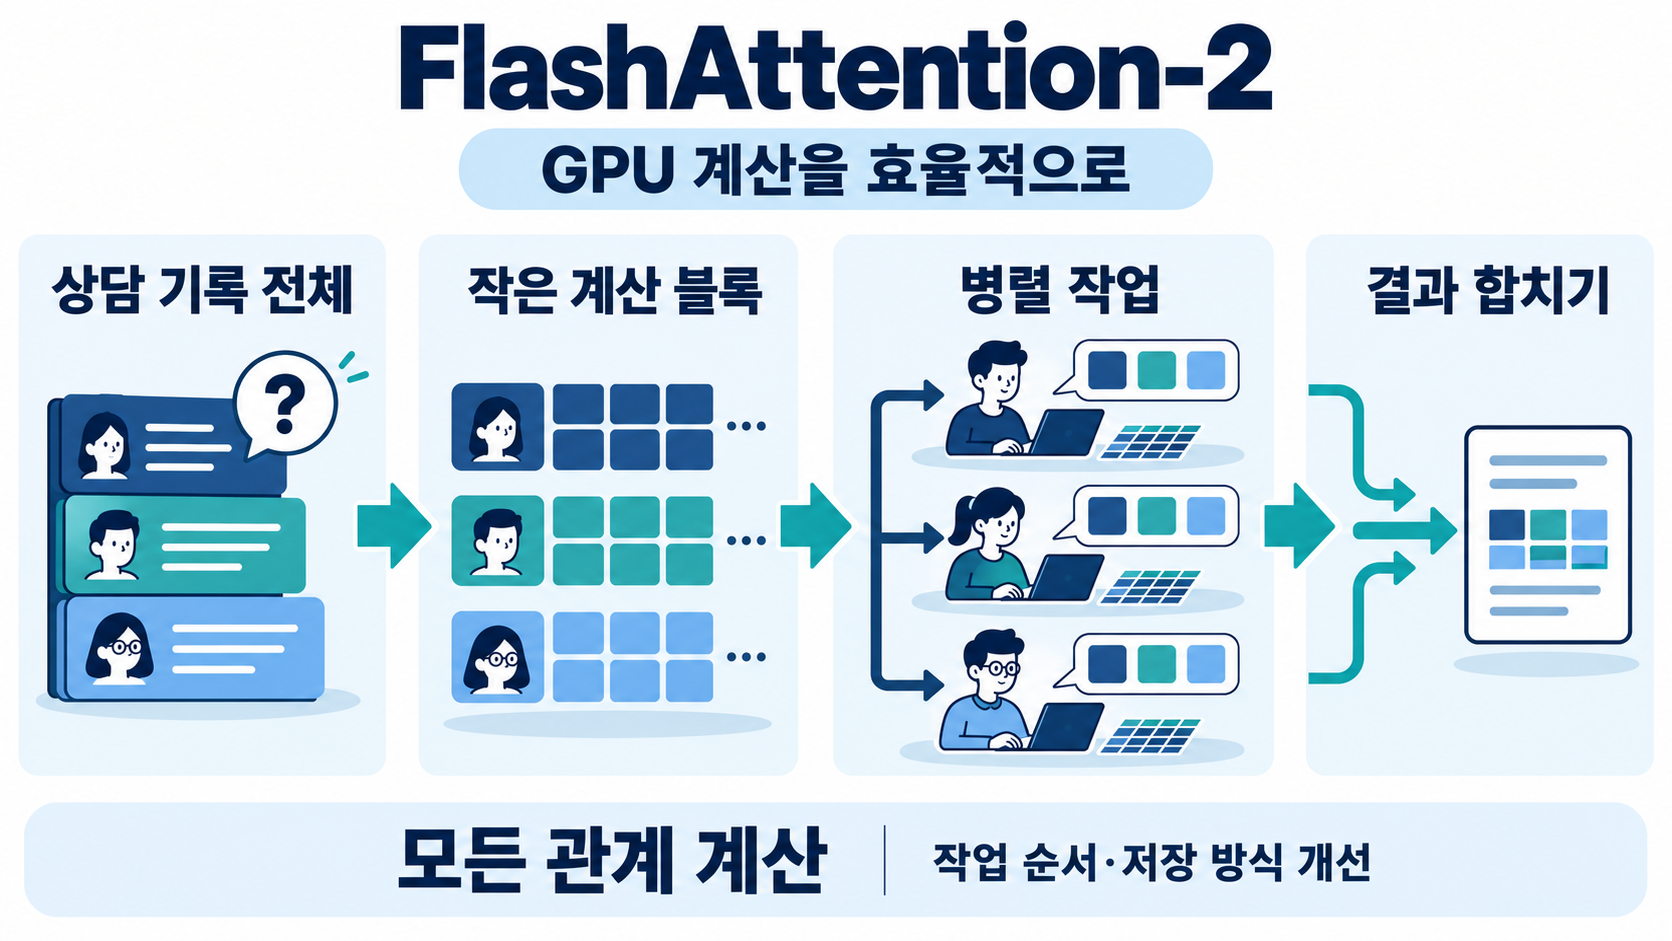
长输入的瓶颈也在数据搬运
Tri Dao于2023年7月17日向arXiv提交的FlashAttention-2研究,关注注意力计算在GPU上的执行方式。模型先将文本划分为token,再通过注意力比较其数值表示,确定信息的权重。常规实现会生成并存储庞大的分数矩阵和概率矩阵,序列越长,显存占用与数据搬运负担越大。
可以设想一个虚构的客服场景:用户询问已发货订单能否更改收货地址,系统需要联系很长的对话记录。该场景仅用于说明计算原理,不是论文实验,也不是特定服务的实际测试结果。即使GPU运算能力很强,计算单元长时间等待数据,仍难以充分发挥性能。
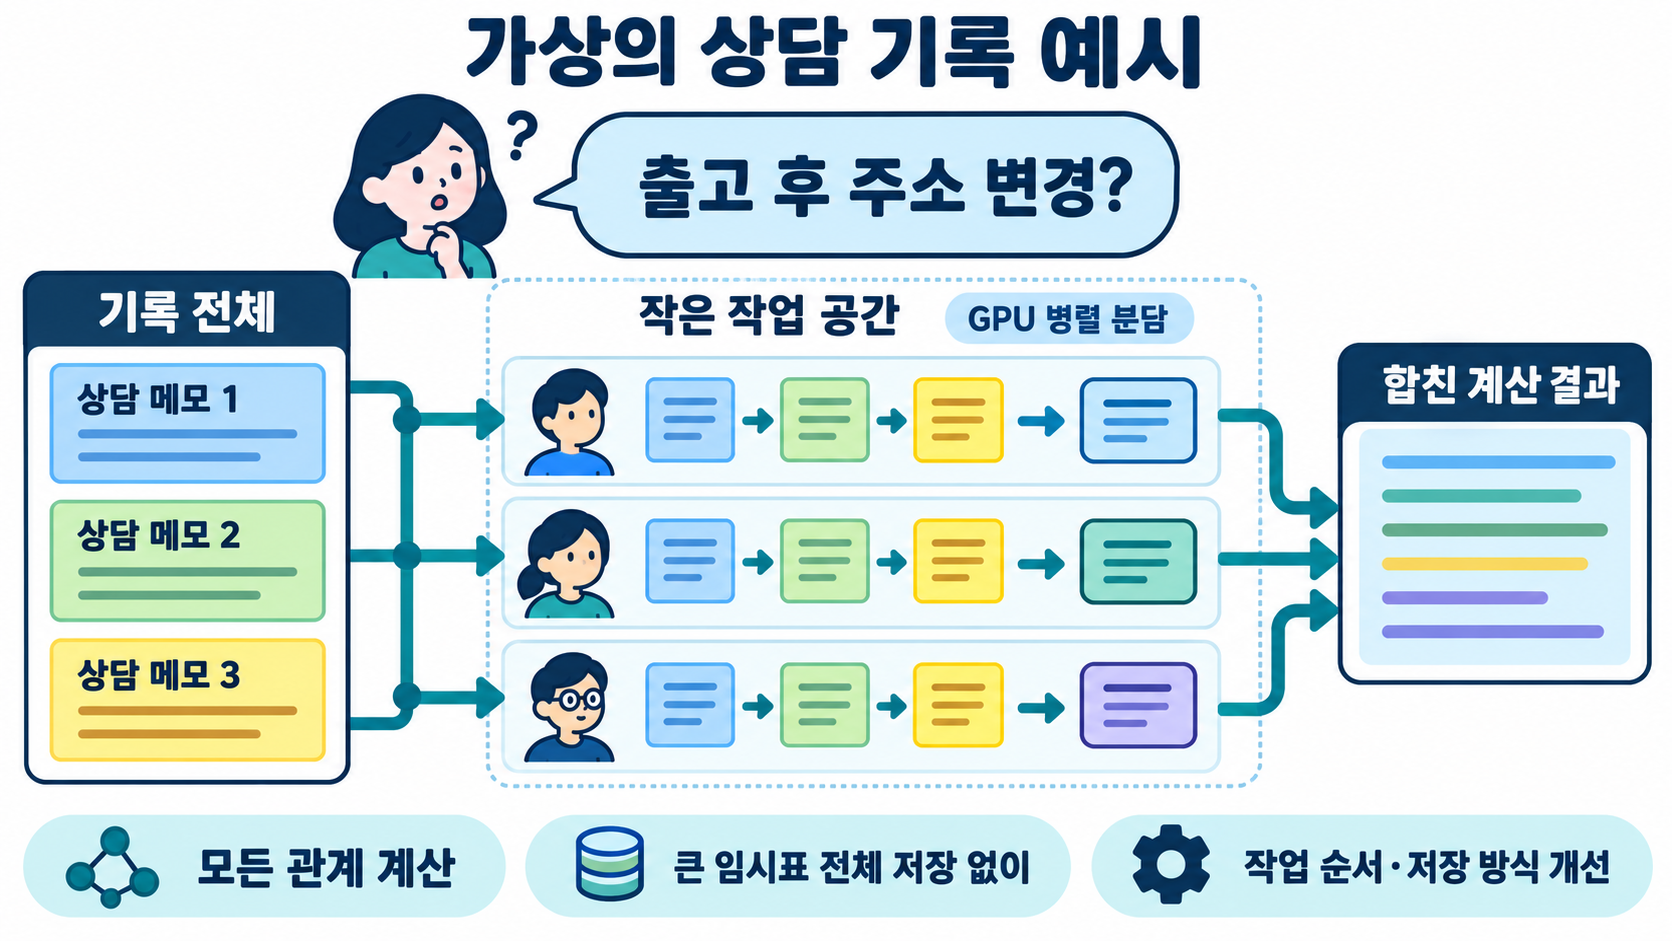
分块处理仍需保持全局归一化
将输入划分为小块,在高速片上存储中计算,并避免把完整中间矩阵写入HBM,是从初代FlashAttention继承的思路。在线softmax持续更新统计量和部分输出,并进行重新缩放,使结果保持对整个序列的归一化。若各块独立归一化后直接相加,就不是同一计算了。
用客服记录打比方,相当于在有限工作台上逐批处理便条,同时更新中间摘要。真实模型处理的是token的数值表示,而非插图中人为写出的判断。这属于精确注意力算法,而非稀疏近似;但浮点运算顺序变化仍可能产生微小误差。因此,实现验证是在数值容差内比较输出和梯度,并非保证逐比特相同。
提高GPU利用率的三项改进
第一,减少重新缩放、边界判断和因果掩码处理等非矩阵乘法操作,以更多利用GPU的高效矩阵计算单元。第二,除批次和注意力头之外,沿序列维度进一步划分工作。即使长输入使批量较小,也能让更多GPU计算单元参与执行。
第三,在前向计算中,将查询Q分配给不同warp,同时共享键K和值V。各warp负责自己的输出部分,从而减少通过共享内存交换、归约中间结果的开销。优化重点既包括计算步骤,也包括数据流动与并行任务安排。
“约两倍”应结合测试对象理解
作者在A100 80GB SXM4的注意力内核测试中,报告了相对初代FlashAttention约两倍的速度提升。实验覆盖512至约16k的序列长度、64和128的头维度,以及启用或不启用因果掩码的情况,批次总token数保持为16k。这一结果对应注意力计算本身。
另一组使用8张A100 80GB SXM4的GPT训练实验,整体训练速度最高约为原来的1.3倍,比较了13亿和27亿参数模型及约2k、8k的上下文长度。完整模型仍有其他计算和通信开销,不能据此承诺不同硬件上的聊天响应都快一倍。注意力运算量仍随序列长度呈平方增长,节省显存本身也不证明理解准确率提高。
把实现差异写成可核验的技术资料
在相同模型和输入下,应记录GPU型号、序列长度、批量大小、显存占用及实际耗时。还应区分首次处理长提示词的prefill与逐token生成的decode,两阶段的瓶颈可能不同。文中保留的原图是帮助理解上述原理的概念示意。
技术说明宜明确哪些中间矩阵不再落入显存、任务在哪里拆分,以及中间结果通信如何减少,并用流程图和受控对比实验支撑。IPLEX分析AI发明时,会关注具体实现及其效果;单凭基准测试更快,不能直接得出具备可专利性的结论。