
从专利实务视角阅读论文
作者:IPLEX韩国专利代理师金容德。Multi-Head Attention Residuals研究语言模型如何重新利用已经计算出的表示。不同特征组可能需要来自不同历史层的信息。本文所述实验均由论文作者报告,并非IPLEX自行开展的实验。
分析对象为Cheng Luo、Zefan Cai及Junjie Hu的Multi-Head Attention Residuals,arXiv:2607.27230v2,修订日期为2026年7月31日。作者所属机构标注为Independent Researcher和University of Wisconsin–Madison。预印本及本文转载的研究图表均归于上述作者,采用CC BY 4.0许可。
从残差流到历史表示的选择
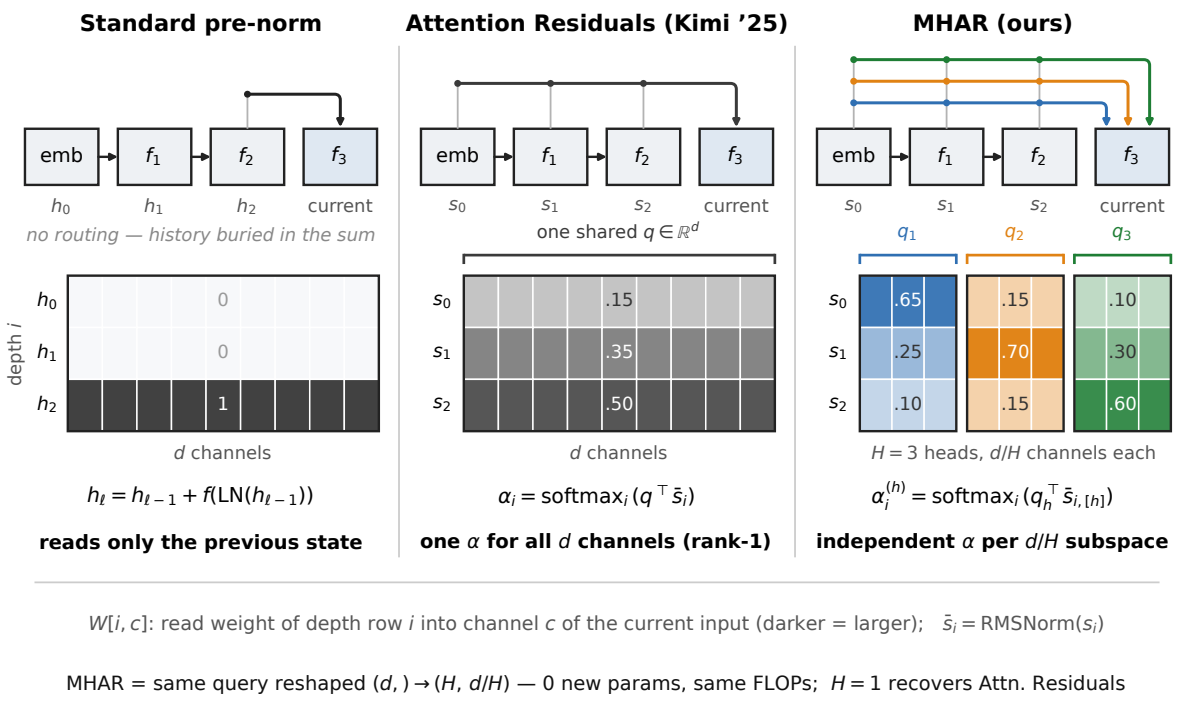
常规pre-norm Transformer将各子层的输出累加到残差流中。下一子层接收的是累积状态,而不是可以分别寻址的历史输出集合。这并不意味着历史信息已经消失,问题在于能否对其进行独立选择。
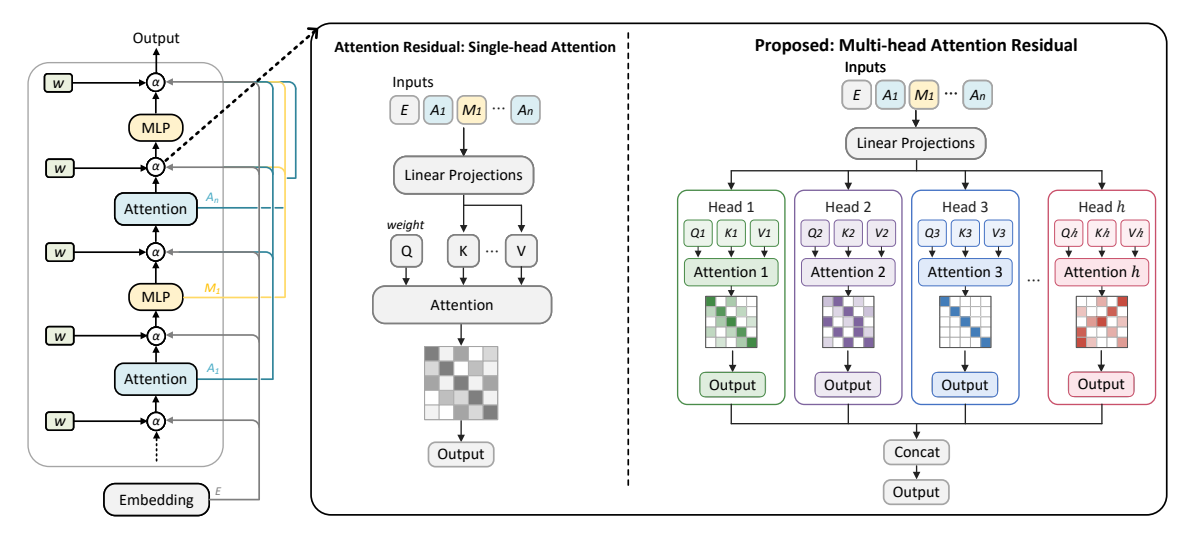
Attention Residuals将嵌入以及历史注意力、MLP子层输出分别保留为信息源,由可学习查询计算得分,再沿深度方向进行softmax并加权求和。单头方案把同一个深度分布用于所有特征通道,因此需求不同的特征组仍须共享一套选择规则。
MHAR改变了什么
MHAR把维度为d的查询及各信息源表示划分为H个维度为d/H的特征子空间。各头独立计算信息源得分,并分别沿深度方向进行softmax。各部分的加权和拼接后恢复为d维输入;H=1时退化为单头Attention Residuals。
关键区别在选择的轴:常规多头自注意力在词元之间选择,MHAR则在当前位置选择历史层输出。观察到不同深度选择模式,并不能证明各头分别专门负责语法或数学。也不应仅凭示意图推断方法额外加入了大型投影网络;其核心是对既有查询和特征维度重新分组。
处理流程及其成本
信息源仅包括嵌入和已经计算完成的子层输出,不读取未来层。通过RMSNorm获得归一化的键,以原始信息源作为值。查询和键按相同方式划分,各头分别评分并进行softmax,再将各特征组的加权和拼接,供当前注意力或MLP子层使用。
主要从零训练实验将路由查询初始化为0,因此初始信息源分布均匀。“不增加参数”是相对于单头路由而言;与常规Transformer相比,论文报告参数约增加0.02%,理论计算量约增加0.5%~1.2%。历史表示的反复读取仍会产生内存访问成本,这也是作者提出融合Triton内核的原因。
从零训练:区分不同的比较基准
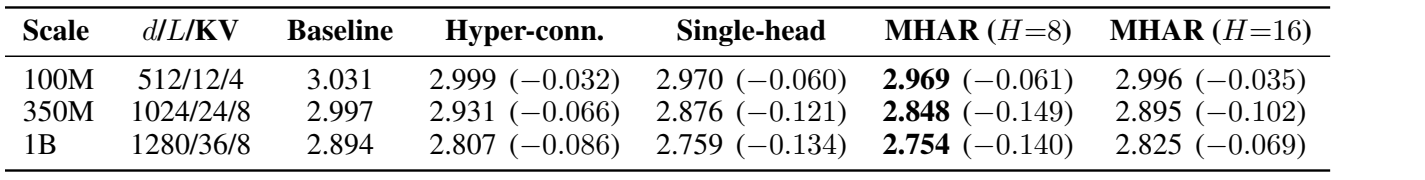
主要实验采用Qwen3式结构的100M、350M和1B模型,训练2万步。数据为清洗、去重后的英语anneal_pt_v3语料,包含较多合成数据、STEM与代码。相同规模内,对基线、Hyper-Connections、单头路由和MHAR匹配数据、训练安排及批次条件。损失取最后5千步内11次评估的平均值,这一平均本身不是多个随机种子的平均。
基线/单头/MHAR的损失分别为:100M下3.031/2.970/2.969;350M下2.997/2.876/2.848;1B下2.894/2.759/2.754。350M相对基线改善0.149,而相对单头的增量改善为0.028,不能把全部收益都归于多头划分。
论文附录H还提供了在另一套实验设置下使用FineWeb-Edu进行的三随机种子稳健性研究。该补充证据应与主表的评估平均区分,也不代表所有应用条件下的可重复性均已得到证明。
下游任务并非全面改善
1B模型从基线改为MHAR后,WikiText-2困惑度由56.4降至45.4,LAMBADA准确率由8.8%升至16.0%。但100M的HellaSwag准确率由35.0%降至33.0%。论文指出,200个评估样本存在约±3个百分点的抽样波动。不同模型规模的上下文长度也不同,应优先进行同规模比较。
如何接入已训练的8B模型
对Marin-8B继续预训练时,作者保留原有残差流,增加一个路由增量的相加分支。输出门初始化为0,使转换后的初始计算保持原状;论文报告fp32下初始最大logit差为0。随着门逐渐学会开启,新路径开始贡献。
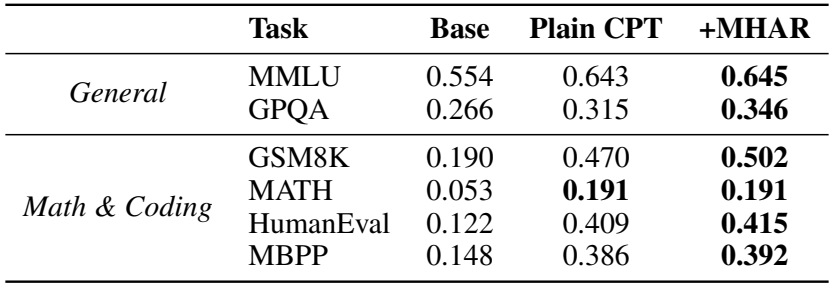
该变体将32层按每4层一组形成8个块增量,再加入可学习的null信息源,用8个头读取最多9个信息源,而非保留全部历史子层输出。数据池约为1.9万亿词元,实际继续训练使用的则约为100亿词元。比较对象Plain CPT采用相同训练安排、数据顺序及批次设置。
区分继续训练与MHAR的额外贡献
GSM8K准确率为原模型19.0%、Plain CPT 47.0%、MHAR 50.2%,因此MHAR的增量改善为3.2个百分点。GPQA由Plain CPT的31.5%升至MHAR的34.6%,差为3.1个百分点。从原始检查点到最终结果的提升很大一部分来自继续训练本身。
MATH两者均为19.1%;MMLU、HumanEval和MBPP的差异也未被描述为统计上明确。GSM8K和GPQA的配对检验分别得到p=0.004及p=0.038,但这不能替代在全部部署条件下进行多随机种子重复验证。
头数并非越多越好
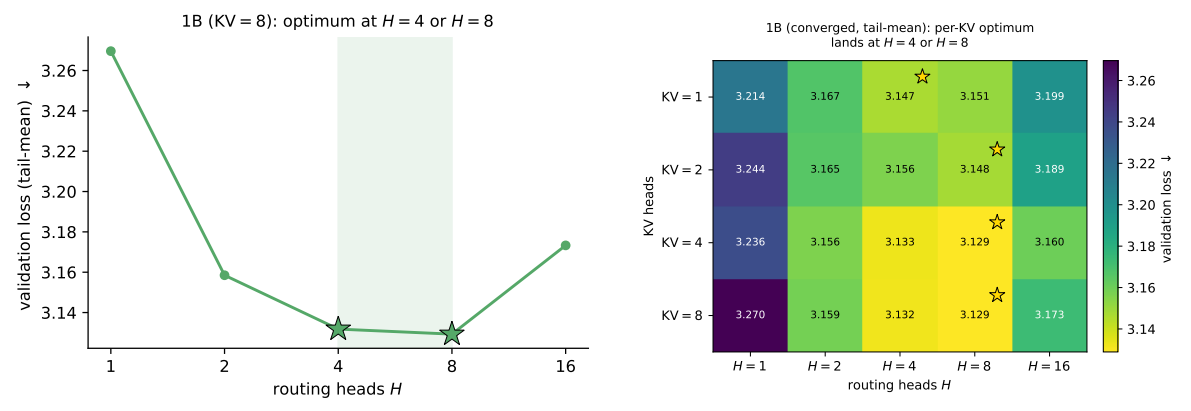
在KV头数固定为8的1B网页语料实验中,路由头数为1、4、8、16时,损失依次为3.270、3.132、3.129、3.173。4头与8头表现接近,16头反而变差。分组过少会迫使不同偏好共享规则,分组过细则可能拆开适合共同处理的特征。
8头不是普遍最优的规定。模型宽度、训练阶段和数据都可能改变合适的划分方式。网页语料实验的初始化条件也不同于主要实验,因此不能把结果差异仅归因于数据分布。
计算量之外,还要看内存搬运
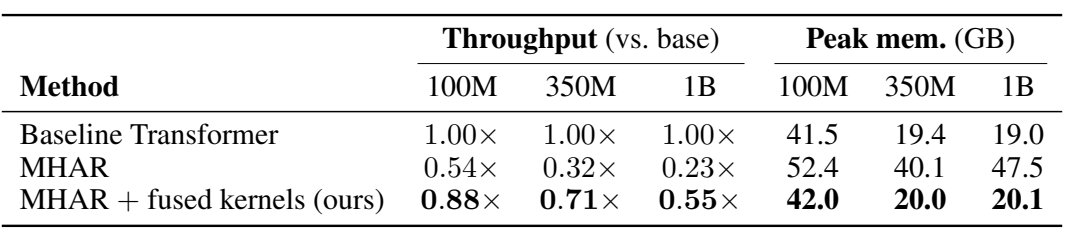
以同规模基线的吞吐量1.00为参照,普通MHAR实现在100M/350M/1B下分别为0.54/0.32/0.23,融合内核后为0.88/0.71/0.55。融合减少了重复访问与中间存储,但整体训练速度仍低于基线。
1B的峰值内存由47.5GB降至20.1GB,接近基线19.0GB,而吞吐量仍仅为基线的55%。单个路由内核的加速倍数不等于整个模型的加速倍数。同等训练步数的结果,也不能直接证明同等实际时间预算下的优势。
证据范围与仍需验证的问题
MHAR既可用于新模型的信息传递设计,也可为已有模型继续训练增加内部路径。不过,主要证据集中在英语数据及特定结构、规模,不能据此直接判断韩语模型、多模态系统、长上下文服务或生产推理的延迟与成本收益。
后续可重点检查相关设置下的多种子重复、同时间或同总计算预算比较、数据与初始化影响的分离,以及推理内存和延迟。训练指标改善不应被直接表述为用户侧响应更快的证明。
专利实务视角:把技术特征与效果对应起来
技术问题比提高语言模型准确率更具体:统一深度分布难以充分表达各子空间的信息需求,重复访问又带来内存负担。核心在于一致划分特征、沿信息源轴独立归一化、加权聚合与重新组合的处理关系。
融合执行针对中间张量与内存访问;块增量信息源和零初始化门针对信息源数量及预训练模型初始行为的保持。这些结构解决不同的实现问题,不宜归并为一个笼统的性能改善结论。
相较普通残差连接,历史输出可被单独选择;相较单头Attention Residuals,选择规则按子空间独立;相较词元注意力,信息源沿深度分布。技术效果应与这些关系及具体比较条件相联系。本文分析论文的技术贡献,并不判断其必然具备专利性,也不表示已经取得专利权。
结语
MHAR重新设计了由谁、从哪些来源、按何种比例读取已计算的信息。理解其贡献,需要同时关注子空间独立选择、预训练计算的保持及实际内存搬运成本。有价值的信息路径并不自动意味着更快的实现。
图中保留原始标注与形态,相关含义在正文中说明。