
模型应当保留哪些信息?
长对话需要记忆,但并非所有特征都应以相同强度保留。FiX调节历史词元各个分量对当前输出的贡献。本文分析的是研究成果,并非IPLEX或客户取得专利权的案例。
论文FiX: Introducing Fine-grained Forget Gate into Softmax Attention由Runzhong Li、Renjie Liu、Qing Li及Bo Tang撰写,载于ICML 2026论文集PMLR第306卷,第68619—68640页,编号pmlr-v306-li26dl。会议于2026年7月6日至11日举行。作者单位为南方科技大学和香港理工大学,论文另注明Renjie Liu在AlayaDB的实习经历。官方记录未列出DOI或arXiv编号。论文及研究图表归属于原作者,适用CC BY 4.0许可。
标量遗忘门的限制
注意力通过查询Q与键K的比较确定权重,再汇总相应的值V得到输出O。选择关注位置与决定保留哪些信息,是两个不同问题。FoX引入依赖上下文的遗忘机制,但同一注意力头内,一个历史词元的全部特征仍共用一个标量衰减率。
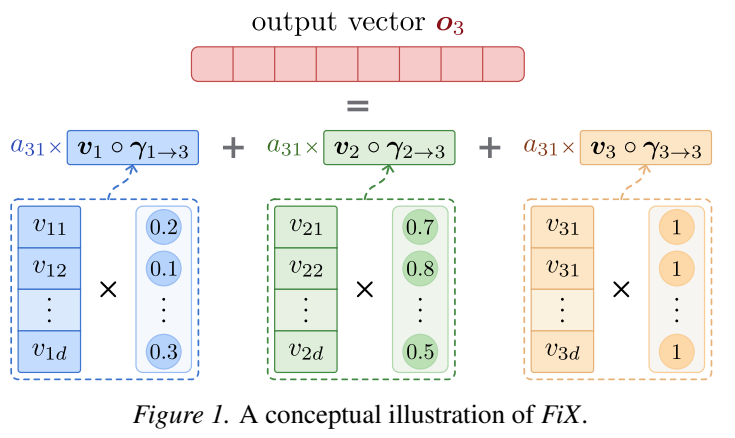
向量门控不能直接加到标量形式的Q–K点积中。FiX因此改变遗忘作用的位置:先以累积的逐元素门控调节值向量,再汇总其贡献。同一词元中的部分特征可以长期保留,其他特征则更快衰减。图1中的0.2、0.1和0.3等门值仅用于解释,并非准确率。当前词元对应的空乘积为1。
RMSNorm与RoPE各自承担的作用
实现上述改写的数学基础是输出端RMSNorm。在理想RMSNorm下,共同的正比例因子会被约去,因而可将标量遗忘从分数路径移至值—输出路径,再推广为逐特征门控。稳定常数ε为0时等价关系严格成立;FiX在输出归一化中采用ε = 10⁻³⁰。其计算仍保留softmax,并非证明所有Transformer都可以取消softmax。
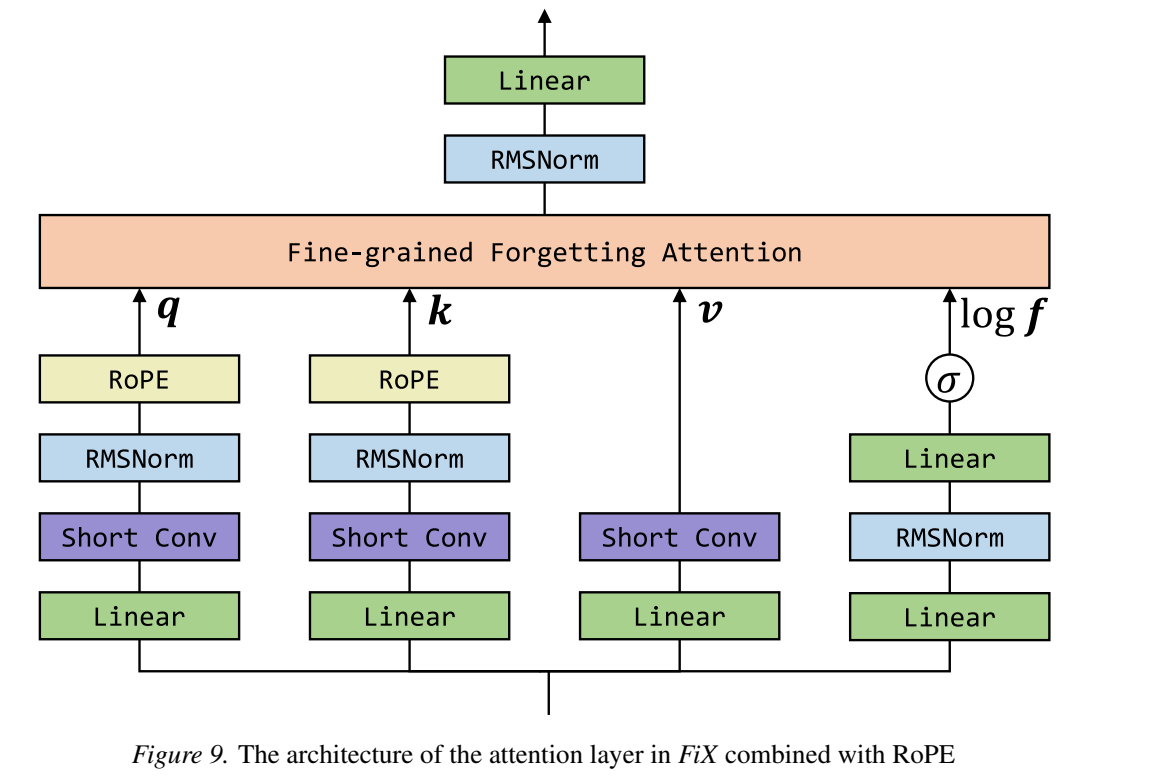
各层先由输入生成Q、K、V及门值。多数层采用中间维度为128的低秩门控投影,以控制新增参数。使用RoPE时,其作用于Q和K;累积门控则作用于V。加权汇总后,输出经过RMSNorm及线性变换。这种分工允许FiX与RoPE同时使用。
第一层不使用常规门控投影,而采用按词元ID索引的可学习门嵌入,以缓解梯度不稳定;作者还采用Mamba风格的激活函数。消融实验中,替换极小ε、第一层门嵌入或该激活函数,均使训练损失高于完整方案。
数值稳定性与实际计算
介于0和1之间的门值连乘后,在长序列中可能非常小。直接以这些乘积除V,会产生过大的数值。逐位置单独计算虽能避免该除法,却无法充分利用GPU矩阵乘法。
Flash Fine-grained Attention结合基于块参考点的重缩放和FlashAttention式分块,将累积门值之比控制在1以内。多数先前块采用矩阵乘法,对角块另行处理。实现还融合注意力、RMSNorm与后续线性层,使敏感运算保持float32精度。因此,仅添加一个门控,不能等同于复现整套数值和计算方案。
Paged VF Cache的存储取舍
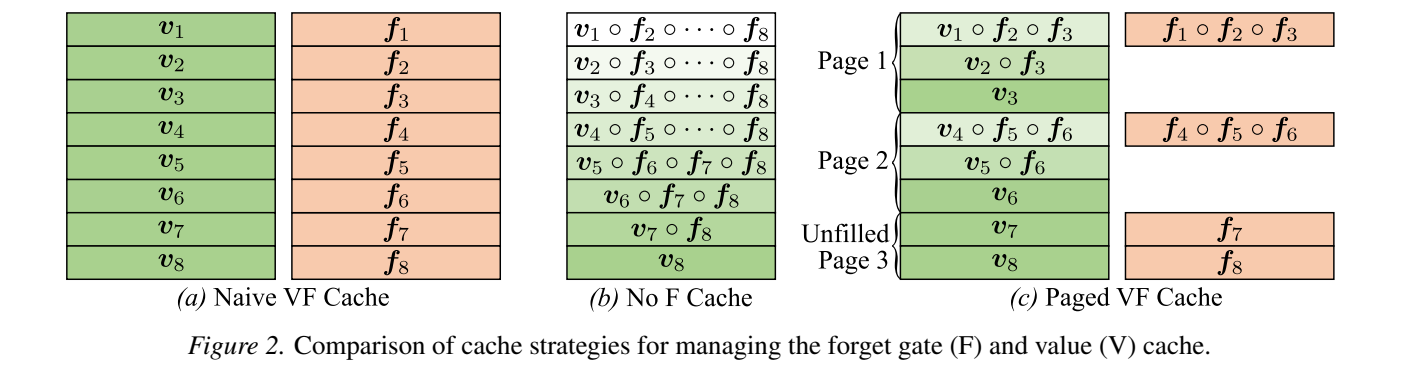
通常的自回归注意力缓存历史K和V,而FiX还需要门值F。按照论文的精度设定,若逐词元以float32存储F,新增空间大致相当于原有KV缓存。每生成一个词元就将F吸收到V中,可免除单独的F缓存,却需要反复读写全部历史V,增加带宽开销并累积精度转换误差。
Paged VF Cache按页管理词元。一页写满后,将其累积门值吸收到V并冻结该页的值,仅保留代表性的门值乘积;未写满的页仍分别保存值与门。图2以每页3个词元示意,实际讨论的设置为16。
额外门缓存约为标准KV缓存的1/p。p = 16时,约增加相当于KV缓存6.25%的门存储,并非GPU总显存减少6.25%。分页也避免了每个解码步骤都更新全部历史值。
实验比较的范围
主实验模型约7.6亿参数,在FineWeb-Edu的480亿词元上训练;消融实验约3.4亿参数、100亿词元。比较对象包括RoPE、FoX、FoX-RoPE、FiX和FiX-RoPE,采用共同架构配置,包括SwiGLU、QK-Norm、输出归一化与Short-Conv。
低秩门控投影新增约800万至1000万参数,另有第一层门嵌入。FiX的训练损失低于RoPE、FoX及FoX-RoPE,FiX-RoPE进一步降低了训练损失。但训练损失最低,并不意味着每项下游任务都最优。
准确率的提升有限,且因任务而异
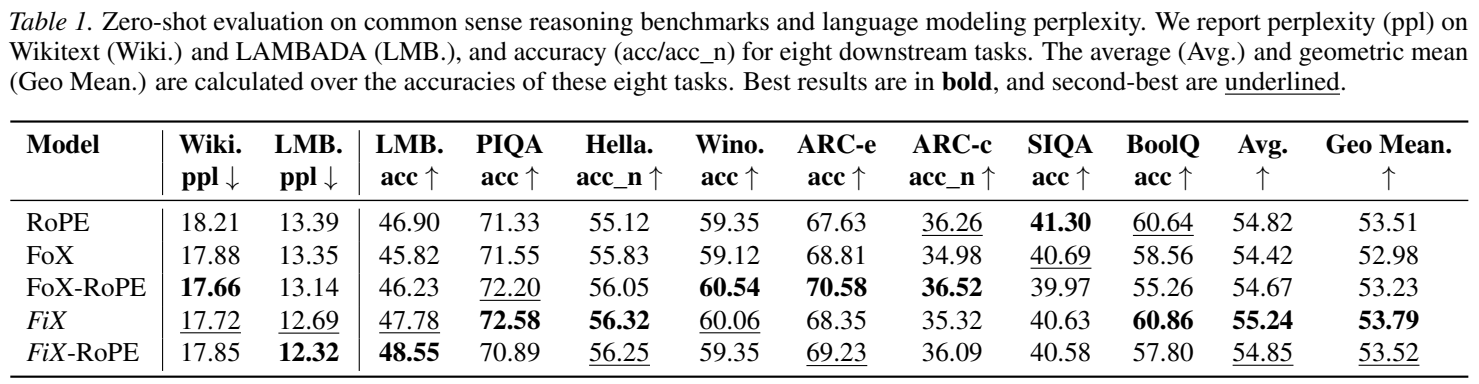
表1中,8项准确率任务的算术平均值分别为RoPE 54.82%、FoX 54.42%、FoX-RoPE 54.67%、FiX 55.24%、FiX-RoPE 54.85%。FiX比RoPE高0.42个百分点。两项困惑度结果未计入准确率的算术平均或几何平均。
FiX在PIQA、HellaSwag和BoolQ上分别以72.58%、56.32%和60.86%领先。FoX-RoPE在ARC-easy、ARC-challenge及Wikitext困惑度上更好;FiX-RoPE在LAMBADA上较优,但平均准确率不占优。这支持特定实验条件下的适度改善,不能概括为全面跃升。
更长的上下文不等于推理难题已解决
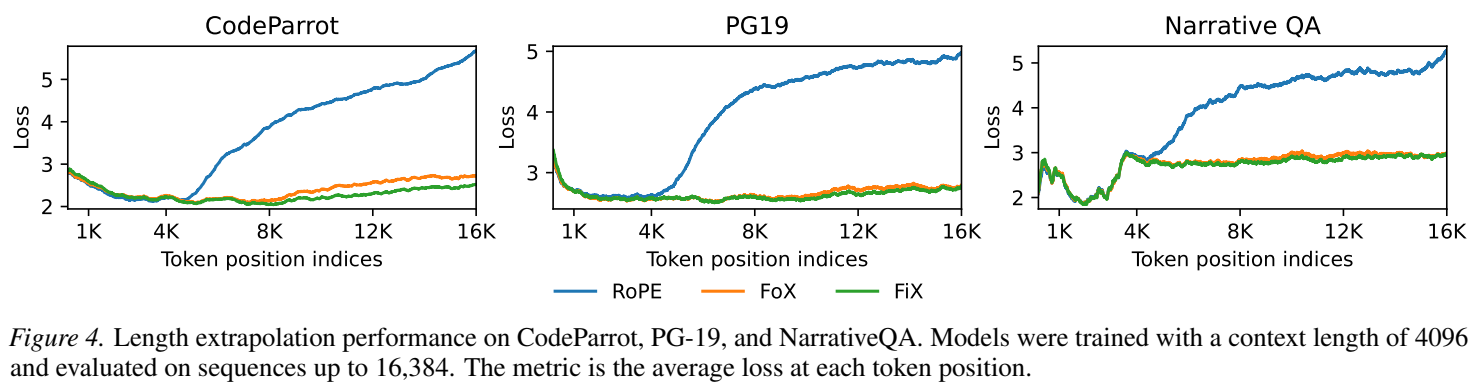
训练长度为4096词元的模型,在不额外微调的情况下,使用CodeParrot、PG-19及NarrativeQA测试至16384词元。被测RoPE基线超过训练长度后预测损失上升,FoX和FiX较稳定,FiX略优于FoX。该实验未比较与RoPE结合的变体,不能据此断言所有RoPE模型或其他上下文扩展方法表现不佳。
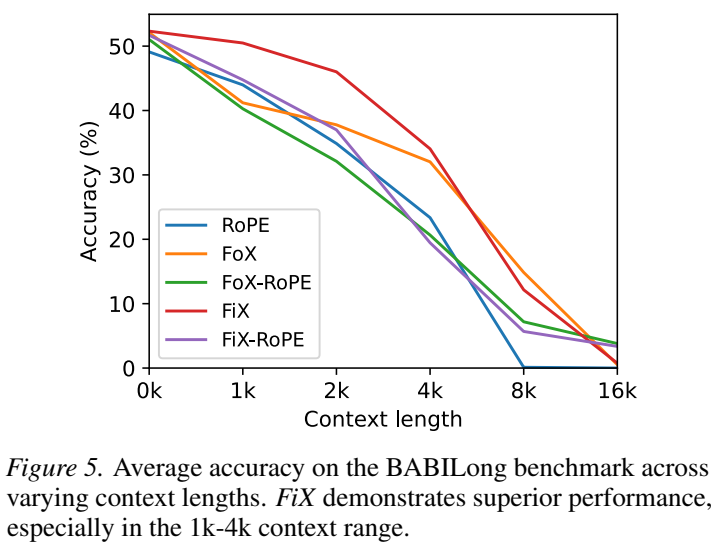
BABILong考查的是从长文档中分散的信息作答。在5项任务上,FiX于1k至4k词元范围内尤其具有竞争力,但在8k和16k时准确率也明显下降。下一词元预测稳定,与长文档推理成功,不应混为一谈。
适用范围、实现成本与专利分析视角
FiX改变注意力架构,需要训练,并非在现有部署模型中直接打开的一个设置。注意力仍与历史词元交互;分块不意味着时间复杂度变为线性,也没有取消KV缓存。门控计算与精度管理同样存在成本。
主要证据来自约7.6亿参数规模。更大模型、其他训练数据,以及生产环境的吞吐量和时延,仍需另行评估。主表中的小幅差异没有配套的重复实验误差线或置信区间,不宜据此建立普遍适用的优劣排序。
从专利分析看,应整体考察V–O路径上的逐特征累积门控、极小ε的输出归一化、第一层门嵌入、块重缩放、精度敏感运算融合及分页存储。关键在于门控的位置、粒度及其与归一化和存储的关系,而非仅仅存在一个门。实验效果可以支持技术分析,但本身不能决定新颖性、创造性或可专利性。
FiX带来的启示
FiX在保留softmax注意力的同时,提供了按特征选择性保留信息的具体方法。其数学改写配套了应对数值与存储问题的实现方案。理解中等模型规模下的积极结果时,也应同时关注长上下文的剩余局限,以及更大规模下性能与成本的验证需求。
图中保留原始标注与形态,相关含义在正文中说明。