
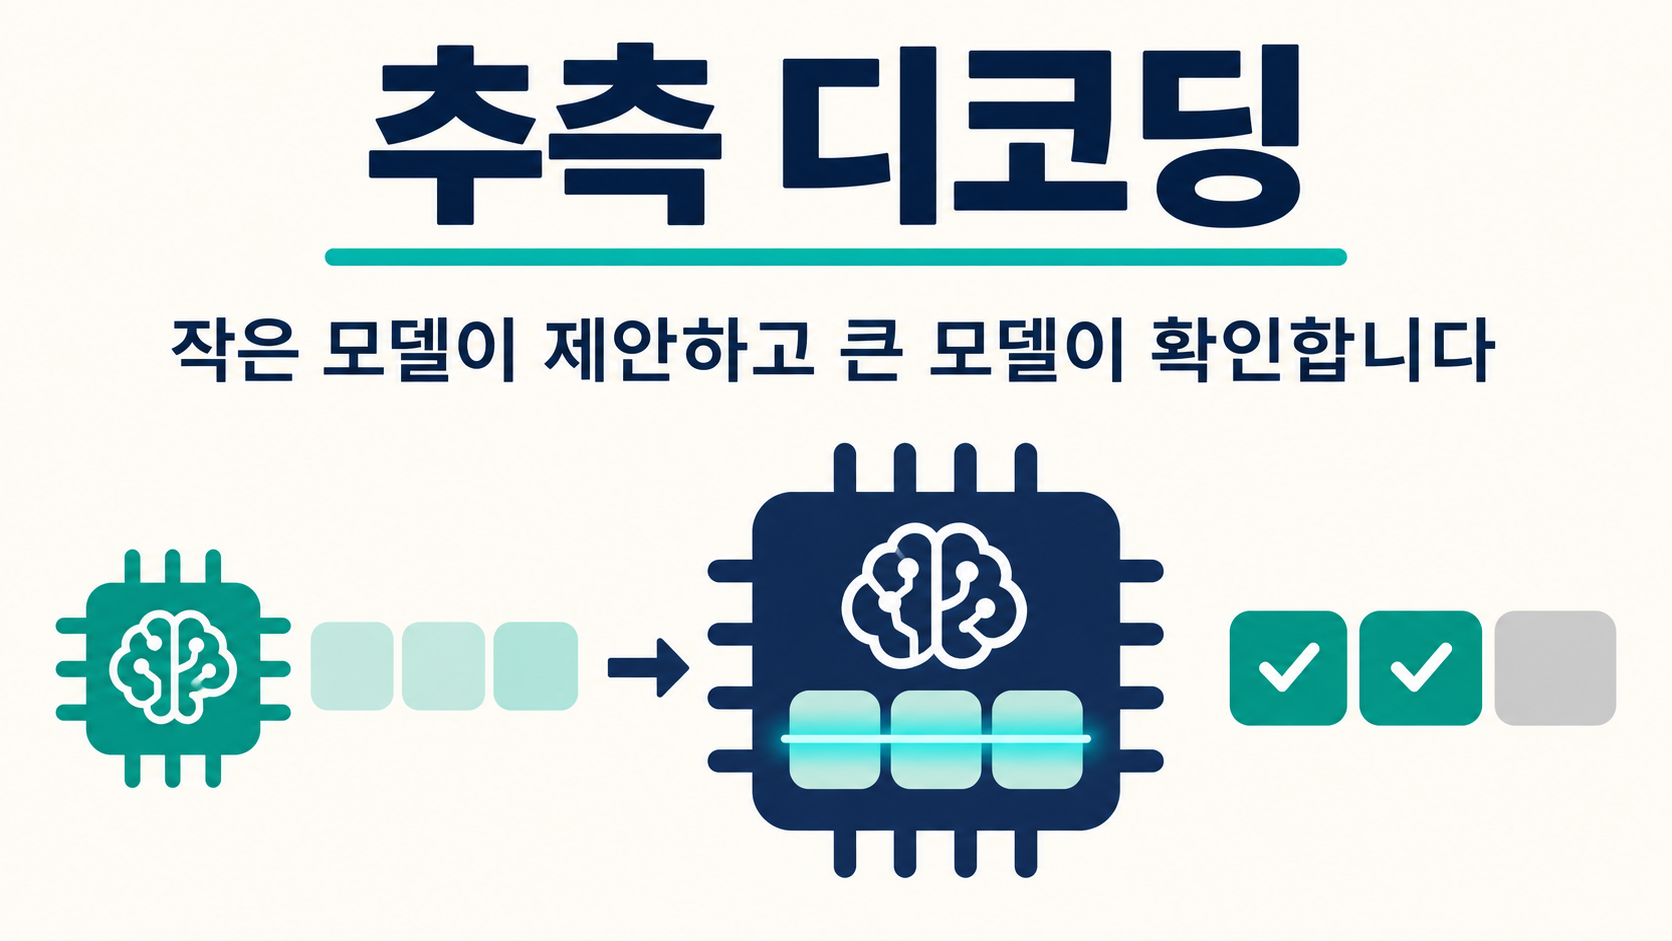
При авторегрессионной генерации выбор каждого следующего токена обычно требует дождаться вычисления большой модели. Спекулятивное декодирование позволяет небольшой модели заранее предложить несколько токенов, после чего целевая модель параллельно вычисляет вероятности для соответствующих позиций. За одну итерацию можно зафиксировать несколько токенов. Условный консультационный чат-бот и эксперименты T5-XXL показывают, как сохраняется распределение выходов и от чего зависит реальное ускорение.
В статье рассматривается работа Fast Inference from Transformers via Speculative Decoding авторов Yaniv Leviathan, Matan Kalman и Yossi Matias. Она впервые появилась на arXiv 30 ноября 2022 года; техническое объяснение и экспериментальные числа приведены по окончательной версии ICML 2023 в PMLR.
1. Почему авторегрессионный ответ появляется по одному токену
Консультационный чат-бот часто показывает ответ постепенно. Языковая модель читает уже зафиксированный текст, вычисляет вероятности следующего фрагмента и выбирает один. Затем этот выбор включается в контекст для следующего предсказания.
Такие фрагменты называются токенами: токен может быть целым словом или его частью. Текст перед очередной позицией называют префиксом. В чат-боте его образуют пользовательский ввод и уже сгенерированные токены.
Каждое вычисление большой модели добавляет ожидание. Можно ли поручить небольшой модели заранее написать несколько следующих фрагментов, чтобы большая рассмотрела их вместе?
2. Черновая последовательность и параллельная оценка целевой моделью
Небольшая модель выступает черновой, а целевая — это большая модель, изначально выбранная для генерации ответа. Черновая модель авторегрессионно продолжает текущий префикс короткой последовательностью кандидатов.
Допустим, условный чат-бот получил черновые токены A, B и C. Целевая модель параллельно вычисляет вероятности следующего токена для четырёх входов: исходного префикса, префикса с A, с A и B, а также с A, B и C. Наличие черновика позволяет заранее сформировать эти входы.
Решение о принятии идёт по порядку. Если A и B приняты, а C отклонён, фиксируются A и B, а замена на позиции C выбирается из скорректированного распределения. Вычисления для последующих позиций отбрасываются. Если принят весь черновик и генерация продолжается, из следующего распределения целевой модели выбирается ещё один токен.
Порядок действий и условия изложены в разделе 2.3 и алгоритме 1 исходной работы.
3. Принятие и коррекция сохраняют целевое распределение
Две модели могут по-разному оценивать вероятность предложенного токена. Вероятность принятия равна минимуму из единицы и отношения целевой вероятности к черновой. Если целевая вероятность не меньше, кандидат принимается всегда; иначе — с соответствующей меньшей вероятностью.
Рассмотрим условный словарь из двух кандидатов. Черновая модель назначает A 80 %, B 20 %, а целевая — A 60 % и B 40 %. Предложенный A принимается с вероятностью 60/80, то есть 75 %. Во всех попытках это даёт A долю 80 % × 75 % = 60 %.
Предложения B принимаются всегда. В 20 % попыток, где A отклонён, оставшаяся целевая вероятность приходится на B, поэтому коррекция даёт B. Его исходные 20 % плюс 20 % после коррекции составляют целевые 40 %.
Сохраняется распределение вероятностей при одинаковом контексте, а не обязательно один и тот же текст при повторном случайном выборе. Принятие соответствует правилу генерации целевой модели и само по себе не подтверждает достоверность высказываний чат-бота.
Приложение A.1 доказывает, что принятые предложения вместе с выборкой из скорректированного распределения воспроизводят распределение целевой модели.
4. Как читать результаты измерений T5-XXL
Исследователи использовали готовые контрольные точки T5 v1.1. Целевой моделью была T5-XXL с 11 миллиардами параметров, а черновой в приведённых ниже результатах — T5-small с 77 миллионами. Измерения выполнялись на одном TPU v4 при размере пакета один и сравнивались со стандартным запуском той же целевой модели в T5X.
| Задача | Длина черновика | Выборка · температура 1 | Выбор максимума · температура 0 |
|---|---|---|---|
| Перевод WMT с английского на немецкий | 7 токенов | 2.6× | 3.4× |
| Суммаризация CNN/Daily Mail | 5 токенов | 2.3× | 3.1× |
Ускорение перевода в 2,6 раза означает отношение времени стандартного метода ко времени спекулятивного декодирования. Вероятностная выборка при температуре один и выбор наиболее вероятного токена при температуре ноль дали разные значения. Упоминание примерно двух-трёхкратного ускорения в аннотации обобщает эти конкретные результаты.
Размеры моделей и числовые результаты приведены по разделу 4.1 и таблице 2 окончательной версии ICML.
5. От чего зависит ускорение в действующем сервисе
Чем длиннее принятая начальная часть черновика, тем меньше последовательных ожиданий целевой модели. Частое раннее отклонение делает ненужными вычисления последующих позиций. В стоимость каждой итерации также входит время генерации черновика.
При свободных ресурсах для параллельной работы задержка может снижаться даже при росте общего числа операций. Длину черновика и сочетание моделей поэтому следует оценивать отдельно. Более крупные черновые модели в эксперименте обеспечивали большее принятие, но максимальное измеренное ускорение дала T5-small.
Сравнивайте сервис при одинаковых длинах входа и числе одновременных запросов. Отдельные измерения времени до первого токена, интервалов между следующими токенами и количества запросов за единицу времени показывают, какое ожидание сократилось. Коэффициенты для перевода и суммаризации относятся к испытанным моделям и оборудованию.
6. Как фиксировать отличия реализации для разработки и патентного анализа
В записи о разработке можно отдельно указать длину черновика, первую отклонённую позицию, вероятности коррекции и время вычисления. Даже с одной черновой моделью реализации различаются правилами выбора длины для конкретного запроса и обработкой результатов или кеша после отклонения.
С точки зрения патентного анализа IPLEX, фраза «используется спекулятивное декодирование» не отделяет новую реализацию от опубликованного метода. Полезно связать устраняемое узкое место, входы для его обнаружения, условия изменения длины черновика или единицы проверки и изменившиеся показатели. Это практические соображения, а не дополнительные экспериментальные выводы исходной работы.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Чат-бот и пример с двумя кандидатами условны. Числа времени относятся к конкретным экспериментам T5 и не гарантируют универсального ускорения. Сохранение распределения выборки не подтверждает фактическую достоверность ответа.
ICML 2023 · запись работы в PMLR
Окончательная работа ICML · PDF
arXiv 2211.17192 · запись первой препубликации
Google Research · объяснение авторов
FlashAttention-2: эффективное вычисление внимания на GPU для длинного контекста
PagedAttention: управление KV-кэшем и памятью GPU в vLLM
Материалы IPLEX по ИИ и подготовке к консультации помогут описать работу реализации и её технический вклад.
Опыт патентного поверенного Ким Ёндока в области ИИ