
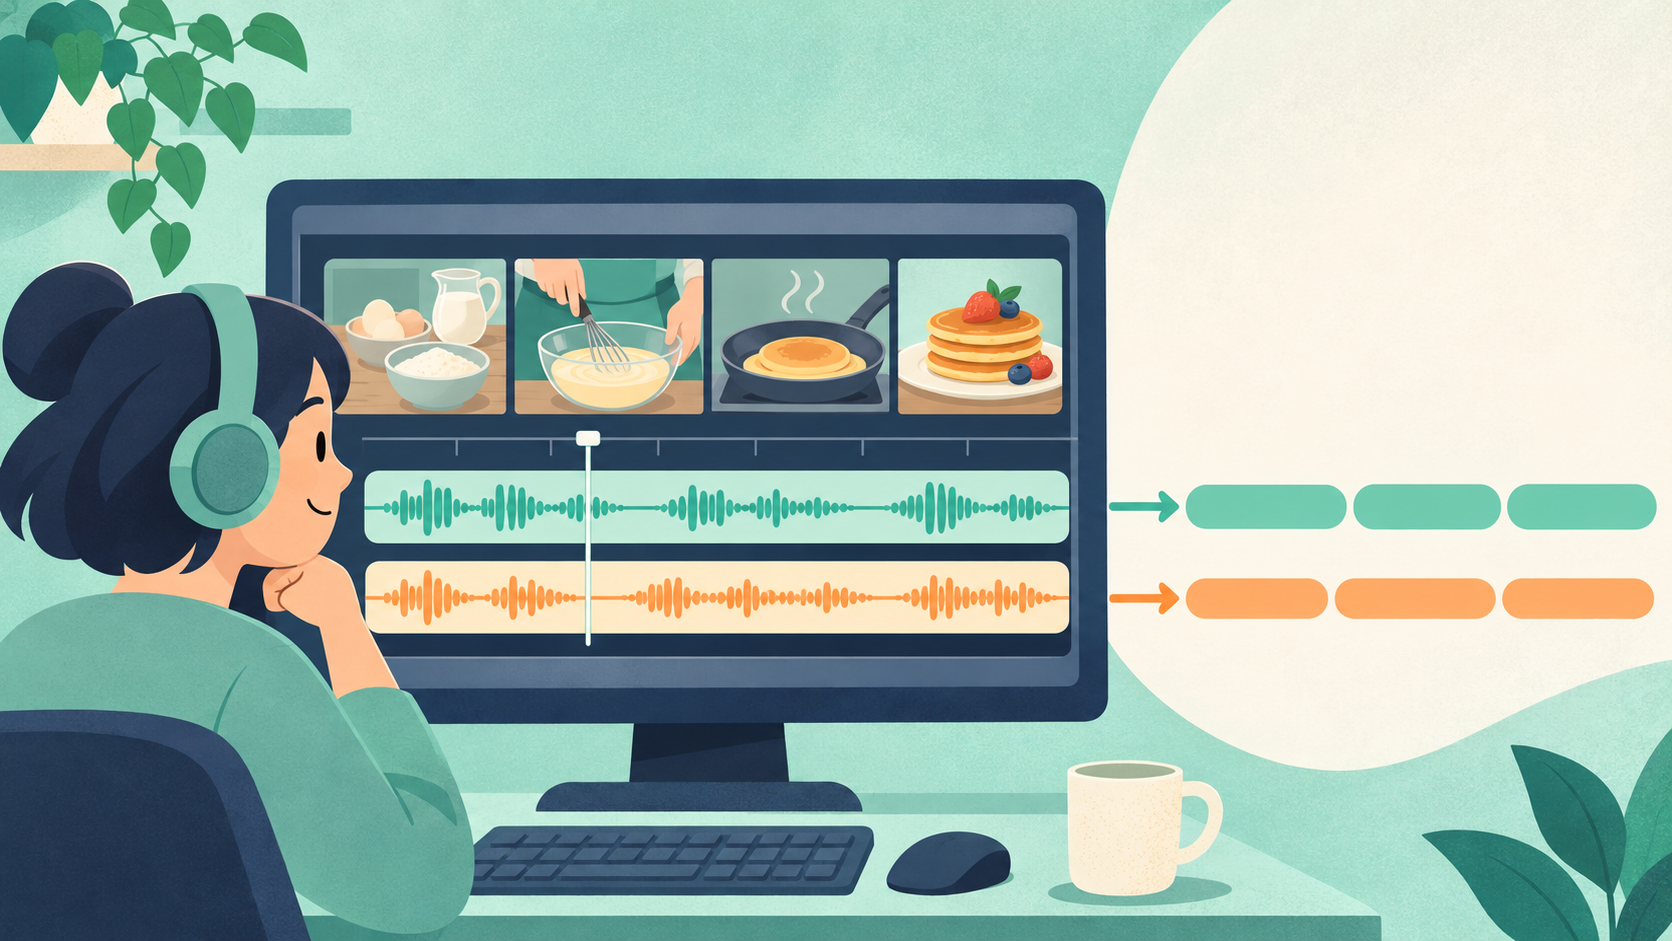
Когда в учебном видео одновременно звучат пояснение и инструкция, нужно решить две задачи: распознать нужную речь и выбрать время показа текста. В US11837234B2 описаны распознавание выбранных дорожек по отдельности, сортировка фрагментов по времени начала и сокращение предыдущего субтитра при наложении интервалов. Рассмотрим этот процесс на условном примере.
1. Два голоса в учебном видео
Представим запись сборки модели: ведущий объясняет назначение деталей, а отдельно записанный голос добавляет короткие указания. При распознавании только сведённой записи одновременные реплики могут приводить к пропускам или смешению слов.
Аудиодорожка — отдельная линия звука на общей шкале времени. Раздельные дорожки дикторского текста, инструкций и музыки позволяют менять положение и громкость независимо, а также выбирать исходные дорожки для распознавания.
Патент US11837234B2 компании Beijing ByteDance Network Technology выдан в США 5 декабря 2023 года. Предмет этого разбора — техническое решение: распознавание выбранных дорожек по отдельности и объединение текста для одного видео.
2. Независимое распознавание выбранных дорожек
Автоматическое распознавание речи преобразует запись в текст. На фигуре 1 по запросу создания субтитров определяются данные каждой выбранной дорожки; фигура 2 показывает выбор одной или нескольких дорожек и запуск обработки.
Можно, например, выбрать дикторский текст и инструкции, исключив отдельную музыкальную дорожку. Каждый голос распознаётся на уже существующей собственной дорожке. Это не следует смешивать с разделением голосов в сведённой записи.
Результат содержит текстовые фрагменты с временем начала и окончания показа. Несмотря на раздельное распознавание, их необходимо разместить на общей шкале времени видео.
3. Сортировка и сокращение предыдущего интервала
Если сначала вывести весь текст одной дорожки, а затем другой, порядок не будет соответствовать видео. На фигуре 3 фрагменты всех выбранных дорожек сортируются по времени начала показа.
Далее конец предыдущего фрагмента сравнивается с началом следующего. В примере с наложением окончание предыдущего сдвигается к началу следующего. При наличии промежутка или совпадении этих времён такое сокращение не требуется.
Меняется время отображения текста, а исходная речь остаётся на месте. Для одновременно начинающихся фрагментов отдельно описан вариант сохранения того, который заканчивается позже всех. Если важно передать каждую реплику, редактору следует проверить и сохранённый текст.
4. Одна секунда наложения в условном примере
Пусть субтитр A «Сначала проверьте паз в основании» показывается с 3-й по 7-ю секунду, а B «Поставьте боковую панель вертикально» — с 6-й по 9-ю. Они относятся к разным дорожкам и пересекаются между 6-й и 7-й секундами.
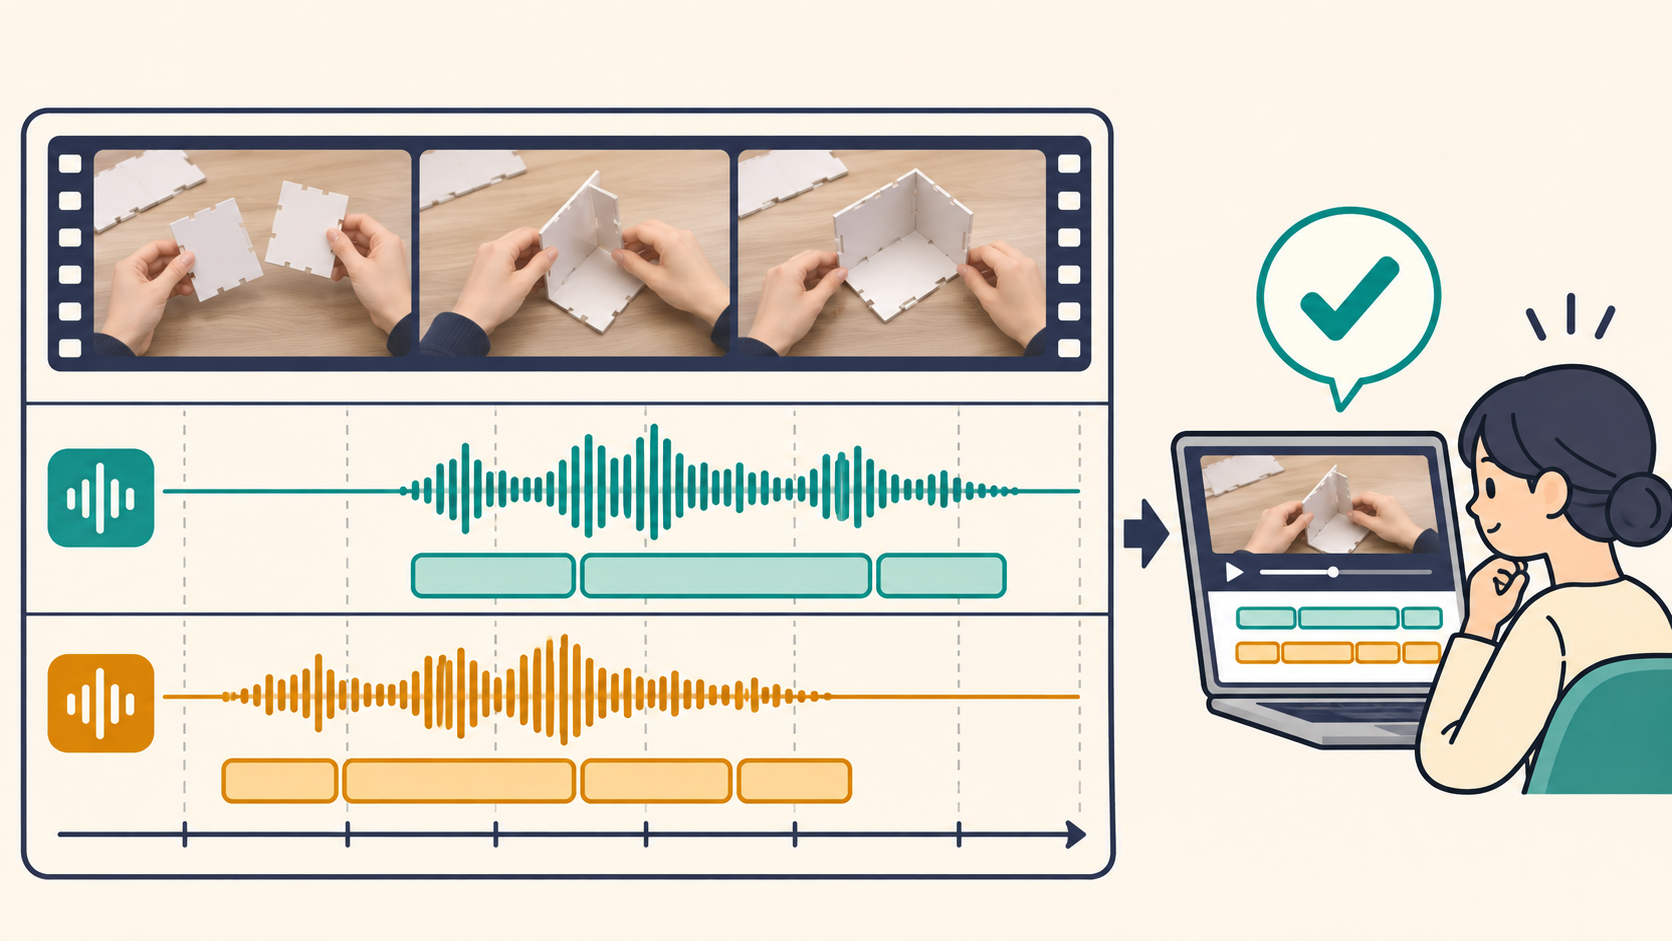
По описанному правилу конец A переносится с 7-й на 6-ю секунду. Теперь A виден с 3-й по 6-ю, B — с 6-й по 9-ю. Текст и звук не изменяются; корректируется лишь интервал показа.
Отсутствие наложения ещё не означает удобства чтения. Для длинной инструкции трёх секунд может не хватить. Разбиение текста и дополнительная настройка времени остаются задачами редактора, а автоматически полученные интервалы служат исходным вариантом.
5. Что описано в публичной справке CapCut
ByteDance включает CapCut в список своих средств видеомонтажа. Справка CapCut объясняет создание автоматических субтитров через распознавание речи: в настольной версии выбирают источник звука и язык, затем редактируют текст и время на монтажной шкале.
Учебная команда может просматривать черновик вместе с изображением и звуком. Ошибка в слове требует правки текста, а субтитр, оставшийся после завершения инструкции, — изменения времени. Это разные виды корректировки.
Единое оформление нескольких видео не предполагает одинаковой длительности субтитров. Быстрая речь или добавленная инструкция требуют иных интервалов. Сопоставление смены кадра, реплик и начала показа помогает определить необходимые правки.
6. Какие результаты полезно фиксировать разработчикам
Разделяйте входные данные, распознавание и отображение. Запишите выбранные дорожки и периоды одновременной речи, затем оцените пропущенные слова, начало и конец показа и достаточность времени для чтения.
Сравните распознавание сведённого звука с обработкой отдельных дорожек на одном видео. Для настройки времени включите короткие и длинные тексты, одновременное начало и отсутствие наложений. Фиксируйте необходимые исправления и трудозатраты редактора.
Для патентного обсуждения опишите критерии выбора дорожек, временные значения при сравнении соседних фрагментов и настройку читаемости после сокращения. Результаты изменения условий на одной шкале времени помогают конкретно объяснить технический вклад.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Учебные ситуации являются условными примерами. Публичное описание продукта само по себе не подтверждает осуществление конкретного пункта патентной формулы.
Справка CapCut по распознаванию субтитров
Распознавание речи iFLYTEK: как сопоставлять термины встречи со звуком
ИИ Samsung для аудио: интерфейс до завершения разделения звука
Изучите проекты IPLEX в области ИИ и материалы для обсуждения распознавания речи и управления временем субтитров.
Опыт патентного поверенного Ким Ёндока в области ИИ