언어 모델이 답변을 한 토큰씩 만들면, 다음 토큰을 고를 때마다 큰 모델의 계산을 기다립니다. 추측 디코딩은 작은 모델이 여러 토큰을 먼저 제안하고 큰 모델이 각 위치의 확률을 병렬로 계산해, 한 차례에 여러 토큰을 확정할 수 있게 합니다. 가상의 상담 챗봇과 T5-XXL 실험을 바탕으로 답변이 나올 확률을 유지하는 원리와 실제 속도가 달라지는 조건을 살펴봅니다.
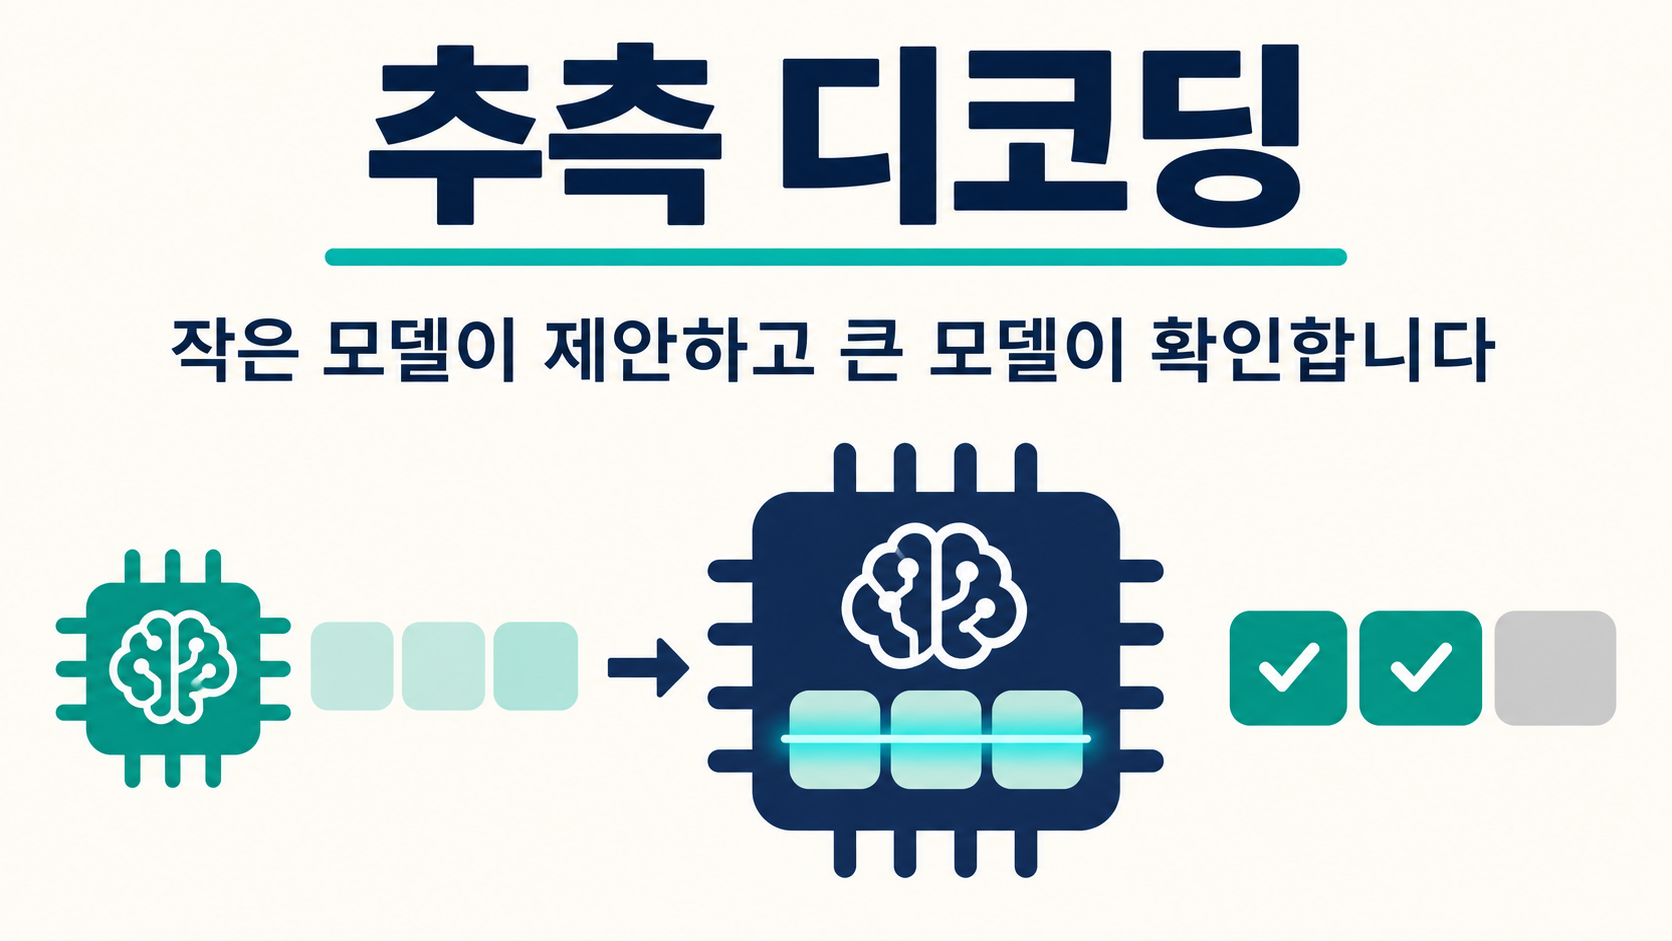
작은 모델의 초안과 큰 모델의 병렬 확인을 설명한 개념 그림입니다.
Yaniv Leviathan, Matan Kalman, Yossi Matias의 Fast Inference from Transformers via Speculative Decoding을 읽었습니다. 2022년 11월 30일 arXiv 최초 공개, ICML 2023 PMLR 최종본을 기준으로 설명합니다.
1. 답변이 한 토큰씩 나오는 이유
상담 챗봇에 질문을 넣으면 완성된 답변이 한꺼번에 나오기보다 글이 조금씩 나타납니다. 언어 모델은 이미 확정된 글을 읽고 그 뒤에 올 조각의 확률을 계산합니다. 그중 한 조각을 고르면, 그 결과를 포함해 다음 조각의 확률을 다시 계산합니다.
이 조각을 토큰이라고 합니다. 한 단어가 통째로 토큰이 될 수도 있고, 한 단어가 여러 토큰으로 나뉠 수도 있습니다. 모델이 다음 토큰을 고를 때 기준으로 삼는 앞부분은 접두사라고 부릅니다. 챗봇에서는 사용자가 입력한 내용과 이미 생성한 토큰이 다음 선택의 문맥이 됩니다.
큰 모델이 매번 다음 조각을 계산하는 동안 사용자는 기다립니다. 그렇다면 익숙한 답변의 다음 몇 조각을 작은 모델이 먼저 써 두고, 큰 모델이 한 번에 살펴볼 수 있을까요?
2. 작은 모델의 초안과 큰 모델의 병렬 확인
추측 디코딩에서 작은 모델은 초안 모델입니다. 큰 모델은 우리가 원래 답변 생성에 사용하려던 대상 모델입니다. 초안 모델은 현재 접두사 뒤에 토큰을 하나씩 덧붙여 여러 조각을 준비합니다.
가상의 상담 챗봇이 안내 문장을 쓰다가 초안 모델에서 A, B, C 세 토큰을 받았다고 해 보겠습니다. 대상 모델은 현재 접두사, A까지 붙인 접두사, A와 B를 붙인 접두사, A와 B와 C를 붙인 접두사 각각의 다음 토큰 확률을 병렬로 계산합니다. 초안이 있어서 네 가지 입력을 미리 구성할 수 있습니다.
채택 여부는 A부터 순서대로 판단합니다. A와 B를 채택하고 C에서 거절되면 A와 B를 확정하고, C 자리에서 보정된 확률에 따라 토큰 하나를 뽑습니다. C 뒤의 계산은 사용하지 않습니다. 초안을 모두 채택했고 생성이 계속된다면 대상 모델의 확률에서 그다음 토큰 하나를 더 뽑습니다.
이 순서와 조건은 논문 2.3절과 알고리즘 1에서 확인할 수 있습니다.
3. 출력 확률을 유지하는 채택과 보정
두 모델은 다음 토큰 후보에 서로 다른 확률을 줄 수 있습니다. 논문은 초안 모델이 제안한 토큰을 대상 모델이 기대하는 비율에 맞춰 채택합니다. 대상 모델의 확률이 초안 모델의 확률보다 작으면 두 확률의 비율만큼 채택하고, 그 이상이면 항상 채택합니다.
두 후보만 있다고 가정해 보면
가령 작은 모델이 A를 80%, B를 20%로 제안하고, 큰 모델은 A에 60%, B에 40%를 준다고 하겠습니다. A가 제안되면 60÷80인 75%만 채택합니다. 전체 시도에서 A가 확정되는 비율은 80%에 75%를 곱한 60%입니다.
B가 제안된 경우는 모두 채택합니다. A가 거절되는 20%의 경우에는 대상 모델에 아직 남은 확률이 B에 있으므로 B로 보정합니다. 처음부터 B가 제안된 20%와 보정으로 B가 된 20%를 더하면 대상 모델과 같은 40%가 됩니다.
여기서 보존하는 것은 같은 조건에서 각 답변이 나올 확률분포입니다. 확률을 따라 답을 뽑으면 여러 번 실행한 문장은 달라질 수 있습니다. 채택은 대상 모델의 생성 규칙에 따른 판단이며, 안내 내용의 사실 여부는 서비스에서 별도로 확인할 문제입니다.
논문은 채택과 보정을 합친 결과가 대상 모델의 분포와 일치함을 보입니다. 논문 부록 A.1
4. T5-XXL 실험에서 얼마나 빨라졌을까요?
연구진은 기존 T5 v1.1 체크포인트를 사용했습니다. 대상 모델은 T5-XXL 110억 파라미터, 아래 결과의 초안 모델은 T5-small 7,700만 파라미터입니다. TPU v4 한 개에서 한 번에 한 입력을 처리했고, 같은 대상 모델을 표준 T5X 방식으로 실행한 시간과 비교했습니다.
| 과제 | 초안 길이 | 확률 선택 · 온도 1 | 최고확률 선택 · 온도 0 |
|---|---|---|---|
| WMT 영어→독일어 번역 | 7개 | 2.6배 | 3.4배 |
| CNN/Daily Mail 요약 | 5개 | 2.3배 | 3.1배 |
예를 들어 번역에서 2.6배는 표준 방식의 소요 시간을 추측 디코딩의 소요 시간으로 나눈 값입니다. 확률을 따라 고르는 설정과 확률이 가장 큰 토큰을 고르는 설정에서 배율이 달랐습니다. 초록의 약 2~3배는 이런 실험 결과를 요약한 표현입니다.
모델 크기와 수치는 ICML 최종본 4.1절과 표 2를 기준으로 정리했습니다.
5. 실제 서비스에서 속도가 달라지는 조건
작은 모델이 만든 초안에서 앞부분을 길게 채택할수록 대상 모델을 차례로 기다리는 횟수가 줄어듭니다. 반대로 첫 토큰부터 자주 거절되면 그 뒤를 미리 계산한 결과는 쓰이지 않습니다. 초안 모델이 여러 조각을 만드는 시간도 한 차례의 비용에 들어갑니다.
병렬 계산을 동시에 진행할 여유가 있는 장치라면 기다리는 시간을 줄이면서도 수행한 연산의 양은 늘 수 있습니다. 초안 길이와 두 모델의 조합은 따로 비교해 볼 값입니다. 실험에서 더 큰 초안 모델을 쓸 때 채택률이 높아졌습니다. 실제 속도 개선 배율은 T5-small을 썼을 때 가장 높았습니다.
서비스를 설계할 때는 입력 길이와 동시 요청 수를 맞춰 비교해 보세요. 첫 토큰이 나올 때까지의 시간, 이후 토큰 사이의 간격, 일정 시간에 처리할 수 있는 요청 수를 따로 보면 어떤 대기가 줄었는지 알기 쉽습니다. 번역과 요약의 실험 배율은 해당 모델과 장치에서의 결과입니다.
6. 개발과 특허 검토에서 정리할 기술적 차이
개발팀이라면 초안의 길이, 처음 거절된 위치, 보정에 사용한 확률과 계산 시간을 구분해 기록할 수 있습니다. 같은 초안 모델을 쓰더라도 요청에 따라 초안 길이를 어떻게 정하는지, 거절 뒤에 계산 결과와 캐시를 어떻게 처리하는지에 따라 구현이 달라집니다.
아이피렉스의 특허 검토 관점
추측 디코딩을 적용했다고만 설명하면 기존 논문의 방법과 새 구현의 경계가 드러나기 어렵습니다. 해결하려는 병목과 이를 감지하는 입력, 초안 길이나 검토 단위를 바꾸는 조건, 변경 뒤 어떤 측정값이 달라졌는지를 함께 정리하면 기술적 차이를 구체적으로 설명할 수 있습니다. 이 부분은 논문의 실험 결과와 구분한 실무 관점입니다.
상담 챗봇과 두 후보는 이해를 돕기 위한 가상 예시입니다. 시간 수치는 논문의 특정 T5 실험 결과이며 일반적인 성능 보장이 아닙니다. 확률분포 유지가 답변 내용의 사실 정확성을 보장하지는 않습니다.
FlashAttention-2 논문 쉽게 읽기: 긴 글의 어텐션을 GPU에서 빠르게 계산하는 원리
PagedAttention 논문 쉽게 읽기: vLLM의 KV 캐시와 GPU 메모리 관리 원리
AI 구현의 작동 방식과 기술적 차이를 정리하시려면 아이피렉스의 AI 프로젝트와 상담 준비 자료를 살펴보세요.