
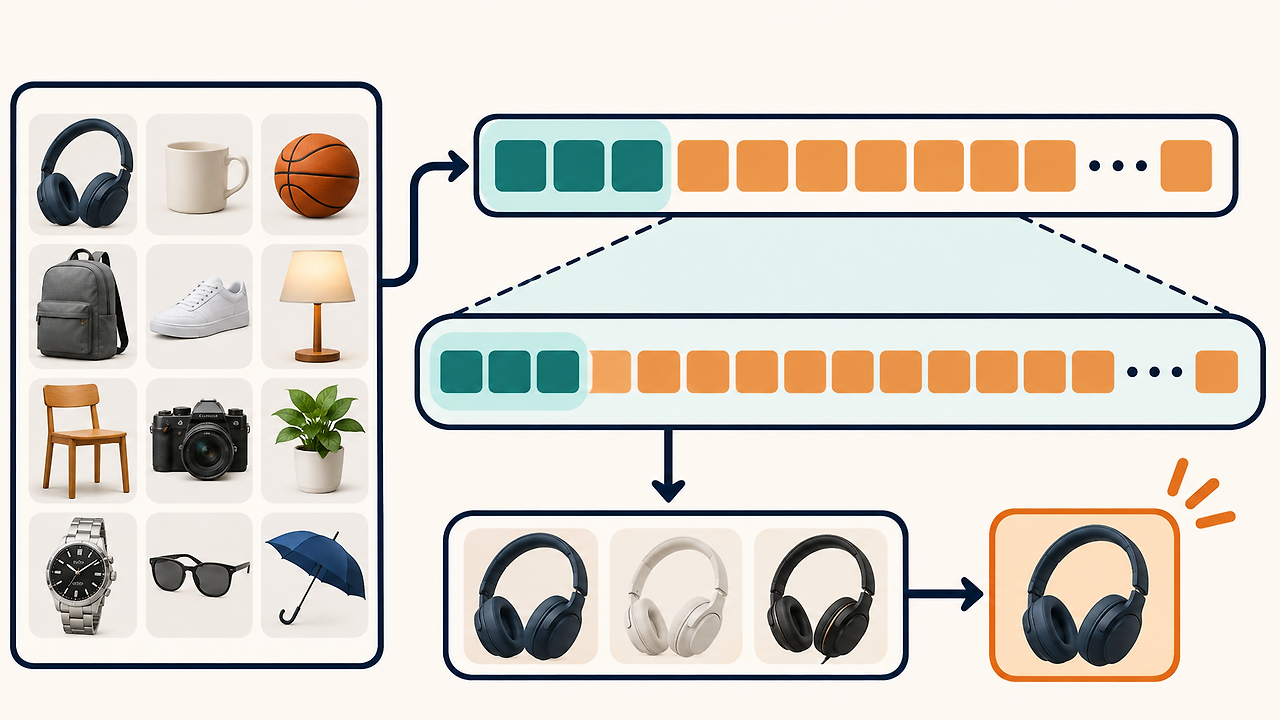
Подробное сравнение каждой фотографии товара со всем каталогом требует вычислений. Matryoshka Representation Learning одновременно обучает несколько длин префикса, чтобы даже короткая начальная часть эмбеддинга подходила для поиска. Условный каталог и эксперимент ImageNet-1K показывают, как сначала отобрать кандидатов, а затем упорядочить их по полным векторам.
1. Сколько чисел нужно для поиска фотографии
Представим фотографию синей чашки с ручкой, в имени которой указана только дата. Для поиска среди тысяч товаров нужно сравнивать содержание изображений. Но первичный отбор не обязательно должен подробно учитывать каждую ручку, кромку и узор.
Модель преобразует фотографию в числовой вектор — эмбеддинг. Число его компонентов называют размерностью. По расстоянию между векторами можно находить похожие изображения; при большом каталоге размерность влияет на стоимость повторяющихся сравнений.
Kusupati и соавторы представили Matryoshka Representation Learning на NeurIPS 2022. Метод позволяет брать префиксы разной длины из одного эмбеддинга: короткий для широкого отбора, длинный для более точного сравнения.
2. Несколько длин внутри одного выхода модели
В экспериментах с изображениями модель выдаёт 2 048 компонентов, а обучение охватывает первые 8, 16, 32 и другие количества координат. Векторы размерности 16 и 32 не вычисляются разными запусками: это начальные части одного выхода.
При обучении каждая заданная длина используется для предсказания класса и расчёта ошибки относительно правильной метки. Функции потерь объединяются для обновления общей модели. Поэтому качество короткого префикса влияет на обучение с самого начала.
Для классификации применяются классификаторы соответствующих размеров. В поиске сравнивают расстояния между обученными представлениями. При размерности 16 и у запроса, и у изображения каталога берут одинаковые первые 16 координат.
3. Сначала сузить список, затем уточнить порядок
Пусть условный каталог содержит бутылки, кружки, бумажные стаканы и чашки без ручек. Загруженное фото синей чашки кодируется, а каталог уже обработан той же моделью. На первом этапе сравниваются короткие префиксы и сохраняются близкие кандидаты.
На втором этапе расстояния рассчитываются заново по более длинным частям тех же векторов. Две синие чашки могут поменяться местами, когда учитываются более тонкие различия. Пример не предполагает, что отдельная координата отвечает за конкретный цвет или деталь.
Первый этап сокращает множество, второй уточняет его ранжирование. Если нужная чашка не попала в список, повторное ранжирование её не вернёт. Поэтому размер списка выбирают с учётом качества и вычислительных затрат.
4. Результаты на ImageNet-1K
Исследователи использовали представления ResNet50, чтобы искать изображения того же класса, что и запрос, в ImageNet-1K. В одном варианте первые 16 координат отбирали 200 кандидатов, которые затем упорядочивались по всем 2 048 координатам. Таблицы 8 и 11 официального приложения содержат результаты точного поиска по расстоянию.
Для одних и тех же MRL-представлений полный поиск по 2 048 координатам дал mAP@10 65,20 %, а отбор по 16 с последующим полным ранжированием — 65,27 %. Метрика обобщает положение релевантных изображений в первой десятке по нескольким запросам. Близкие значения означают сопоставимое качество именно в этих условиях.
Соответствующие затраты на поиск составили 2 624 и 21 MFLOPs на запрос. MFLOPs обозначает миллионы операций с плавающей точкой. Эти значения не равны полной задержке для пользователя: в неё также входят получение эмбеддинга и обращение к хранилищу.
5. Выбор размерности и количества кандидатов
Чем короче префикс, тем меньше координат сравнивается для каждой фотографии. Однако при похожих товарах можно потерять нужного кандидата. Для более сложного ImageNet-4K в статье рассматривается первый этап с 64 измерениями. Размерность 16 и список из 200 — параметры конкретного эксперимента.
Критерий релевантности зависит от задачи. Для поиска категории может подойти та же чашка другого цвета; при определении SKU нужно отличать другой товар с похожей ручкой или узором. Задав критерий заранее, проще увидеть, где изменение параметров ухудшает результат.
Для повторного ранжирования необходим доступ к длинным векторам кандидатов. Размер индекса коротких векторов и размещение полных представлений — разные проектные решения. Вычисления, задержку чтения и объём хранения полезно учитывать отдельно.
6. Какие сравнения сохранять при разработке
На одном каталоге сравните поиск по полным векторам с отбором по префиксам. Сначала отметьте, сохранился ли релевантный кандидат, затем — его место после повторного ранжирования. Так можно разделить пропуски первого этапа и ошибки порядка на втором.
Добавьте изменение освещения, обрезанные изображения и другие ракурсы. Результаты на чистых фотографиях могут отличаться от пользовательских. Помимо средней задержки, изучите условия медленных запросов, прежде чем менять число кандидатов или способ чтения векторов.
Для патентного обсуждения свяжите длины, оцениваемые при обучении, правило отбора и информацию, повторно используемую при втором сравнении. Контролируемые результаты на одном каталоге помогут отдельно объяснить эффект обучения представлений и архитектуры поиска.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Каталог товаров — условный пример. Показатели качества и вычислений относятся к эксперименту статьи и не гарантируют работу конкретного сервиса.
Страница Matryoshka Representation Learning на NeurIPS 2022
Окончательная статья NeurIPS 2022
Официальное приложение с таблицами 8 и 11
Lost in the Middle: почему важно положение документа с ответом
Изучите проекты IPLEX в области ИИ и материалы для обсуждения эмбеддингов и процессов поиска.
Опыт патентного поверенного Ким Ёндока в области ИИ