
Длинная последовательность увеличивает нагрузку на память
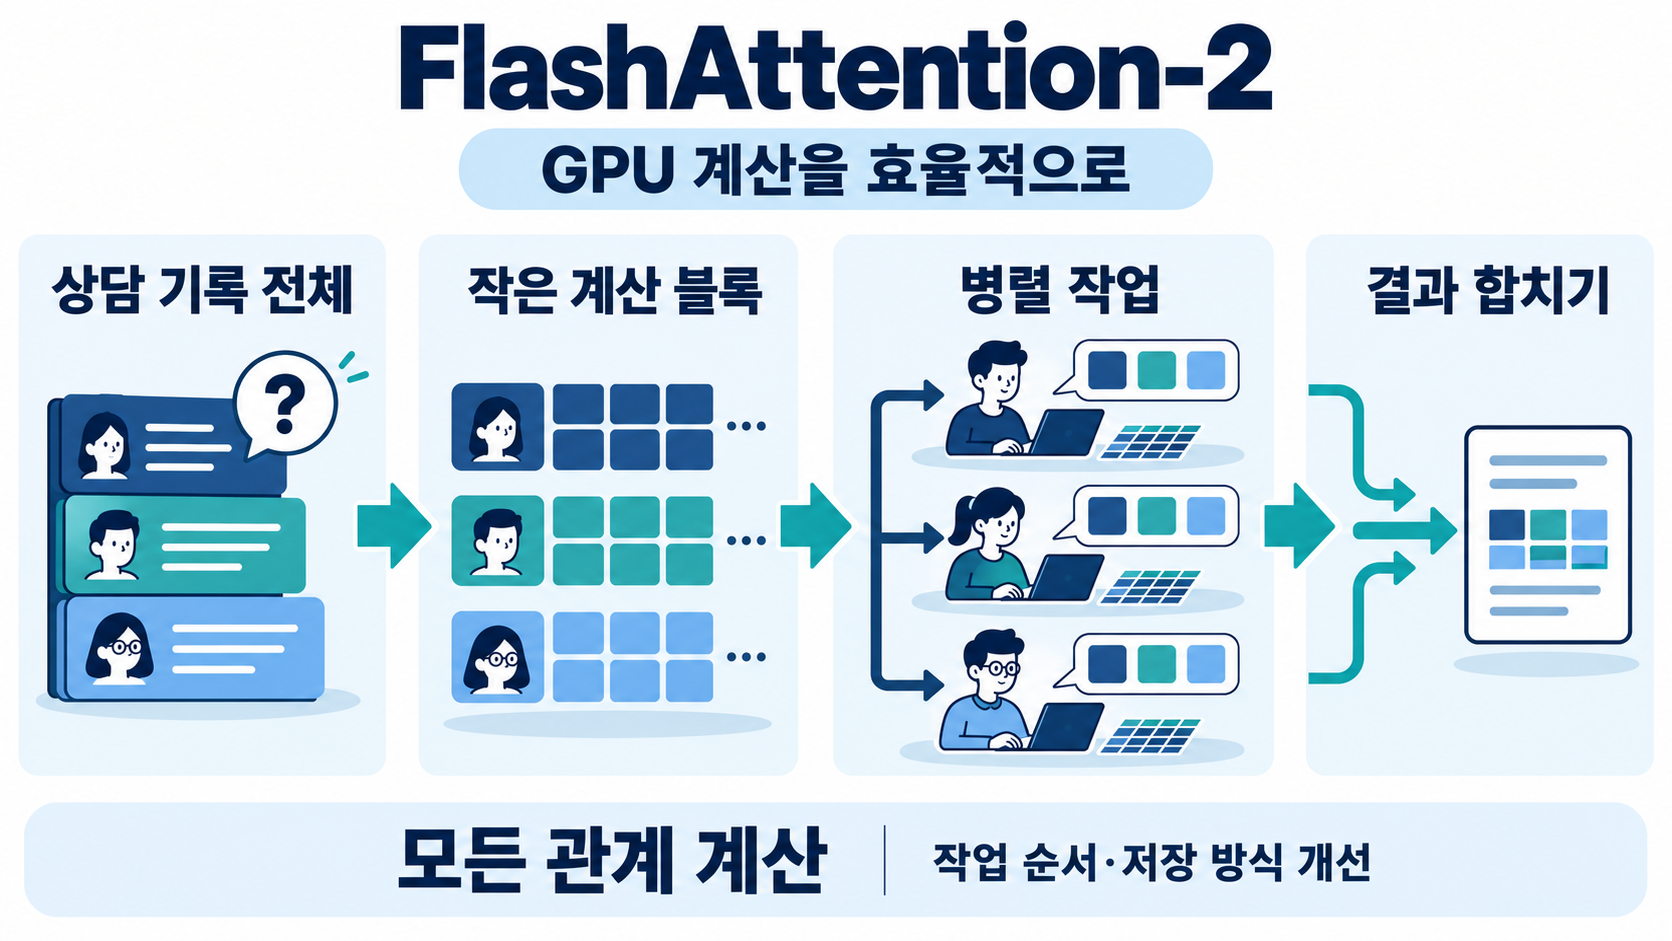
Работа Tri Dao о FlashAttention-2, впервые поданная в arXiv 17 июля 2023 года, посвящена выполнению внимания на GPU. Токены — единицы, на которые модель делит текст. Механизм внимания сравнивает их представления и определяет веса информации. Обычная реализация сохраняет большие матрицы оценок и вероятностей; с ростом последовательности увеличиваются затраты памяти и объём передач данных.
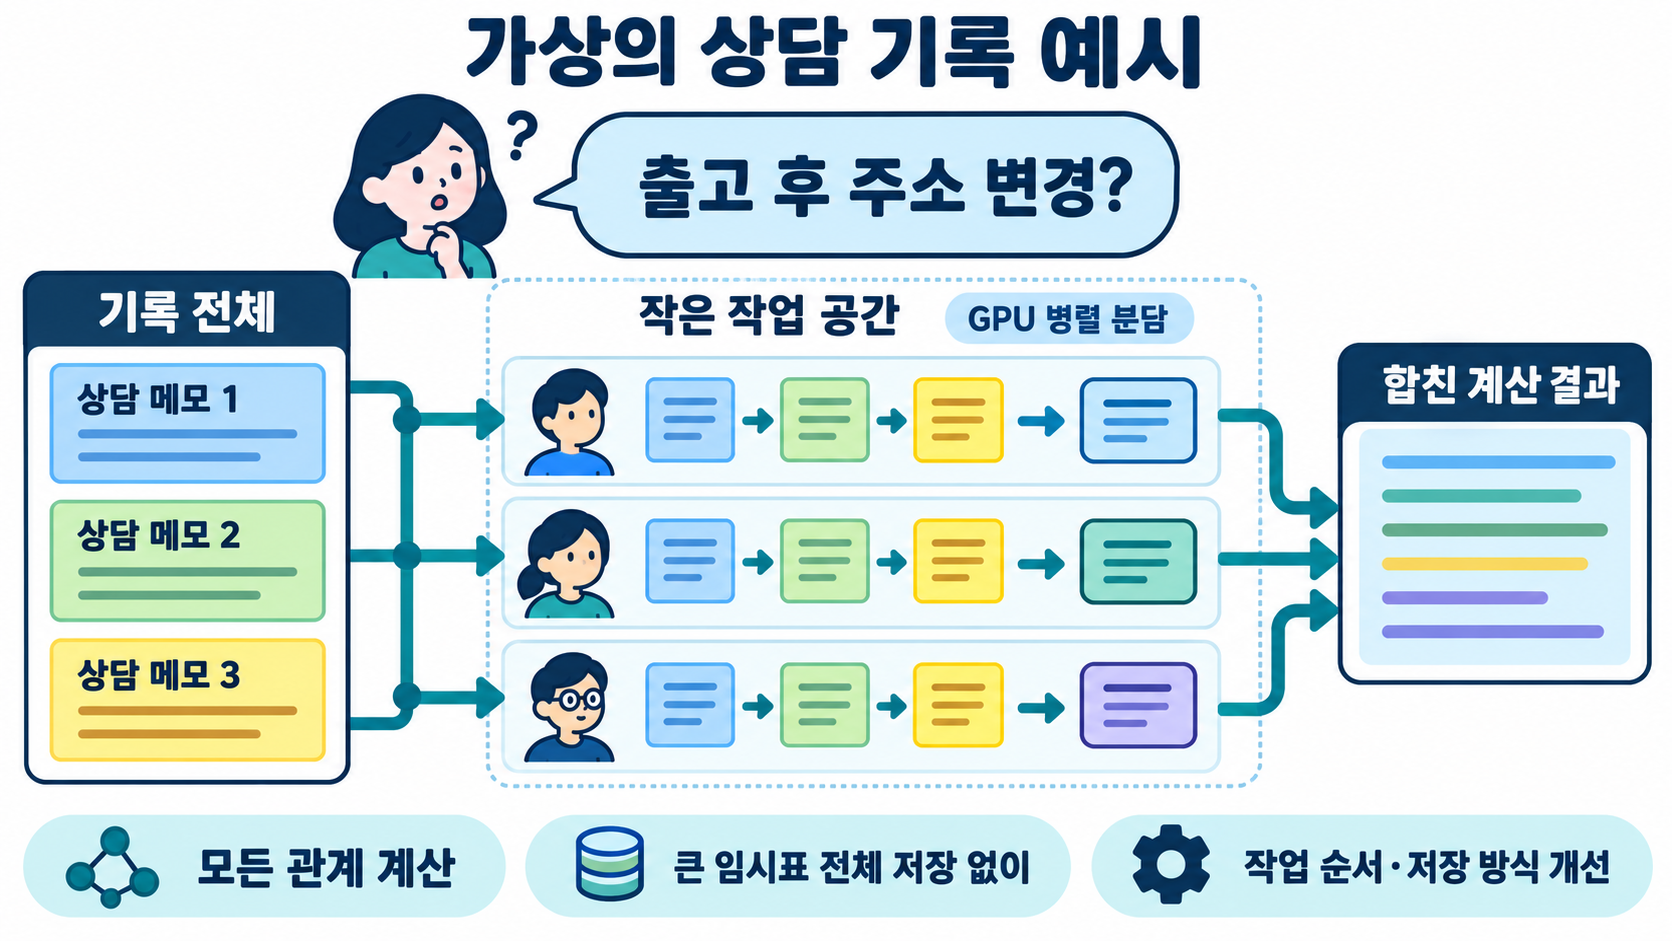
Представим условную службу поддержки: по длинной переписке нужно понять, можно ли изменить адрес уже отправленного заказа. Это учебный пример, а не эксперимент статьи или результат реального сервиса. Высокая вычислительная мощность GPU мало помогает, если его блоки значительную часть времени ожидают данные.
Блочная обработка сохраняет общую нормализацию
Разбиение входов на блоки, вычисления в быстрой памяти на кристалле и отказ от хранения полных промежуточных матриц в HBM были заложены ещё в исходном FlashAttention. Потоковое вычисление softmax обновляет статистики и частичные выходы с изменением масштаба, сохраняя нормализацию по всей последовательности. Независимая нормализация каждого блока с последующим сложением дала бы другой результат.
В примере с перепиской небольшие группы заметок обрабатываются на ограниченном рабочем столе, а промежуточная сводка обновляется. Реальная модель вычисляет числовые представления токенов, а не человеческие оценки на иллюстрации. Алгоритм сохраняет точное внимание, но порядок операций с плавающей точкой может давать небольшие численные расхождения. Поэтому выходы и градиенты проверяют с допусками, а не на побитовую идентичность.
Три способа повысить загрузку GPU
Во-первых, сокращаются операции вне матричного умножения: часть пересчётов масштаба, проверок границ и обработки причинной маски. Это позволяет полнее использовать быстрые матричные блоки. Во-вторых, задачи распределяются не только по пакетам и головам внимания, но и по длине последовательности. При длинных входах и малом размере пакета больше вычислительных блоков получают работу.
В-третьих, при прямом проходе запросы Q распределяются между варпами, а ключи K и значения V используются совместно. Каждый варп вычисляет свою часть выхода, что уменьшает обмен и объединение промежуточных результатов через общую память. Существенны не только формулы, но и планирование задач и перемещение данных.
Как понимать заявленное ускорение
В тестах ядра внимания на A100 80GB SXM4 автор сообщает примерно двукратное ускорение относительно FlashAttention. Проверялись длины от 512 до примерно 16k токенов, размерности голов 64 и 128, варианты с причинной маской и без неё; общее число токенов в пакете сохранялось на уровне 16k. Эти измерения относятся именно к вычислению внимания.
В отдельных экспериментах полного обучения GPT на восьми A100 80GB SXM4 ускорение достигало примерно 1,3 раза. Использовались модели на 1,3 и 2,7 млрд параметров с контекстом около 2k и 8k токенов. Остальные вычисления и коммуникации сохраняются, поэтому результат нельзя переносить на задержку любого чат-бота. Арифметическая сложность по-прежнему квадратична по длине последовательности, а экономия памяти сама по себе не доказывает повышение точности понимания.
Какие различия фиксировать в технических материалах
Сравнивайте одну модель на одинаковых входах, указывая GPU, длину последовательности, размер пакета, расход памяти и время. Отдельно измеряйте первоначальную обработку контекста, или prefill, и последующую генерацию по токенам: узкие места могут различаться. Сохранённые исходные рисунки служат концептуальными иллюстрациями.
Следует показать, какие матрицы больше не записываются в память, где разделяется работа и как уменьшается обмен промежуточными данными. Схемы и контролируемые сравнения делают технический эффект проверяемым. IPLEX анализирует конкретное устройство и результаты реализации при работе с ИИ-изобретениями; один лишь более быстрый тест не подтверждает патентоспособность.