안녕하세요. 아이피렉스 특허법률사무소, 김용덕 변리사입니다.
같은 단어라도 앞뒤 문맥에 따라 가리키는 대상이 달라집니다. 인공지능이 대화 기록을 압축해서 기억할 때도 이 차이를 보존해야 합니다. 하나의 기억 장치에 여러 문맥을 섞어 넣으면, 필요한 정보를 꺼내는 순간 서로 다른 연결이 간섭할 수 있습니다.
이번에 살펴볼 Switching Linear Attention, 줄여서 SwiLA는 고정된 크기의 기억을 여러 선형 회귀 모형으로 나누고, 입력과 기존 기억의 관계에 따라 갱신 비중을 조절하는 방법입니다. 기억 공간을 무한히 늘리지 않으면서 정보를 읽어 내는 함수를 더 풍부하게 만드는 것이 핵심입니다.
1. 논문 기본 정보
논문명은 Switching Linear Attention입니다. 실제 논문 저자는 Hyun Dong Lee, Xavier Gonzalez, Nicolas Zucchet, E. Kelly Buchanan, Emily B. Fox, Scott W. Linderman입니다. 논문에 기재된 소속은 Stanford University이며, Xavier Gonzalez는 연구 당시 Stanford 소속이고 현재 Unconventional AI에 있다는 각주가 있습니다.
분석 대상은 2026년 9월 30일 공개된 arXiv:2609.39034v1입니다. DOI는 10.48550/arXiv.2609.39034입니다. 원문 PDF에는 COLM 2026 학회 논문으로 게재되었다고 명시되어 있습니다. 이 글의 수치와 도표는 해당 v1을 기준으로 설명합니다.
원문은 CC BY 4.0으로 공개되어 있습니다. 아래 도표의 출처는 Lee 외, Switching Linear Attention, 2026이며, 해당 그림과 표 번호를 캡션에 표시합니다. 해설 글의 작성자와 실제 논문 연구진은 구분합니다.
2. 왜 기억을 읽는 방식이 문제가 될까
전체 기록을 보관하는 방식과 압축된 상태
일반적인 소프트맥스 어텐션은 과거 토큰의 키와 값을 KV 캐시에 보관합니다. 질문에 해당하는 쿼리와 각 키의 관계를 계산해 필요한 값을 조합하므로 유연하지만, 문맥이 길어질수록 보관해야 하는 캐시도 커집니다.
선형 어텐션 계열은 과거 정보를 고정 크기의 상태 행렬에 누적합니다. 과거 기록을 매번 전부 펼치지 않고 요약 장부에서 답을 읽는 셈입니다. 다만 하나의 선형 변환으로 쿼리를 값에 연결하면 문맥마다 다른 대응 관계를 표현하는 데 한계가 생깁니다.
예를 들어 인명 “Harry”를 음악가에 관한 문단에서 읽을 때와 소설 속 마법사에 관한 문단에서 읽을 때 필요한 연결은 다릅니다. SwiLA는 이처럼 같은 단서가 문맥에 따라 다른 값으로 이어지는 상황을 여러 회귀 모형의 혼합으로 다룹니다.
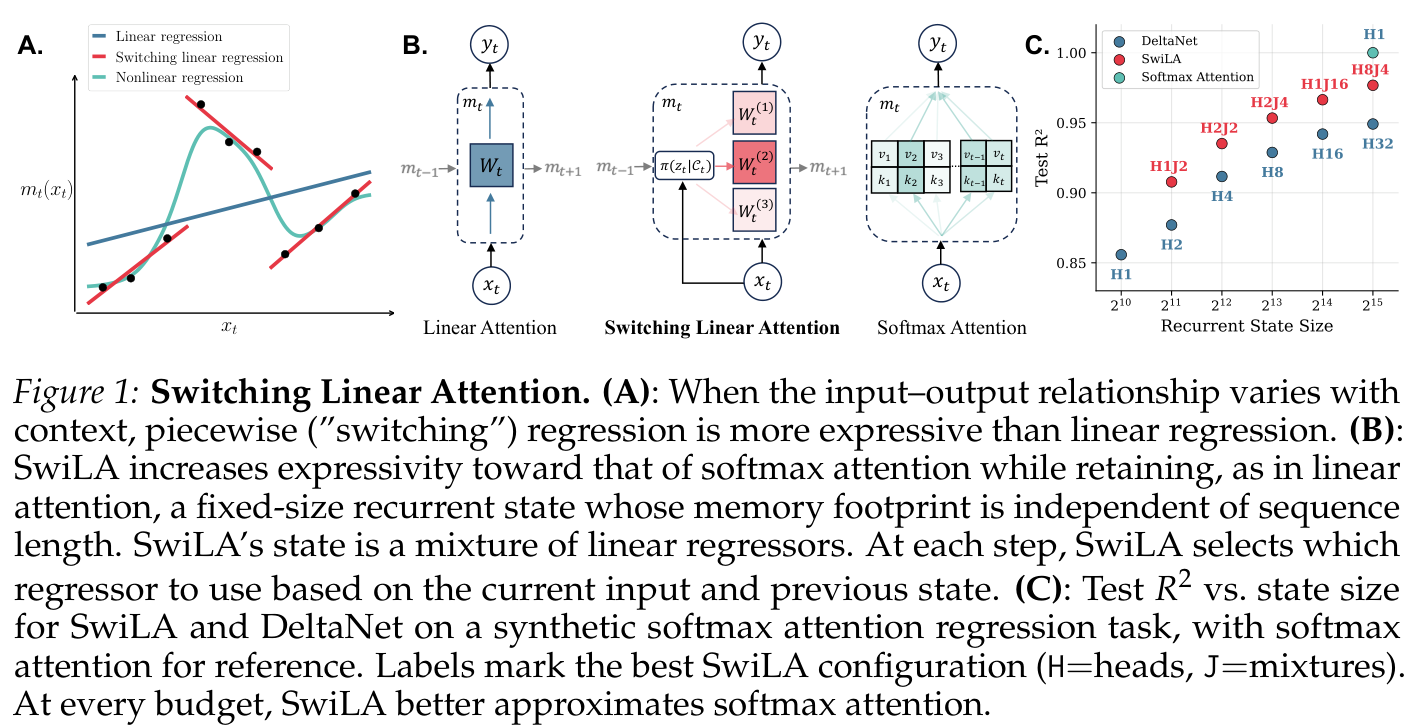
그림 1. 원문 Figure 1. 선형·조각별 회귀의 차이, SwiLA의 상태 구조, 소프트맥스 어텐션 근사 실험을 함께 보여 줍니다. 오른쪽 그래프는 합성 과제의 테스트 R²이며 실제 언어모델 정확도와는 다른 지표입니다. 출처: Lee 외, 2026, CC BY 4.0.
3. 핵심 아이디어는 여러 회귀 모형의 혼합
테스트 시점 회귀로 바라보는 기억
연구진은 기억 저장을 키에서 값으로 가는 함수를 학습하는 회귀 문제로, 기억 검색을 그 함수에 쿼리를 넣는 과정으로 설명합니다. 이를 테스트 시점 회귀, TTR이라고 부릅니다. 토큰을 읽으면서 바뀌는 것은 문맥 안의 빠른 가중치 상태이며, 매번 언어모델 전체를 새로 학습한다는 뜻은 아닙니다.
DeltaNet의 기본적인 기억 읽기는 하나의 상태 행렬 W에 쿼리 q를 곱하는 형태입니다. SwiLA는 이 상태를 J개의 선형 회귀 성분으로 나누고, 각 출력 차원마다 성분을 조합하는 비중을 다르게 둡니다. 작은 전문 장부 여러 개를 두고 질문에 맞게 읽기 비중을 바꾸는 것에 가깝습니다.
출력은 각 성분의 예측에 쿼리 쪽 혼합 비중을 곱해 더한 값입니다. 따라서 “스위칭”이라는 이름이 항상 전문가 한 개만 골라 사용하는 하드 라우팅을 뜻하지는 않습니다. 입력별 혼합 비중이 달라지므로 전체 검색 함수는 단일 선형 변환보다 풍부해집니다.
출력 차원의 수가 D이면 조합 가능한 성분 선택 양상은 J의 D제곱으로 늘지만, 실제 저장하는 가중치 수는 J×D² 규모입니다. 가능한 조합의 수와 실제 기억 용량을 혼동하면 안 됩니다. 고정된 상태에 모든 과거 정보를 손실 없이 담는다는 주장은 아닙니다.
4. 한 토큰을 처리하는 실제 단계
예측 오차를 이용해 갱신 비중을 결정한다
첫째, 입력 토큰에서 쿼리·키·값과 혼합 비중을 계산합니다. 둘째, 각 회귀 성분이 현재 키에 대해 어떤 값을 예측하는지 기존 상태로 계산하고, 실제 값과의 차이를 구합니다. 이것이 예측 오차입니다.
셋째, 입력에서 얻은 사전 비중과 각 성분의 예측 오차를 함께 이용해 책임도(responsibility)를 정합니다. 같은 입력이라도 기존 기억이 무엇을 담고 있는지에 따라 책임도가 달라질 수 있습니다. 입력만 보고 분배하는 라우터와 구별되는 지점입니다.
넷째, 각 성분의 빠른 가중치를 “학습률 × 책임도 × 예측 오차 × 키”에 비례해 갱신합니다. 다섯째, 갱신한 여러 성분에 쿼리를 적용하고 쿼리 쪽 비중으로 합산해 출력을 만듭니다. 연구진은 이 흐름을 선형 회귀 혼합 모형에 대한 온라인 EM에서 유도합니다.
여기서 EM은 숨은 성분의 소속 확률을 추정하고 모형을 갱신하는 관점입니다. 논문 구현은 토큰마다 수렴할 때까지 긴 최적화를 반복하는 방식이 아니라, 빠른 가중치에 대한 한 단계 확률적 경사 갱신으로 재귀식을 구성합니다.
5. 문맥 유지와 망각을 더하는 구성
Temporal SwiLA와 Gated SwiLA
Temporal SwiLA는 문맥이 연속된 토큰에 걸쳐 유지된다는 점을 반영합니다. 이전의 성분 확률 분포와 현재 입력에서 얻은 분포를 섞어 다음 시점으로 전달합니다. 이는 은닉 마르코프 모형 필터링을 계산하기 쉽게 근사한 구성으로, 문단 중간에서 문맥 단서가 반복되지 않아도 선택 경향이 이어지게 합니다.
Gated SwiLA는 오래된 상태를 입력에 따라 감쇠시키는 망각 게이트를 둡니다. 논문은 책임도를 계산하기 전과 후에 감쇠를 적용하는 두 식을 구별하며, 실제 Gated SwiLA에는 감쇠한 상태에서 예측 오차와 책임도를 계산하는 식을 사용합니다.
혼합 성분을 여러 개 만들어도 일부 성분에만 갱신이 몰리면 나머지는 활용되지 않습니다. 연구진은 성분 전체의 균형 있는 활용과 토큰별 전문화를 함께 유도하는 보조 손실을 제시합니다. 입력 의존 잡음도 설명하지만, 374M 언어모델 본 실험에서는 라우터와 시간 게이트의 잡음을 끕니다. 제안한 모든 기법이 모든 실험에 동시에 적용된 것은 아닙니다.
6. 합성 실험에서 확인한 효과
같은 키가 문맥마다 다른 값을 가리키는 과제
소프트맥스 근사 실험은 차원 32, 길이 512의 합성 시퀀스로 진행합니다. 학습 65,536개와 테스트 2,048개를 사용하고, 같은 순환 상태 예산에서 DeltaNet과 비교합니다. 각 예산에서 가장 좋은 SwiLA 구성이 더 높은 테스트 R²를 보였습니다. 이는 특정 합성 입력과 예산 탐색에서의 결과이며 모든 입력에 대한 동등한 근사를 보장하지는 않습니다.
문맥 의존 연상 회상(CDAR) 과제는 4개 문맥마다 32개 키·값 쌍, 총 128개 연결을 제시합니다. 문맥별로 같은 키의 값이 달라지고 문맥 토큰이 계속 반복되지 않으므로, 대응 관계와 현재 문맥을 함께 유지해야 합니다. 시퀀스 길이는 1,024입니다.
Figure 2A에서 Temporal SwiLA는 헤드 1개, 차원 32, 혼합 성분 4개, 상태 크기 4,096으로 거의 완벽한 정확도에 도달한 가장 작은 구성입니다. 다만 이 그래프는 학습률과 랜덤 시드 탐색에서 얻은 최고 정확도를 보고합니다. 평균적인 학습 안정성이나 실제 서비스 성공률로 읽으면 안 됩니다.
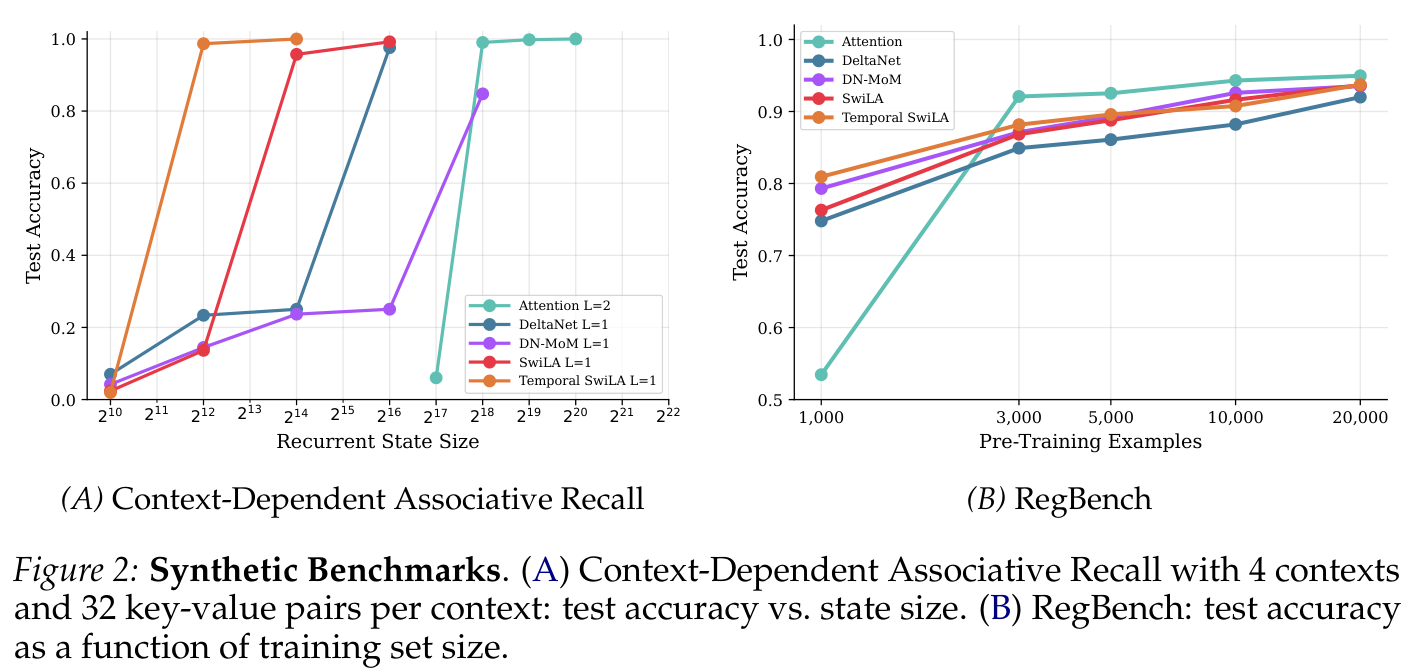
그림 2. 원문 Figure 2. 왼쪽은 CDAR의 상태 크기별 정확도, 오른쪽은 RegBench의 사전학습 예제 수별 정확도입니다. 두 그래프는 서로 다른 합성 과제이며, 비교 모델의 층 수 등 조건도 구별해야 합니다. 출처: Lee 외, 2026, CC BY 4.0.
RegBench는 무작위 확률적 유한 오토마타가 만든 예제 문자열을 보고 다음 토큰 분포를 문맥 안에서 학습하는 과제입니다. 8층 모델들을 비교하고, 순환 모델의 층별 상태는 16,384로 맞췄습니다. 적은 학습 데이터 구간에서는 Temporal SwiLA와 DN-MoM이 강했지만, 데이터가 늘어나면 Transformer가 가장 높은 정확도에 도달합니다. SwiLA가 모든 데이터 구간에서 앞선다는 결과는 아닙니다.
7. 언어모델 결과는 어디까지 좋아졌나
모델 크기와 학습 조건을 맞춘 비교
본 언어모델 비교는 약 3억 7,400만(374M) 파라미터, 24층, 은닉 차원 1,024의 모델을 FineWeb-Edu 약 150억(15B) 토큰으로 학습한 실험입니다. 학습 시퀀스 길이는 4,096이고 H100 GPU 8개를 사용합니다. 모델별 총 파라미터 수를 맞추기 위해 피드포워드 중간 차원을 조금씩 조정했습니다.
SwiLA 계열은 헤드 8개·헤드당 혼합 성분 4개·키와 값 차원 64를 사용해 층별 주 상태가 131,072개 스칼라입니다. DeltaNet·GDN·KDA도 같은 주 상태 수로 맞췄습니다. 다만 주 상태 크기를 맞췄다는 사실이 전체 실행 메모리와 연산량까지 동일하다는 의미는 아닙니다.
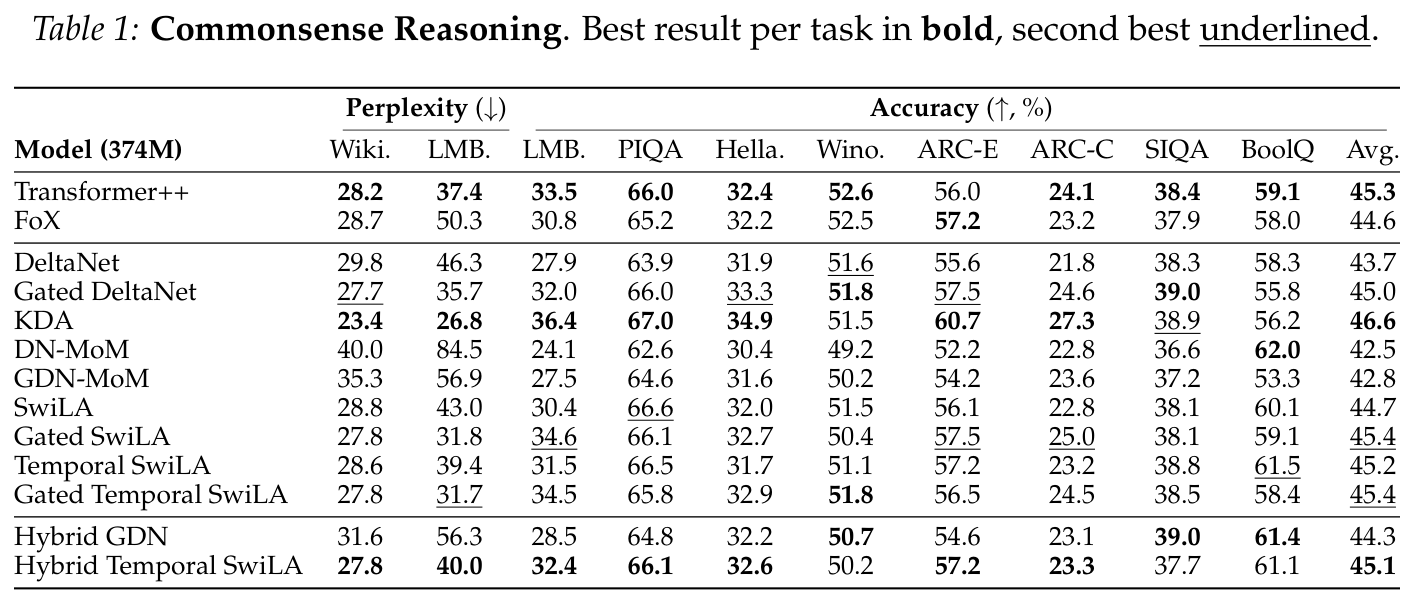
표 1. 원문 Table 1. 374M 모델의 퍼플렉시티와 상식 추론 정확도입니다. 퍼플렉시티는 낮을수록, 정확도는 높을수록 좋습니다. 여러 지표를 한 가지 점수처럼 섞어 읽지 않아야 합니다. 출처: Lee 외, 2026, CC BY 4.0.
상식 추론 평균 정확도는 Transformer++ 45.3%, DeltaNet 43.7%, Gated DeltaNet 45.0%, KDA 46.6%입니다. SwiLA는 44.7%, Gated SwiLA와 Gated Temporal SwiLA는 각각 45.4%입니다. 게이트를 둔 변형이 Transformer++보다 0.1%포인트 높지만, KDA가 더 높습니다. 이 작은 차이를 통계적으로 확정적인 우위나 대규모 모델 전반의 우위로 확대할 근거는 제시되지 않습니다.
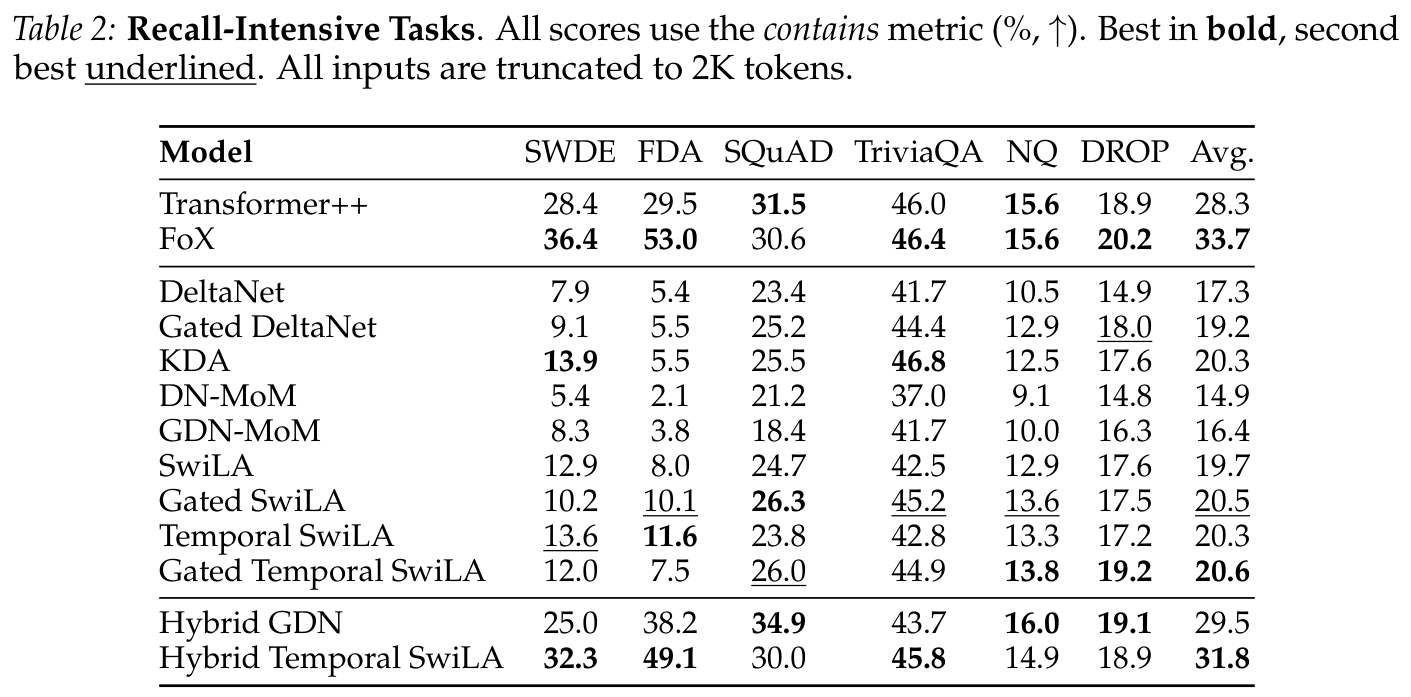
표 2. 원문 Table 2. 정보 회상 중심 6개 과제의 contains 점수이며 입력을 2K 토큰으로 잘랐습니다. 일반적인 모든 질의응답 정확도를 뜻하는 지표는 아닙니다. 출처: Lee 외, 2026, CC BY 4.0.
회상 과제 평균은 DeltaNet 17.3%, Gated DeltaNet 19.2%, KDA 20.3%, Gated Temporal SwiLA 20.6%입니다. Transformer++는 28.3%, FoX는 33.7%로 여전히 상당한 격차가 있습니다. 고정 상태 안에서 회상이 개선되었다는 결과와 전체 KV 캐시를 보관하는 모델을 완전히 대체했다는 주장은 구분해야 합니다.
순환 층 3개마다 소프트맥스 어텐션 층 1개를 섞은 Hybrid Temporal SwiLA는 31.8%를 기록해 Hybrid GDN의 29.5%와 Transformer++의 28.3%를 넘습니다. 그러나 이 혼합 모델에는 전체 어텐션 층의 KV 캐시가 남습니다. 순수 SwiLA의 고정 상태 특성을 혼합 모델 전체에 그대로 적용할 수는 없습니다.
8. 속도 향상에는 어떤 조건이 붙을까
학습 속도와 추론 처리량은 다른 문제
처리량 실험은 앞의 정확도 실험과 달리 13억(1.3B) 파라미터 모델을 H100 GPU 1개에서 측정합니다. 학습은 시퀀스 길이 2K·4K·8K·16K에 따라 배치 크기를 64·32·16·8로 조절해 업데이트당 토큰 수를 131,072로 유지합니다. 순전파뿐 아니라 역전파·경사 클리핑·AdamW 갱신까지 시간에 포함합니다.
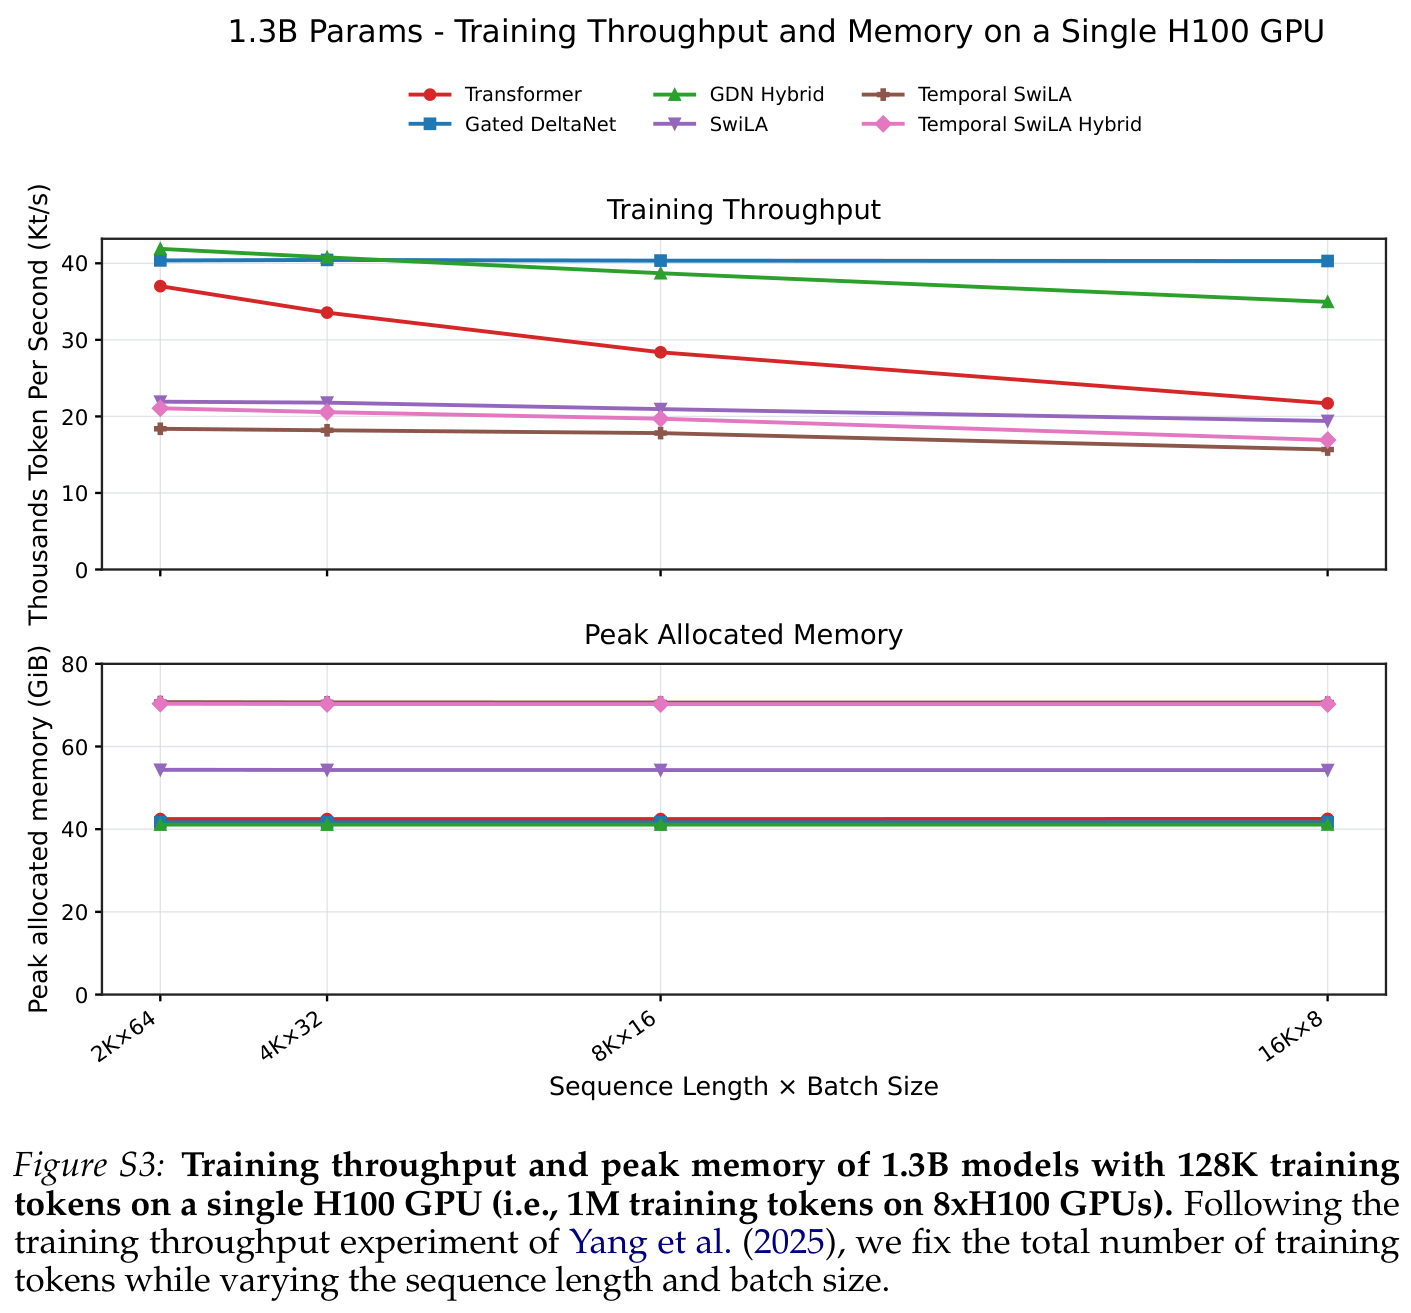
그림 3. 원문 Figure S3. 같은 업데이트당 토큰 수에서 학습 처리량과 최대 할당 메모리를 비교합니다. 고정 크기 상태를 사용해도 학습이 항상 더 빠르거나 전체 메모리가 더 적은 것은 아닙니다. 출처: Lee 외, 2026, CC BY 4.0.
추론은 합성 프롬프트 2,048토큰에서 128토큰을 탐욕적으로 생성하고, 배치 크기를 1에서 128까지 늘립니다. 프리필과 디코딩을 모두 포함한 전체 생성 시간을 측정합니다. 메모리 부족이 발생한 배치 이상은 제외합니다.
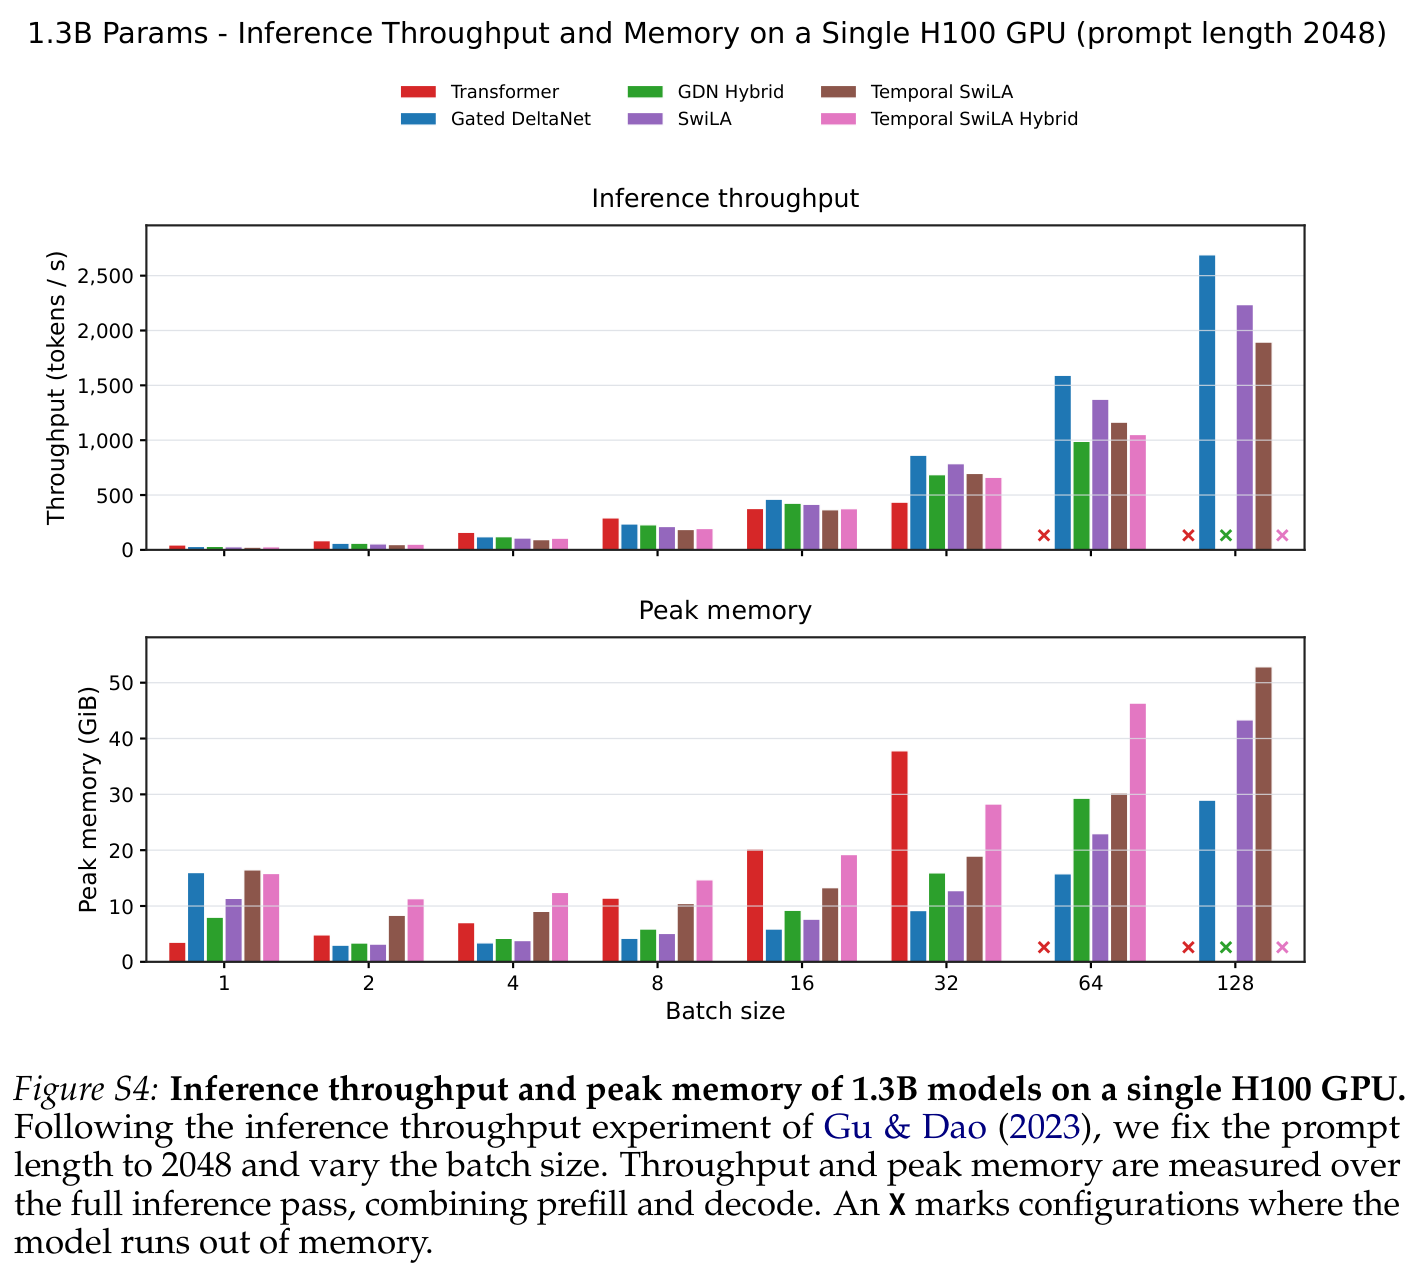
그림 4. 원문 Figure S4. 배치 크기별 전체 추론 처리량과 최대 메모리입니다. X는 메모리 부족을 나타냅니다. 단일 요청의 응답 지연과 대량 배치의 처리량은 구별해서 해석해야 합니다. 출처: Lee 외, 2026, CC BY 4.0.
연구진은 SwiLA가 Transformer 대비 4~5배 높은 전체 추론 처리량을 보였다고 요약합니다. KV 캐시 없이 더 큰 배치를 수용할 수 있는 효과가 포함된 결과입니다. 모든 배치에서 4~5배 빠르다거나 사용자 한 명의 답변이 그만큼 빨라진다는 뜻은 아닙니다. 반면 GDN과 비교하면 학습은 약 2배 느리고, 추론은 약 1.25~1.5배 느리며 메모리 사용도 더 큽니다.
9. 남아 있는 한계와 적용 조건
첫째, 기억의 크기는 여전히 고정되어 있습니다. 문맥이 길어진다고 저장 용량이 함께 늘어나지 않으므로 정보 간섭과 용량 한계가 사라지지 않습니다. 특히 원문 회상 평가는 입력 2K 토큰이라는 범위를 명시하므로 초장문 문서에서의 정확성을 이 결과만으로 단정하기 어렵습니다.
둘째, 기존 상태에 따라 책임도가 달라지는 비선형 재귀는 병렬 학습을 어렵게 합니다. 논문 실험은 빠른 순차 Triton 커널을 사용합니다. 부록에는 뉴턴 반복과 청크 단위 병렬화 방법을 제안하지만, 그 최적화가 이미 본 실험에서 학습 속도 문제를 해결했다고 쓰면 안 됩니다.
셋째, 전문가 수를 늘리는 것만으로 성능이 좋아지지 않습니다. 별도의 115M·5B 토큰 절제 실험에서, 같은 상태 예산으로 성분 수를 4개에서 16개로 늘리면 각 성분의 투영 차원이 줄어 성능이 조금 나빠졌습니다. 성분의 수와 성분 하나의 표현 용량 사이에 균형이 필요합니다.
넷째, 기본 SwiLA에는 전문가 붕괴 문제가 있습니다. 보조 손실이 없는 구성의 테스트 퍼플렉시티 36.769는 보조 손실을 둔 구성에서 16.807로 낮아집니다. Temporal SwiLA는 각각 16.718과 16.715로 차이가 작았습니다. 이는 해당 절제 실험의 결과이며, 본 실험의 374M 성능과 섞어 비교하지 않아야 합니다.
10. 변리사 관점에서 보는 기술적 차별점
기술적 과제는 제한된 순환 상태 안에서 문맥에 따라 다른 키·값 연결을 더 정확하게 유지하고 읽는 것입니다. 해결수단은 선형 회귀 성분의 혼합, 출력 차원별 비중, 기존 상태의 예측 오차를 반영한 책임도, 그리고 그 책임도를 이용한 상태 갱신의 결합으로 정리할 수 있습니다.
기존의 입력 기반 메모리 선택과 비교할 때, SwiLA는 “현재 기억이 이 입력을 얼마나 잘 설명하는가”를 분배 과정에 반영합니다. Temporal 구성은 문맥의 지속성을, Gated 구성은 기억의 감쇠를 각각 더합니다. 각 구성의 역할과 결합 관계를 구별해야 기술의 차이를 정확하게 설명할 수 있습니다.
확인된 효과는 특정 상태 예산에서의 합성 과제 성능과 374M 실험의 회상 개선입니다. 동시에 학습·추론 비용 증가와 전체 어텐션 대비 남은 회상 격차가 있습니다. 제 해석으로는 이 논문의 가치가 메모리 분할 자체보다, 기억의 갱신 규칙과 검색 함수를 일관된 확률 모형에서 함께 설계했다는 데 있습니다. 이는 기술 구조에 관한 해설이며 특허성이나 침해 여부를 판단한 것은 아닙니다.
11. 마무리
SwiLA는 선형 어텐션의 고정 크기 기억을 유지하면서, 여러 회귀 성분을 문맥에 맞게 조합하는 검색 방식으로 표현력을 높입니다. 기존 상태의 예측 오차가 다음 갱신 비중에 영향을 준다는 점과 문맥의 지속성을 따로 다루는 구성이 핵심입니다.
실험은 고정 상태에서도 회상 성능을 개선할 수 있음을 보여 주지만, 전체 기록을 저장하는 어텐션과의 용량 차이 및 순차 학습 비용은 남아 있습니다. 실제 적용에서는 필요한 문맥 길이, 회상 정확도, 배치 처리량, 학습 비용을 함께 놓고 이 구성이 적합한지 판단해야 합니다.
논문 원문 · Switching Linear Attention