
本文由IPLEX知识产权律师事务所的韩国专利代理师金容德撰写,对相关技术论文进行解读。
同一个词,在不同上下文中可能指向不同对象。AI将对话记录压缩成记忆时,也需要保留这种差异。如果把多个上下文混入同一份记忆,不同的关联关系就可能在检索时相互干扰。
Switching Linear Attention,简称SwiLA,将固定大小的记忆分配给多个线性回归分量,并依据输入与已有记忆之间的关系调整更新权重。其核心是在不无限增加存储空间的前提下,提高信息检索函数的表达能力。
1. 论文信息与解读版本
论文题为Switching Linear Attention,作者为Hyun Dong Lee、Xavier Gonzalez、Nicolas Zucchet、E. Kelly Buchanan、Emily B. Fox和Scott W. Linderman。论文列出的机构为Stanford University;脚注说明,Xavier Gonzalez在研究期间任职于Stanford,目前在Unconventional AI。
本文依据2026年9月30日发布的arXiv:2609.39034v1,DOI为10.48550/arXiv.2609.39034。原文PDF注明这是一篇COLM 2026会议论文。下文涉及的数值和图表均以v1为准。
原文采用CC BY 4.0许可。转载图表的来源为Lee等人于2026年发表的Switching Linear Attention,图注保留原文图表编号。本文解读作者与论文研究团队并非同一主体。
2. 为什么检索方式重要:保留完整记录,还是压缩成状态
通常,softmax注意力会把历史词元的键和值保存在KV缓存中,再计算查询与各键的关系,组合需要的值。这样的检索较为灵活,但上下文越长,需要保存的缓存也越大。
线性注意力则把历史信息累积在固定大小的状态矩阵中,相当于从一本摘要账簿中读取答案,而不再逐项展开全部记录。不过,只用一个线性映射把查询对应到值,难以充分表示随上下文变化的关联。
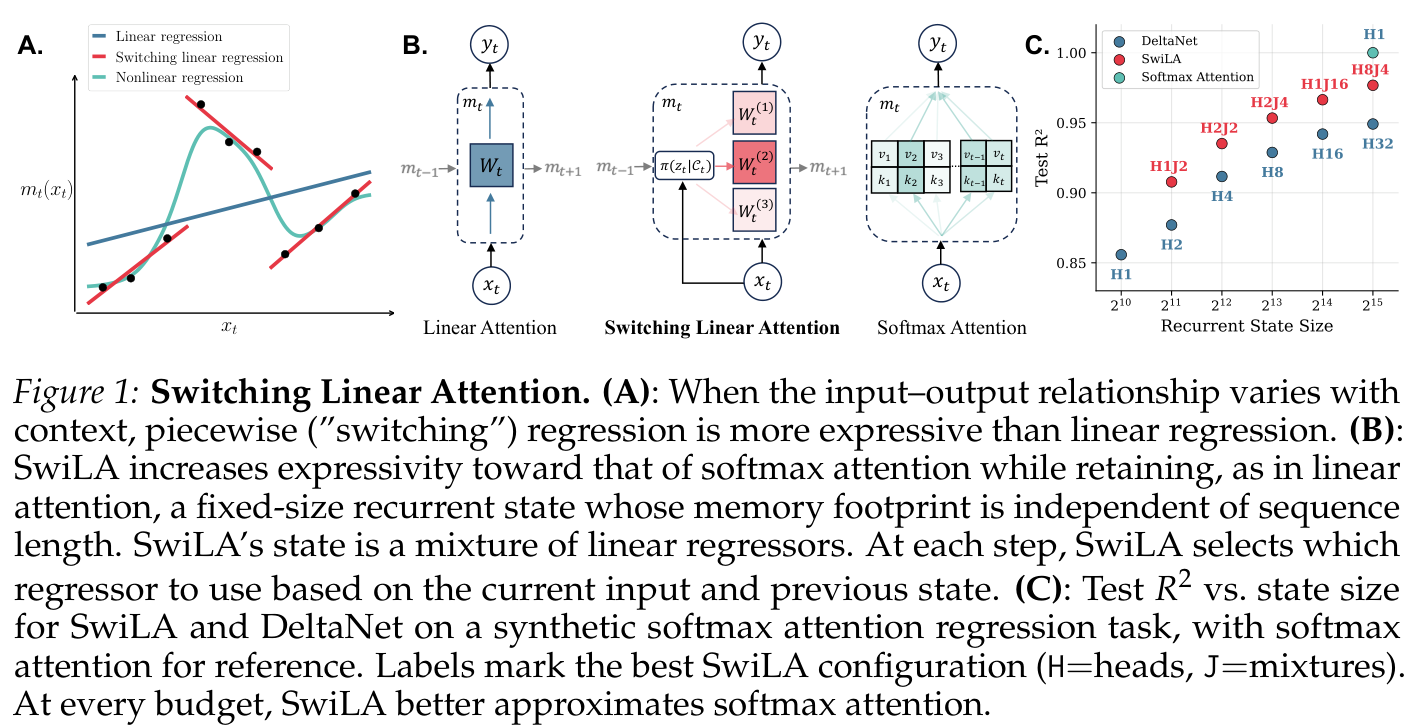
例如,Harry出现在介绍音乐家的段落中,和出现在讲述虚构巫师的段落中,需要唤起的关联并不相同。SwiLA用多个回归模型的混合,处理同一线索在不同上下文中指向不同值的情况。
3. 核心思路:将记忆建模为回归模型的混合
研究者把记忆写入理解为学习从键到值的回归函数,把检索理解为在该函数中代入查询。这一视角称为测试时回归(TTR)。读取词元时变化的是在当前上下文内学习的快速权重状态,并非每来一个词元就重新训练整个语言模型。
DeltaNet的基本读取操作是用单一状态矩阵W乘以查询q。SwiLA将状态拆分为J个线性回归分量,并为每个输出维度分别设置混合权重。可以把它理解为保留多本各有所长的账簿,再根据问题调整各自对答案的贡献。
输出由各分量的预测乘以查询侧混合权重后求和得到。因此,Switching并不意味着始终只选择一个专家的硬路由。混合权重随输入变化,使整体检索函数比单个线性变换具有更强的表达能力。
当输出维度为D时,分量选择的组合可达J^D种,但实际存储的权重规模为J×D²。可组合方式的数量不等于实际记忆容量。论文并未声称固定状态能够无损保存全部历史信息。
4. 一个词元的处理流程:以预测误差决定更新比例
第一步,从输入词元计算查询、键、值以及混合权重。第二步,各回归分量依据已有状态预测当前键对应的值,并与实际值相减,得到预测误差。
第三步,将输入产生的先验权重与各分量的预测误差结合,计算责任度(responsibility)。即使输入相同,已有记忆不同,责任度也可能不同。这正是它与仅依据输入进行分配的路由器之间的区别。
第四步,按学习率×责任度×预测误差×键所对应的量更新各分量的快速权重。第五步,把查询作用于更新后的分量,再按查询侧权重加总形成输出。研究者从线性回归混合模型的在线期望最大化算法(EM)推导出这一流程。
EM提供了估计潜在分量归属概率并更新模型的框架。这里的实现并非对每个词元反复进行长时间优化直至收敛,而是以快速权重的一步随机梯度更新构成递推式。
5. 延续上下文与遗忘旧状态:Temporal SwiLA和Gated SwiLA
Temporal SwiLA考虑到上下文通常会跨越多个连续词元。它将上一时刻的分量概率分布与当前输入产生的分布混合,再向后传递。这是对隐马尔可夫模型滤波的一种便于计算的近似;即使段落中没有反复出现上下文提示,分量选择的倾向也能延续。
Gated SwiLA引入由输入控制的遗忘门,对较早的状态进行衰减。论文分别给出了先计算责任度再衰减,以及先衰减再计算责任度的公式。实际采用的是后者,即从衰减后的状态计算预测误差和责任度。
如果更新总是集中在少数分量,增加分量数量也无法充分发挥作用。研究者提出辅助损失,同时鼓励各分量的均衡利用与逐词元的专业化。他们还讨论了输入相关噪声,但在主要的374M语言模型实验中关闭了路由器和时间门的噪声。并不是所有实验都同时启用了全部改进。
6. 合成实验:同一个键随上下文对应不同的值
softmax近似实验使用维度32、长度512的合成序列,训练集包含65,536条序列,测试集包含2,048条。与DeltaNet比较时,两者采用相同的循环状态预算。每种预算下最优的SwiLA配置都取得了更高的测试R²。该结论对应指定的合成输入与配置搜索,并不保证对所有输入都具有同等的近似精度。
上下文依赖关联回忆任务(CDAR)设置四个上下文,每个包含32组键值对,共128个关联。同一个键在不同上下文中对应不同值,而且上下文词元不会持续重复出现,因此模型必须同时保留键值关系和当前上下文。序列长度为1,024。
在Figure 2A中,单头、维度32、四个混合分量的Temporal SwiLA,以4,096的状态大小成为达到近乎完美准确率的最小配置。但图中展示的是对学习率和随机种子进行搜索后获得的最佳准确率,不能当作平均训练稳定性或实际服务成功率。
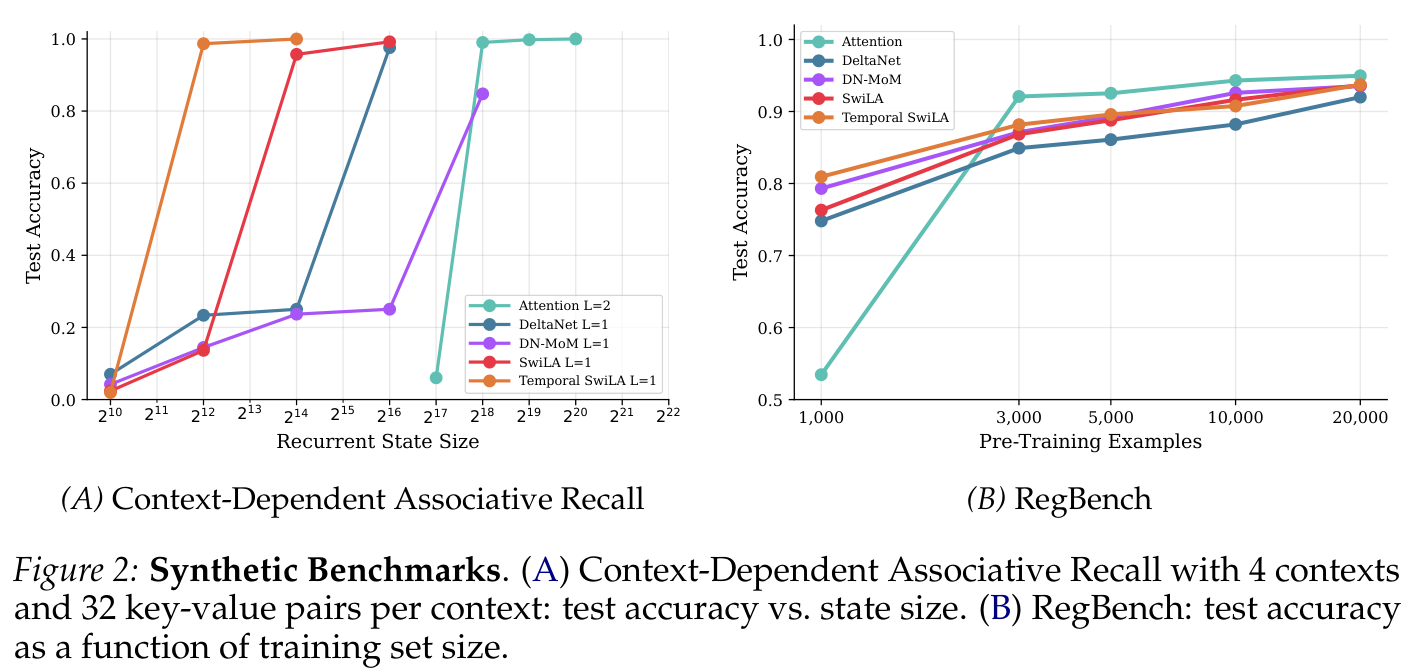
RegBench要求模型观察随机概率有限自动机生成的示例字符串,在上下文内学习下一词元的分布。实验比较八层模型,并将循环模型每层状态大小统一为16,384。训练数据较少时,Temporal SwiLA和DN-MoM表现较强;数据增多后,Transformer达到最高准确率。因此,不能说SwiLA在所有数据规模下都领先。
7. 语言模型结果:在相近规模与训练条件下比较
主要语言模型实验采用约3.74亿(374M)参数、24层、隐藏维度1,024的模型,使用约150亿(15B)FineWeb-Edu词元训练。训练序列长度为4,096,使用八张H100 GPU。为匹配总参数量,各架构的前馈网络中间维度进行了小幅调整。
SwiLA系列采用八个头,每头四个混合分量,键和值的维度均为64,每层主要循环状态包含131,072个标量。DeltaNet、GDN和KDA也采用相同的主要状态规模。不过,主要状态数量一致,并不代表运行时总内存和计算量也完全一致。
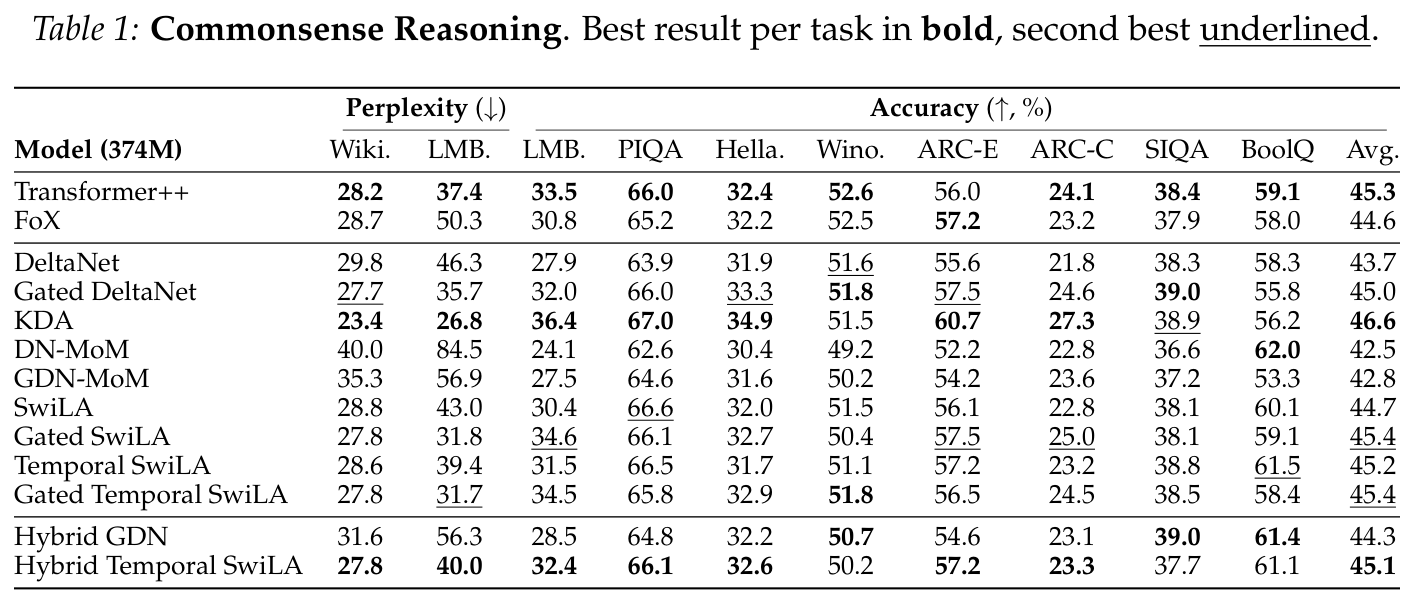
常识推理的平均准确率分别为:Transformer++ 45.3%、DeltaNet 43.7%、Gated DeltaNet 45.0%、KDA 46.6%。SwiLA为44.7%,Gated SwiLA与Gated Temporal SwiLA均为45.4%。带门控的变体比Transformer++高0.1个百分点,但KDA更高。论文没有提供依据,将这一小幅差异解释为统计上确定的优势,或推广为更大规模模型的普遍优势。
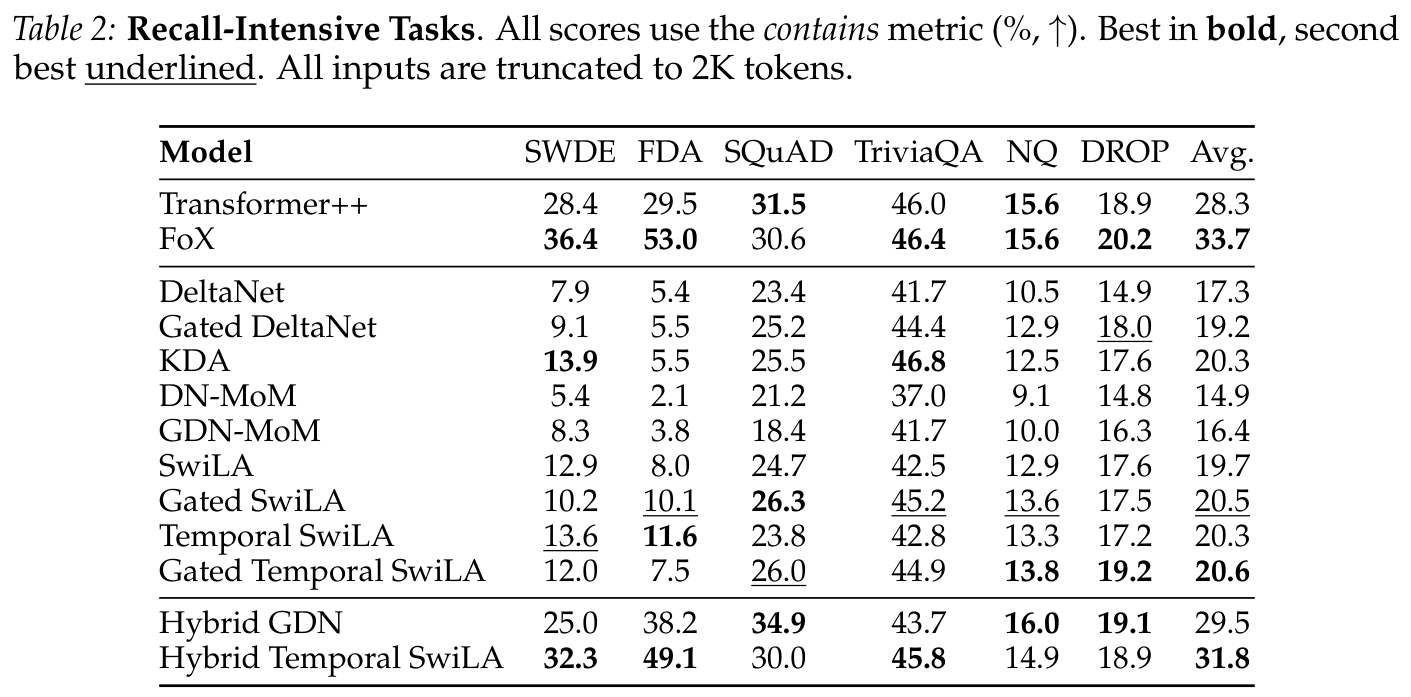
回忆任务平均得分分别为DeltaNet 17.3%、Gated DeltaNet 19.2%、KDA 20.3%、Gated Temporal SwiLA 20.6%。Transformer++为28.3%,FoX为33.7%,差距仍然明显。固定状态中的回忆能力得到改善,不等于已经完全替代保存完整KV缓存的模型。
Hybrid Temporal SwiLA将三个循环层与一个softmax注意力层交替组合,得分为31.8%,高于Hybrid GDN的29.5%和Transformer++的28.3%。但混合模型的全注意力层仍保留KV缓存,因此不能把纯SwiLA的固定状态属性直接用于描述整个混合模型。
8. 吞吐量提升的条件:训练速度与推理吞吐量应分别看待
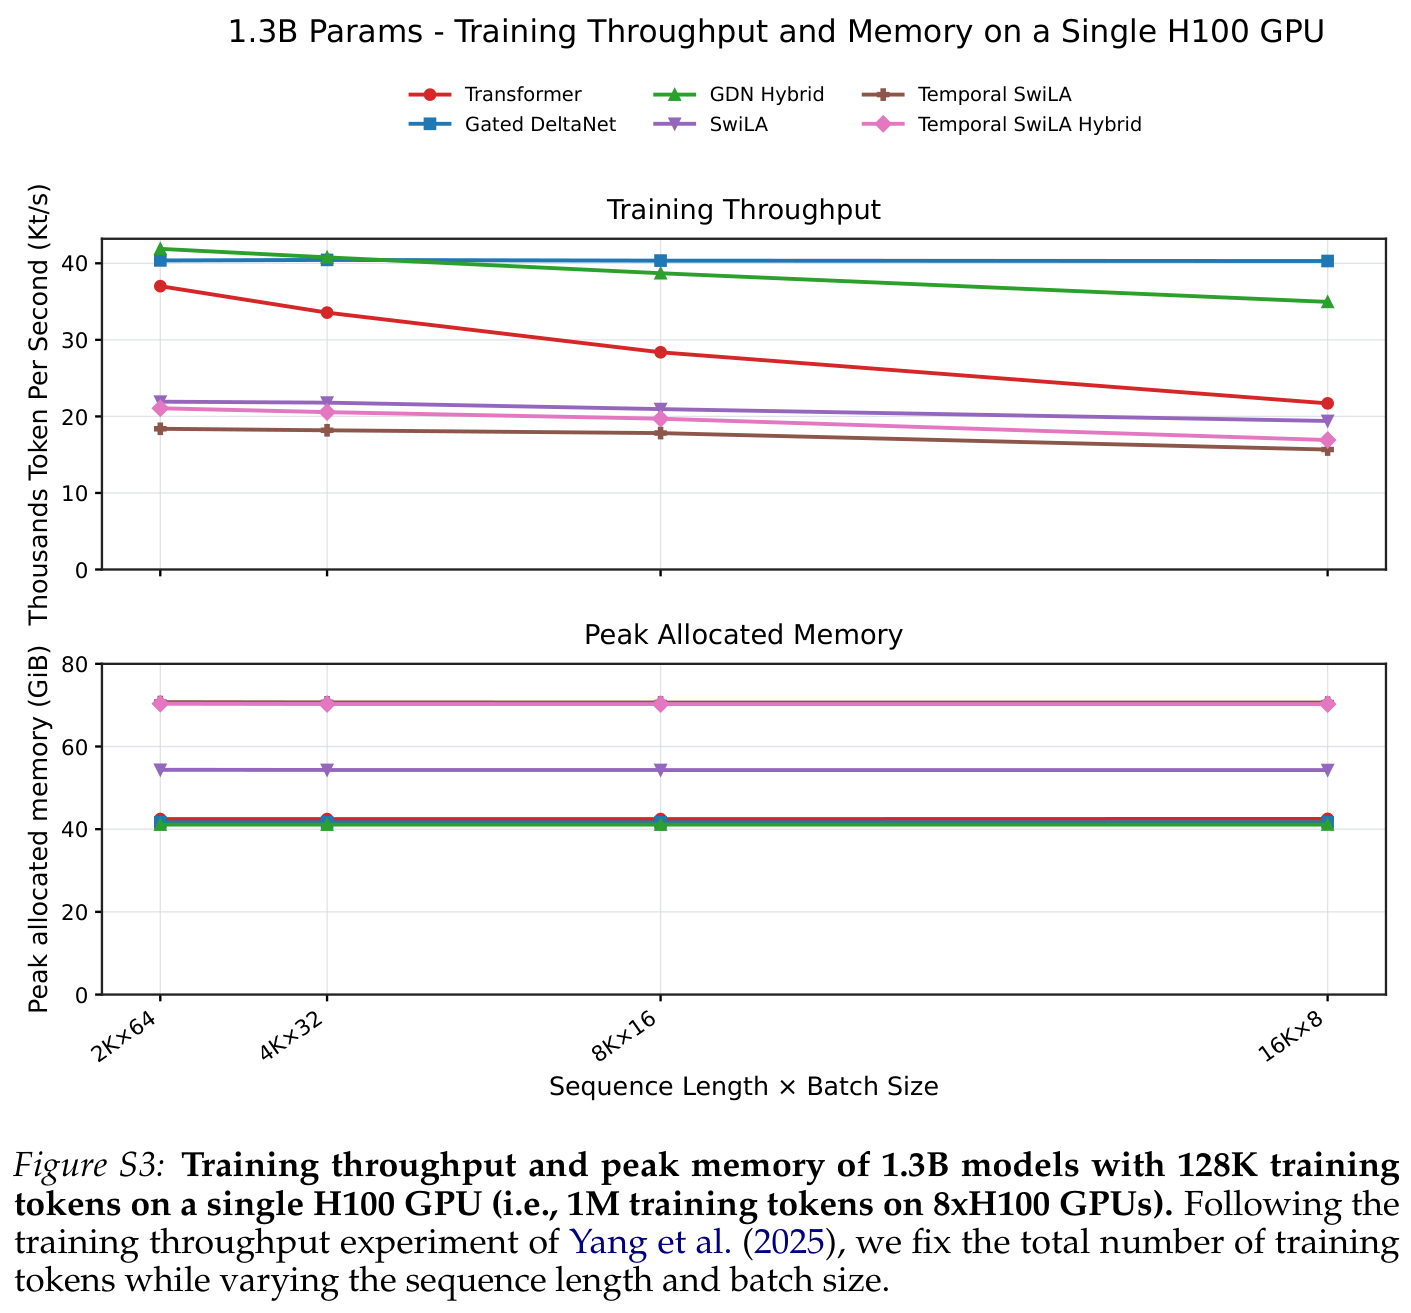
吞吐量实验与前述精度实验不同,测量的是单张H100上13亿(1.3B)参数的模型。训练序列长度为2K、4K、8K、16K时,批大小分别为64、32、16、8,使每次更新均处理131,072个词元。计时包括前向传播、反向传播、梯度裁剪和AdamW更新。
推理使用2,048词元的合成提示,通过贪心解码生成128词元,批大小从1增至128。测量的是包括预填充和解码在内的完整生成时间;发生显存不足的配置以及更大的批大小不计入完成测量。
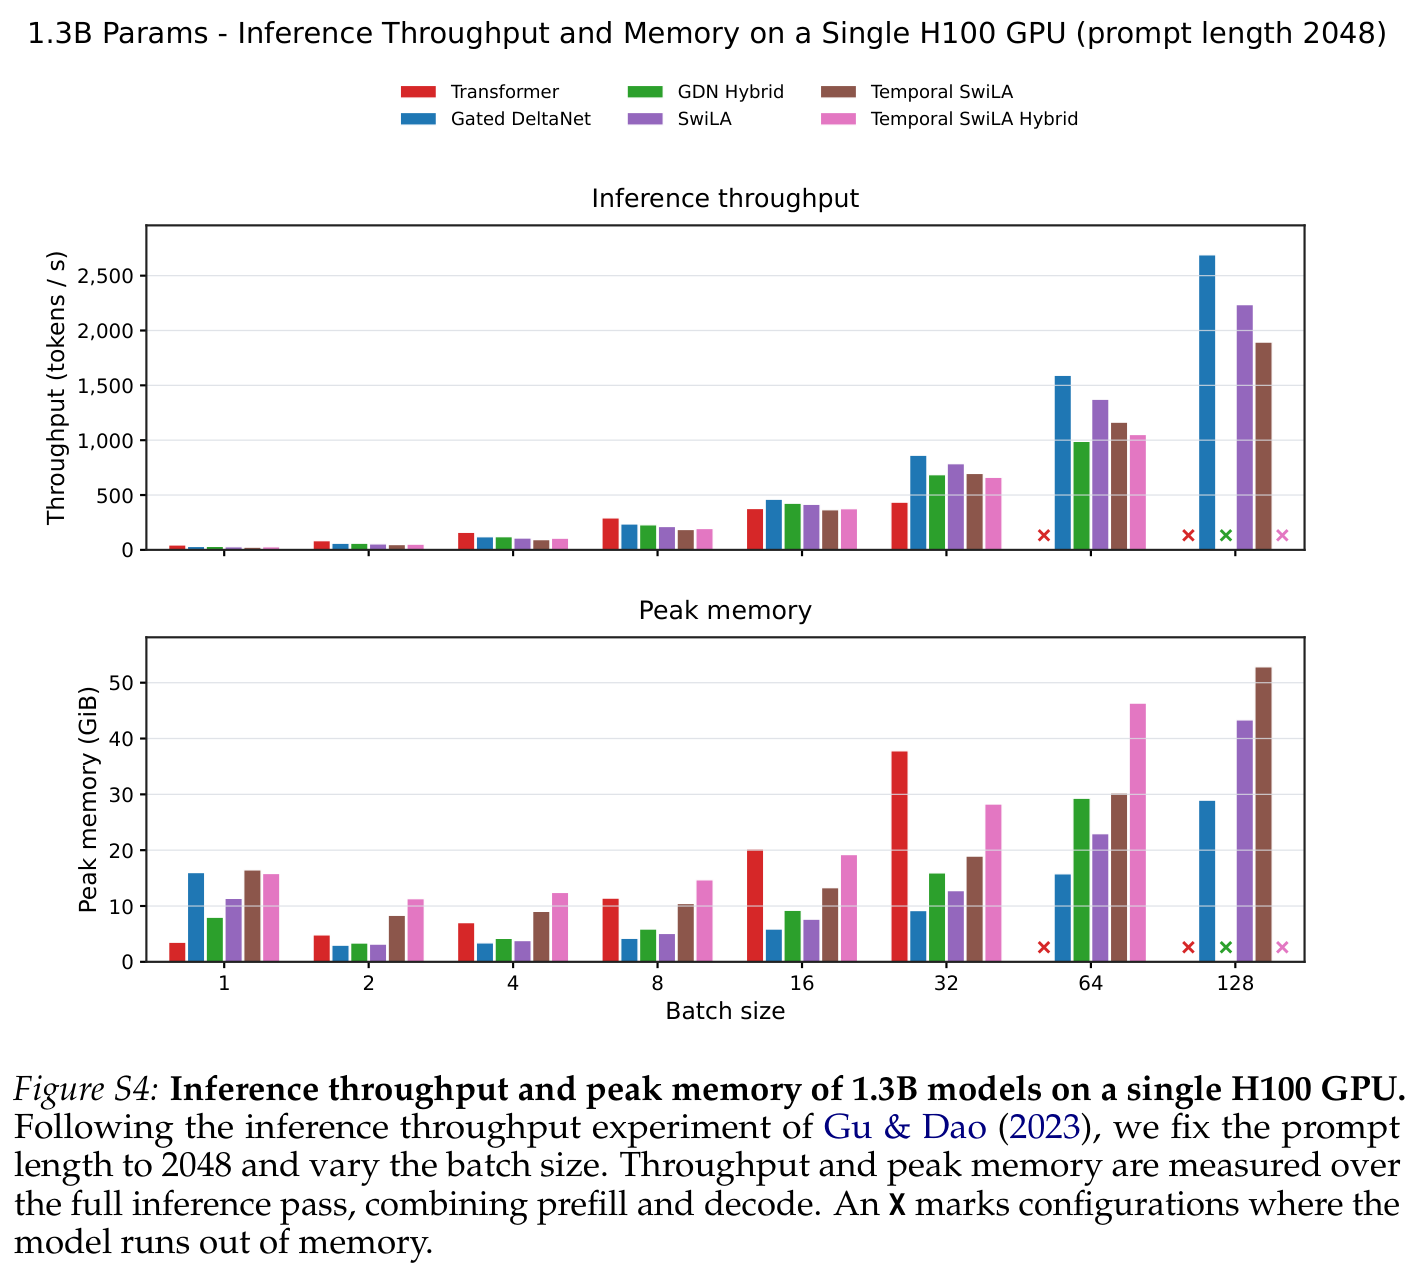
研究者报告,SwiLA整体推理吞吐量达到Transformer基线的4—5倍,其中包含不使用KV缓存、从而容纳更大批次带来的收益。这不意味着每个批大小下都快4—5倍,也不意味着单个用户等待答复的时间按相同比例缩短。相较GDN,SwiLA训练约慢2倍,推理约慢1.25—1.5倍,内存占用也更高。
9. 尚存的限制与适用条件
首先,记忆容量仍然固定。上下文增长并不会带来额外存储,信息干扰和容量上限依然存在。尤其是原文回忆评测明确将输入限制为2K词元,不能仅据此推断超长文档中的准确性。
其次,责任度依赖已有状态,形成非线性递推,给并行训练带来困难。论文实验采用快速顺序Triton内核;附录虽然提出牛顿迭代和分块并行方法,但不能描述为这些优化已在主要实验中解决了训练速度问题。
第三,专家越多并不一定越好。在独立的115M参数、5B训练词元消融实验中,保持状态预算不变而将分量数从4增至16,会缩小各分量的投影维度,性能略有下降。必须权衡分量数量和单个分量的表达容量。
第四,基本SwiLA存在专家坍缩问题。消融实验中,加入辅助损失后,测试困惑度从36.769降至16.807;Temporal SwiLA相应为16.718和16.715,差异很小。这些数值来自该消融实验,不能与主要374M实验的性能混在一起比较。
10. 从专利代理师视角看技术区别
技术问题是在有限循环状态内,更准确地保留并检索随上下文变化的键值关联。解决方案可概括为线性回归分量的混合、按输出维度设置权重、反映已有状态预测误差的责任度,以及利用责任度更新状态的组合。
相较仅依据输入选择记忆的方式,SwiLA在分配过程中考虑当前记忆对该输入的解释程度。Temporal结构加入上下文的持续性,Gated结构加入记忆衰减。准确说明技术差异,需要区分这些结构各自的作用及其组合关系。
已经确认的效果包括指定状态预算下的合成任务性能,以及374M实验中的回忆改善;同时仍有训练和推理成本增加、与全注意力相比回忆得分较低等问题。笔者认为,论文的价值不只在于划分记忆,更在于用一致的概率模型共同设计更新规则和检索函数。这是对技术结构的解读,并非对可专利性或侵权作出判断。
11. 结语
SwiLA保留线性注意力固定大小的记忆,通过按上下文组合多个回归分量,提高检索的表达能力。已有状态的预测误差影响后续更新分配,以及单独建模上下文持续性,是其中两项关键设计。
实验表明,固定状态也能改善回忆性能,但与保存完整历史的注意力相比,容量差异和顺序训练成本仍然存在。实际应用时,应同时考虑所需上下文长度、回忆准确率、批处理吞吐量和训练成本,再判断该架构是否合适。
图中保留原始标注与形态,相关内容在正文中说明。
查看IPLEX的AI技术与专利分析
论文原文:Switching Linear Attention