
論文と技術的課題
対象はJiebin ZhangらのDFlare: Scaling Up Draft Capacity for Block Diffusion Speculative Decoding、arXiv:2606.02091v2(2026年6月2日、初版6月1日)です。北京大学・TencentのチームによるCC BY 4.0のプレプリントであり、推論の高速化を扱います。ドラフトモデルを大きくすれば回答品質も当然に上がる、という主張ではありません。
並列に候補を作り、ターゲットで受理を判定する
ブロック拡散型ドラフターは、一回の順伝播でマスク位置を予測し、ブロック内では双方向の注意を用います。ターゲットモデルが候補を確認し、貪欲デコードでは最初の不一致までの接頭部分を受理して次のトークンを補います。確率的デコードで分布を保つには適切な受理手続が必要です。候補が長い、あるいは自然に見えるだけでは高速性や同等性の根拠になりません。
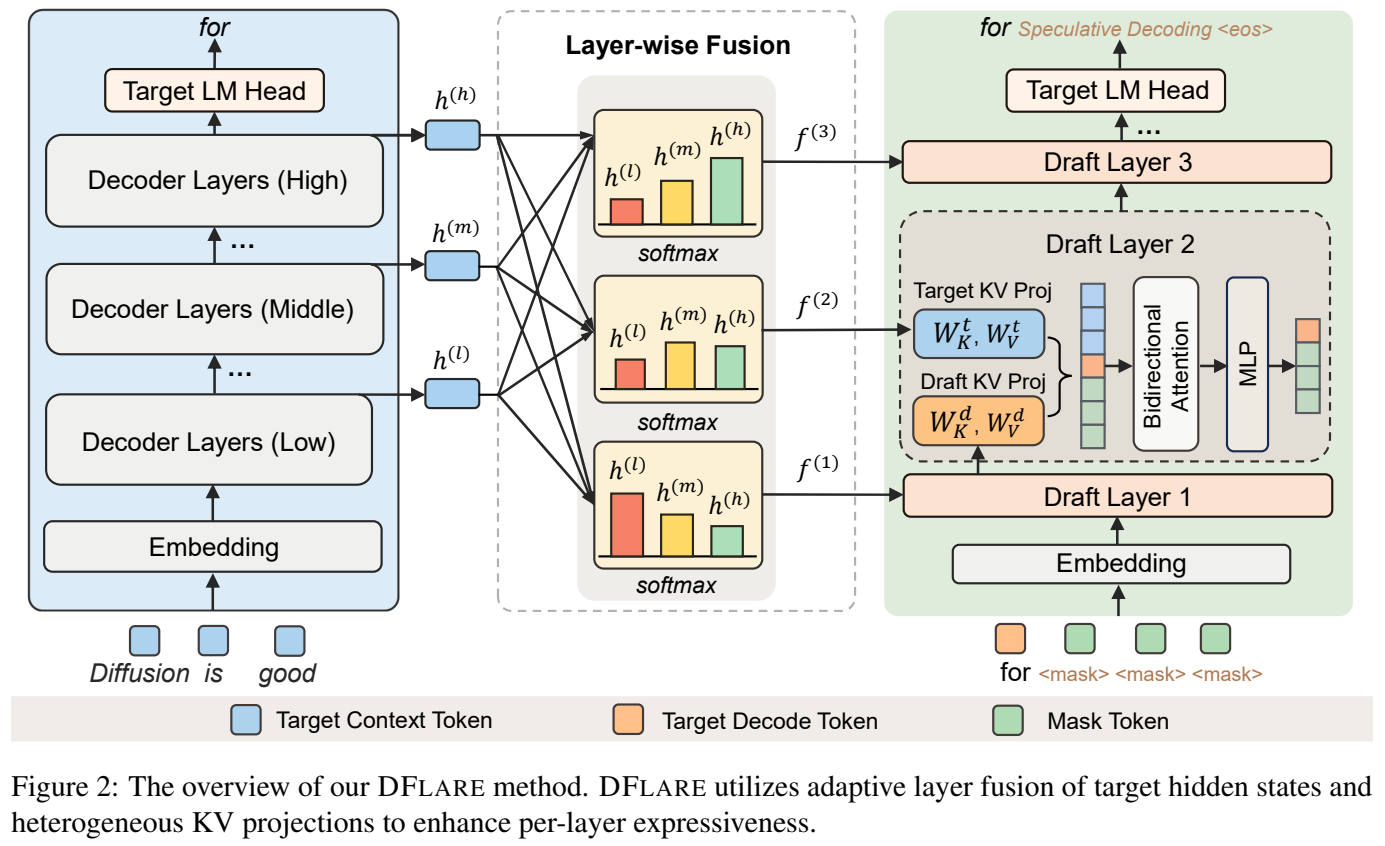
ドラフト層ごとに異なる情報の混合
DFlashはターゲット特徴を全結合層で融合した共通表現を使います。DFlareでは各ドラフト層が複数のターゲット隠れ状態の混合比率を学習し、softmaxで正規化してRMSNormを適用します。7層から9個のターゲット層を参照する場合、混合係数は63個ですが、追加パラメーター全体が63個という意味ではありません。係数を保存しても入力に応じた重み付き表現の計算は残ります。
情報の出所に応じてKV投影を分ける
ターゲットの文脈特徴と、ドラフト側の開始トークン・マスク位置の特徴は異なる表現空間にあります。両者に別々のキー・バリュー投影を用い、クエリーはドラフト特徴から作ります。着目すべきは単なる層数の増加ではなく、層別の情報選択と入力元別の変換の結合です。
先頭を安定させ、後方の学習比重を高める
複数のアンカー位置と制限された注意を用いて学習し、埋込みと言語モデルヘッドは固定・共有します。位置別損失は、早い位置の不一致が後続候補を捨てることを踏まえ、最初は前方を重視し、後方の比重を段階的に上げます。付録では減衰係数γを4.5から開始して各エポックで1増加し、ブロック長8のGPT-OSS-20Bはγ=4で固定しています。一般的なスケジュール説明と実装条件を区別して読みます。
評価条件とデータ規模
Qwen3-4B、Qwen3-8B、GPT-OSS-20Bを主にNVIDIA H20で評価し、通常の自己回帰、EAGLE3、DFlashと比較しました。課題はGSM8K、MATH500、AIME25、HumanEval、MBPP、MT-Benchです。Qwenのドラフト層数・ブロック長・参照層数は7・16・9、GPT-OSSは8・8・7。240万例はNemotron Post-Training Dataset V2、CodeAlpaca、Step3.5-Flash-SFT等から構成し、プロンプトを残して応答をターゲットで再生成しました。6エポック、最大3,072トークンで学習し、32-gram以上の重複を除去しました。Qwen3-8Bの27万・80万・240万例では平均加速倍率3.74・4.97・5.46、受理長4.90・6.59・7.33です。主要結果には構造とデータ双方の差が含まれます。
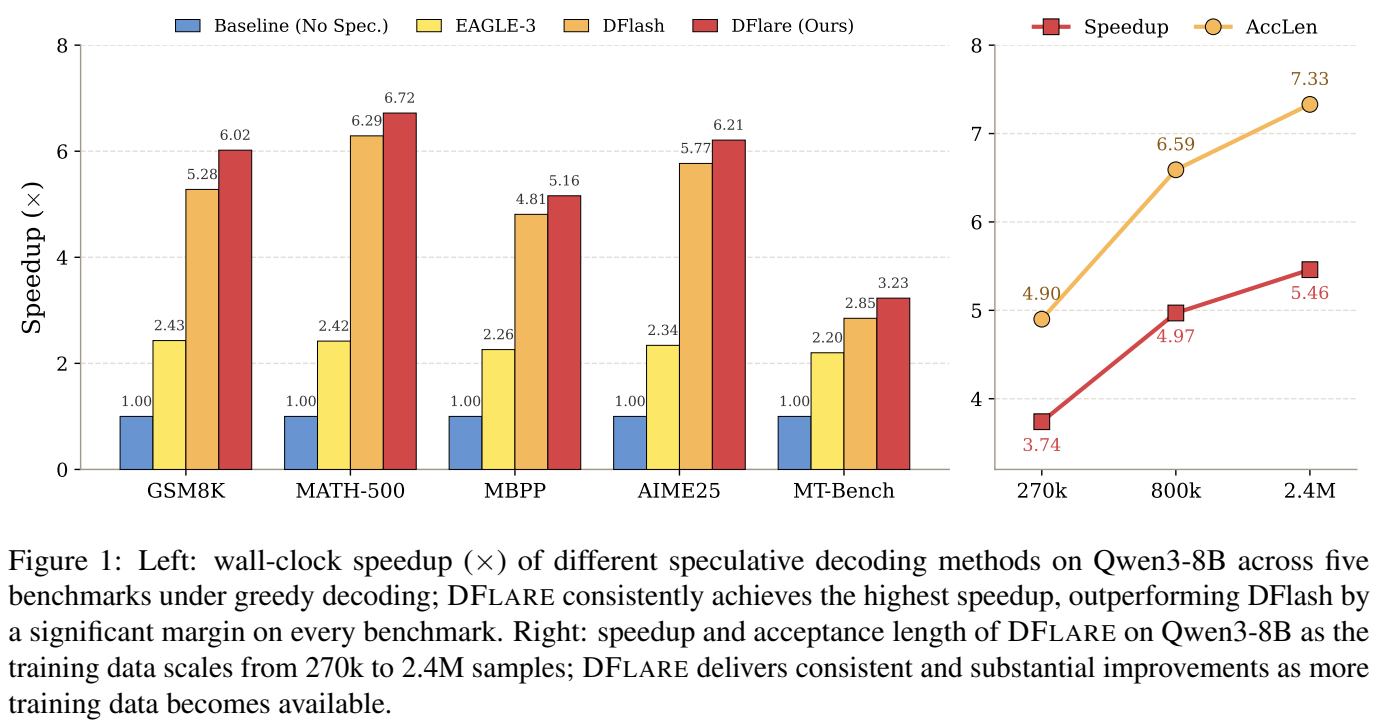
平均改善と個別の例外
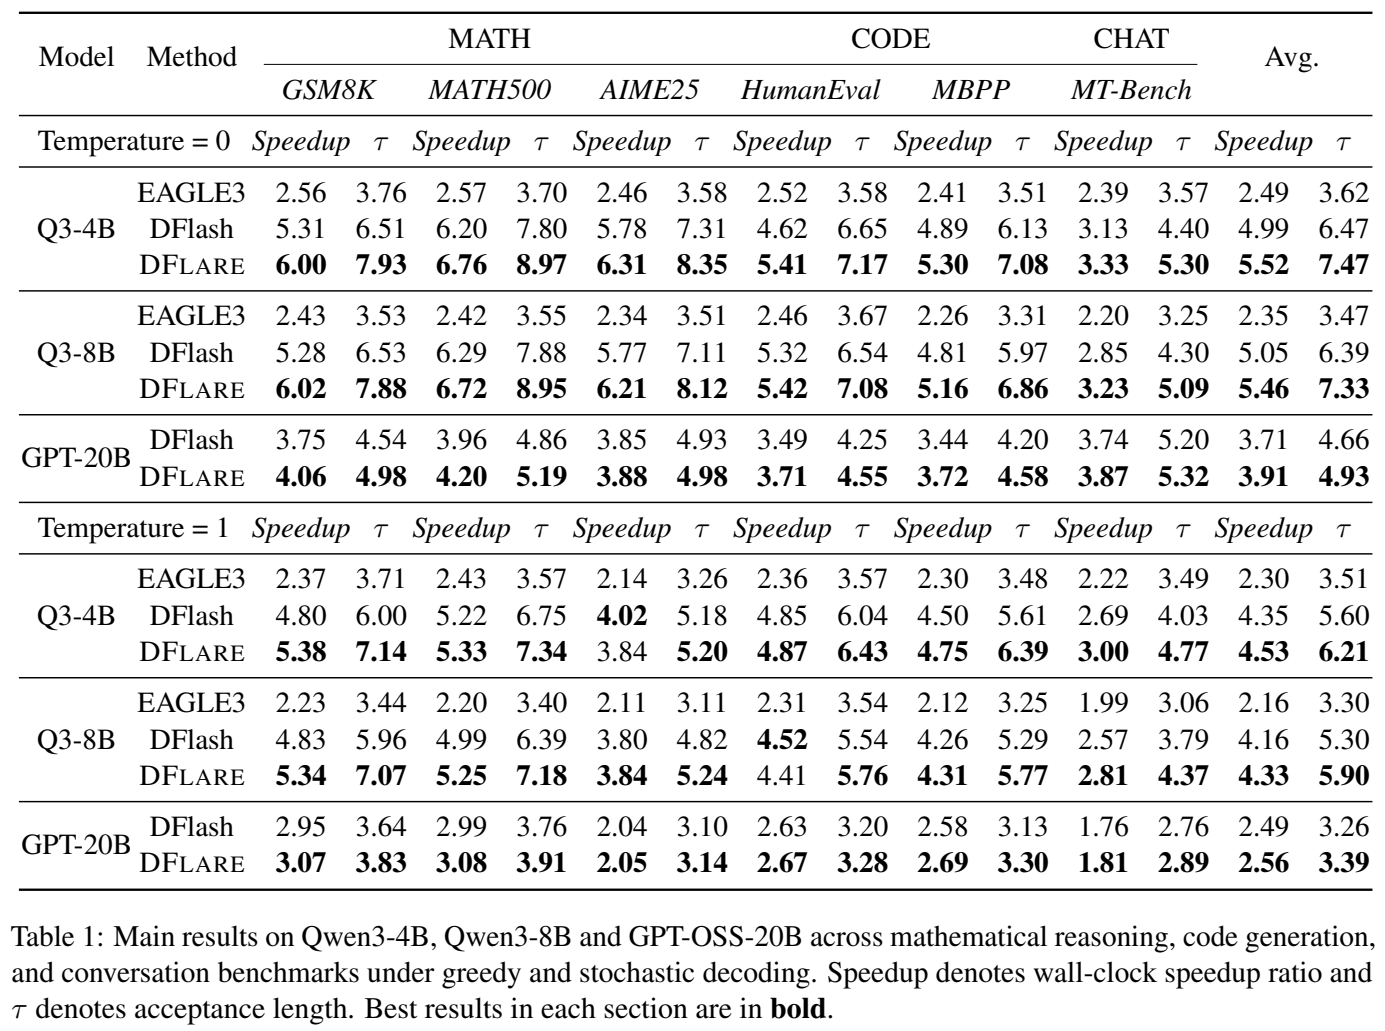
温度0のDFlash→DFlareの平均加速倍率は、Qwen3-4Bで4.99→5.52、8Bで5.05→5.46、GPT-OSSで3.71→3.91。相対改善は約10.6%、8.1%、5.4%です。受理長は6.47→7.47、6.39→7.33、4.66→4.93でした。温度1では平均が改善しても、4BのAIME25は4.02→3.84、8BのHumanEvalは4.52→4.41に低下しました。全条件で優れるとはいえません。
構成比較から分かる範囲
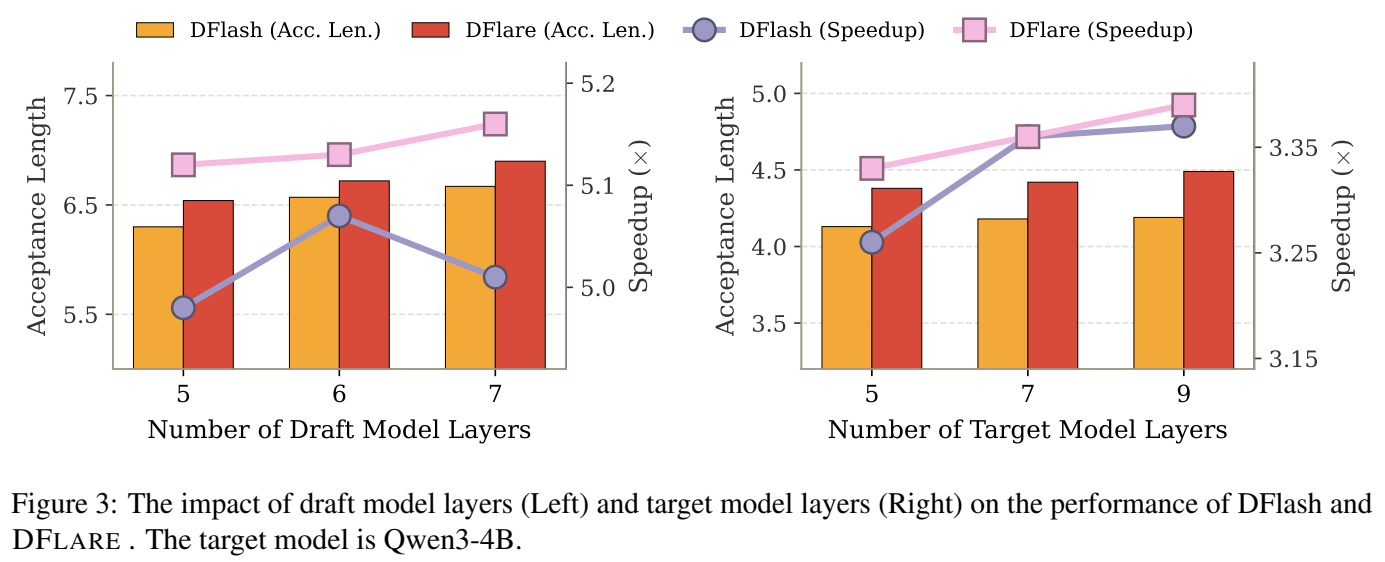
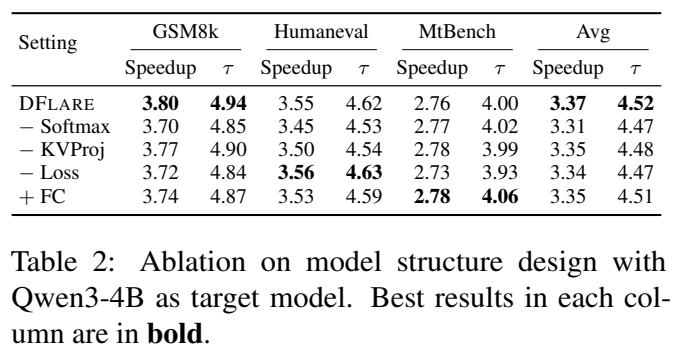
DFlashと同じ学習データでドラフト層を5・6・7としたDFlareの倍率は5.12・5.13・5.16、DFlashは4.98・5.07・5.01。DFlareの受理長は6.55・6.72・6.90でした。無制限な拡張を示す実験ではありません。別の3課題の構成比較では全構成が倍率3.37・受理長4.52、softmax除去は3.31・4.47、KV分離除去は3.35・4.48、損失スケジュール除去は3.34・4.47。全結合層追加の受理長4.51も自動的改善ではなく、試行間変動のない小差の解釈には注意が必要です。
サービス時の処理量と学習費用
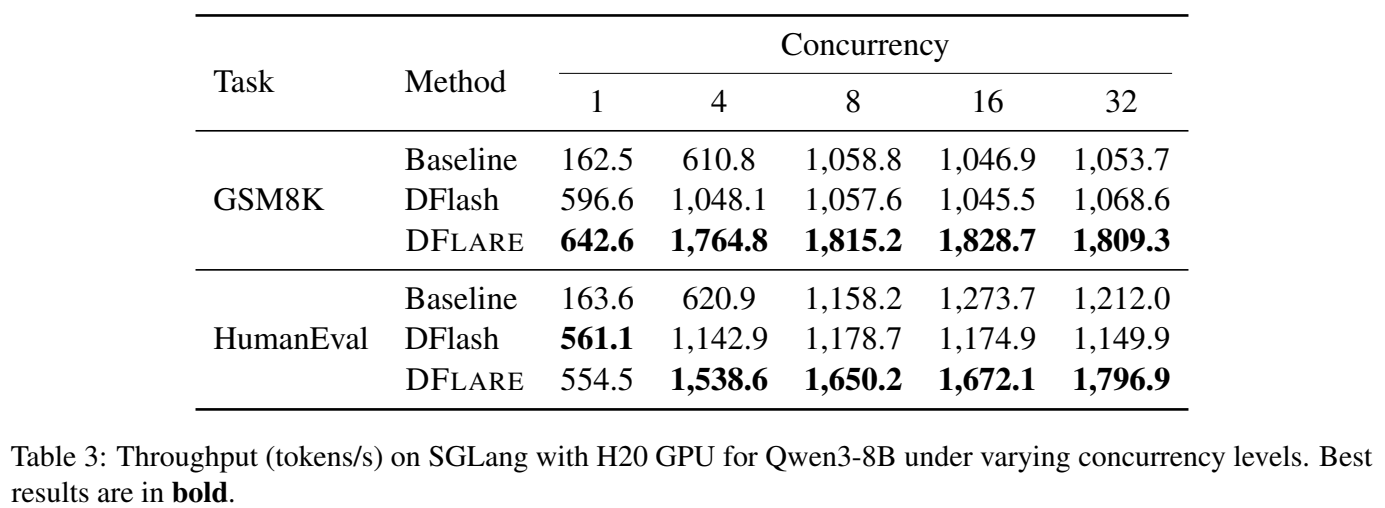
H20上のSGLang・Qwen3-8B、同時実行32では、GSM8Kの毎秒トークン数は自己回帰1,053.7、DFlash1,068.6、DFlare1,809.3、HumanEvalは1,212.0・1,149.9・1,796.9でした。一方、同時実行1のHumanEvalではDFlare554.5がDFlash561.1を下回ります。8Bの学習は32GPUそれぞれ約160時間、合計約5,120GPU時間であり、総計160時間ではありません。費用回収点は定量化されず、さらに大きなデータ規模も資源制約の下では未検証です。
特許実務から見た技術の記述
情報のボトルネックと具体的な混合・投影・損失設定を対応させ、条件付きの実験効果につなげて説明することが重要です。ターゲット内部の隠れ状態へのアクセスが必要なので、任意の閉鎖型APIへそのまま適用できるとは限りません。構造、学習データ、提供環境の寄与を分けて記述します。本稿は技術開示の検討材料であり、新規性・進歩性・特許適格性の結論を示すものではありません。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。
論文・図表:Zhangら、DFlare v2、2026(CC BY 4.0) · CC BY 4.0