
Una lectura de la investigación desde la práctica de patentes
Por Yongduck Kim, profesional de patentes habilitado en Corea, IPLEX. Multi-Head Attention Residuals estudia cómo reutilizar representaciones que un modelo de lenguaje ya ha calculado. Cada grupo de características puede necesitar información de capas anteriores diferentes. Los experimentos aquí comentados son los publicados por los autores del artículo, no ensayos realizados por IPLEX.
El análisis se refiere a Multi-Head Attention Residuals, de Cheng Luo, Zefan Cai y Junjie Hu, arXiv:2607.27230v2, revisado el 31 de julio de 2026. Las afiliaciones indicadas son Independent Researcher y University of Wisconsin–Madison. El preprint y las figuras de investigación reproducidas se atribuyen a dichos autores y están sujetos a la licencia CC BY 4.0.
Del flujo residual a la selección de representaciones anteriores
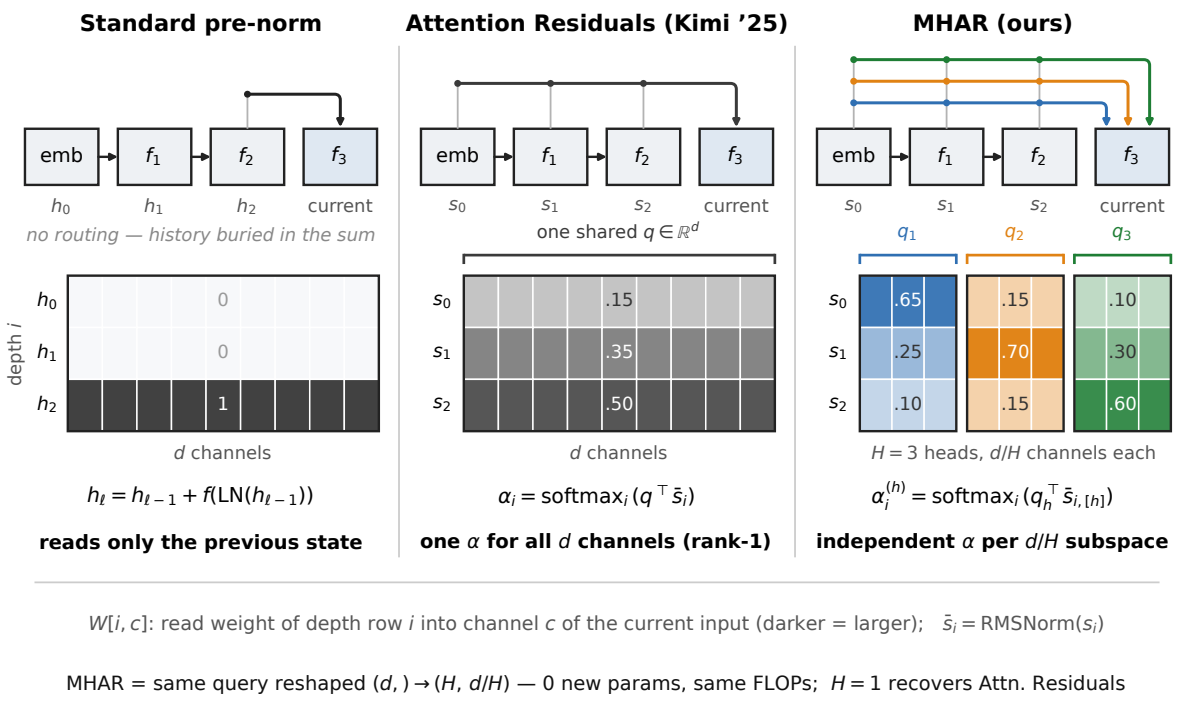
Un Transformer pre-norm convencional suma la salida de cada subcapa al flujo residual. La siguiente subcapa recibe el estado acumulado, no una colección de salidas anteriores accesibles individualmente. No se afirma que la información previa desaparezca: la cuestión es cómo seleccionarla.
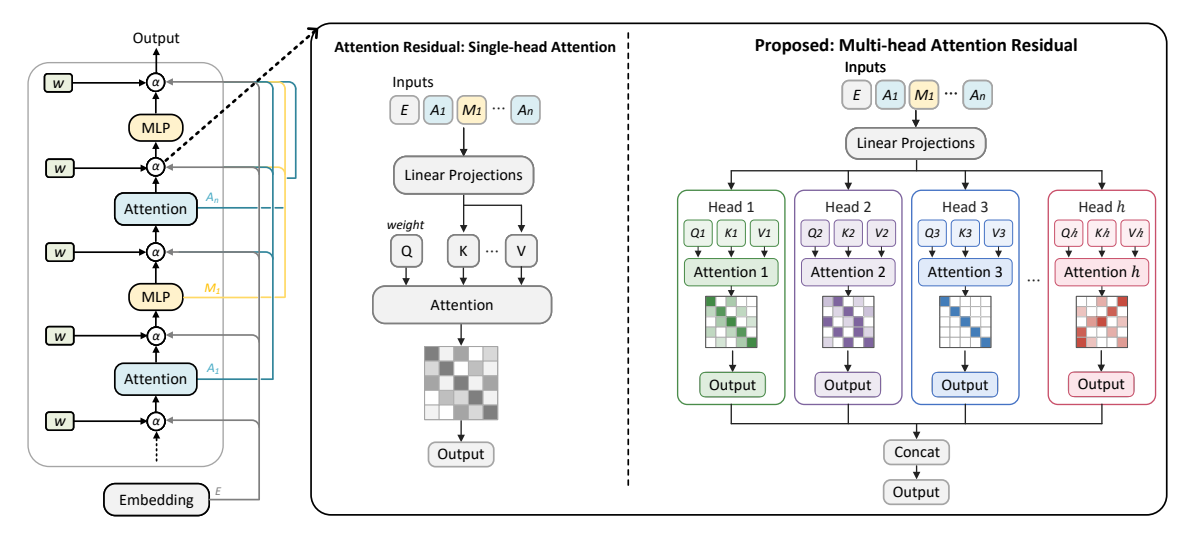
Attention Residuals conserva como fuentes independientes la representación de entrada y las salidas anteriores de atención y MLP. Una consulta aprendida las puntúa y un softmax en profundidad determina la suma ponderada. Con una sola cabeza, la misma distribución se aplica a todos los canales, aunque distintos grupos de características necesiten fuentes diferentes.
La modificación que introduce MHAR
MHAR divide la consulta de dimensión d y cada representación fuente en H subespacios de dimensión d/H. Cada cabeza puntúa las fuentes disponibles y aplica su propio softmax en profundidad. Las sumas ponderadas parciales se concatenan para recuperar una entrada de dimensión d. Con H = 1 se obtiene la variante de una sola cabeza.
La diferencia está en el eje de selección: la autoatención multicabeza convencional selecciona tokens; MHAR selecciona salidas de capas anteriores en la posición actual. La diversidad de patrones aprendidos no demuestra que una cabeza se especialice en gramática y otra en matemáticas. Tampoco debe interpretarse el esquema como la incorporación de una gran red de proyección adicional: el método reorganiza las dimensiones existentes de consulta y características.
Secuencia de procesamiento y coste
Solo se utilizan la representación de entrada y las salidas ya calculadas; no se consultan capas futuras. RMSNorm proporciona claves normalizadas, mientras que los valores son las representaciones fuente originales. Consultas y claves se dividen de forma coherente, cada cabeza calcula sus puntuaciones y su softmax, y las sumas ponderadas se concatenan para alimentar la subcapa de atención o MLP actual.
En los experimentos principales desde cero, las consultas de encaminamiento se inicializan a cero, de modo que la distribución inicial es uniforme. La ausencia de parámetros adicionales se entiende frente a la variante de una cabeza. Frente al Transformer ordinario, el artículo comunica aproximadamente un 0,02 % más de parámetros y un 0,5–1,2 % más de cálculo teórico. Las lecturas repetidas siguen generando tráfico de memoria, lo que motiva la implementación mediante un núcleo fusionado de Triton.
Entrenamiento desde cero: distinguir las comparaciones
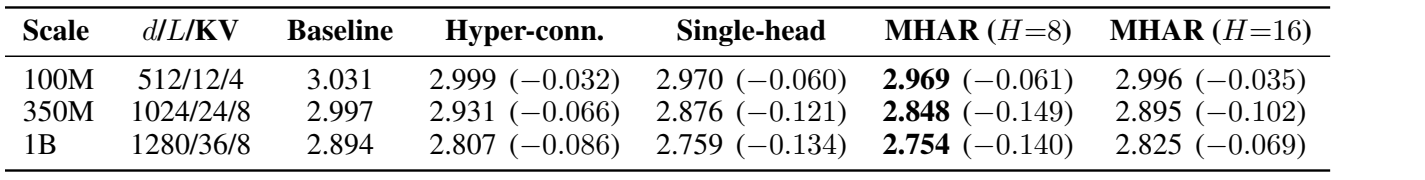
Los ensayos principales entrenan modelos de estructura Qwen3 de 100M, 350M y 1B durante 20.000 pasos. Utilizan anneal_pt_v3, un corpus inglés depurado y deduplicado con abundante contenido sintético, STEM y código. Para cada tamaño se igualan datos, calendario y lotes al comparar la referencia, Hyper-Connections, una cabeza y MHAR. Las pérdidas son la media de 11 evaluaciones en los últimos 5.000 pasos; esa media no es, por sí misma, una media entre semillas aleatorias.
Las pérdidas referencia / una cabeza / MHAR son 3,031 / 2,970 / 2,969 para 100M; 2,997 / 2,876 / 2,848 para 350M; y 2,894 / 2,759 / 2,754 para 1B. En 350M, la mejora frente a la referencia es 0,149, pero la mejora adicional frente a una cabeza es 0,028. No cabe atribuir toda la ganancia a la división en cabezas.
El apéndice H incluye además un estudio de robustez con tres semillas y FineWeb-Edu bajo otro protocolo. Conviene distinguir esa evidencia adicional de la media de evaluaciones de la tabla principal; tampoco acredita reproducibilidad en cualquier condición.
Los resultados en tareas posteriores no son uniformes
En 1B, al pasar de la referencia a MHAR, la perplejidad en WikiText-2 baja de 56,4 a 45,4 y la exactitud en LAMBADA sube del 8,8 % al 16,0 %. Sin embargo, HellaSwag en 100M baja del 35,0 % al 33,0 %. El artículo advierte de una variación muestral aproximada de ±3 puntos porcentuales en evaluaciones de 200 ejemplos. Las longitudes de contexto también cambian según el tamaño; procede comparar primero dentro de cada escala.
Incorporación a un modelo de 8B ya entrenado
En el preentrenamiento continuado de Marin-8B se conserva el flujo residual original y se añade una rama que encamina incrementos o deltas. Una compuerta de salida inicializada a cero mantiene el cálculo original al convertir el modelo; la diferencia máxima inicial de logits comunicada en fp32 es cero. La nueva ruta empieza a contribuir a medida que aprende a abrirse la compuerta.
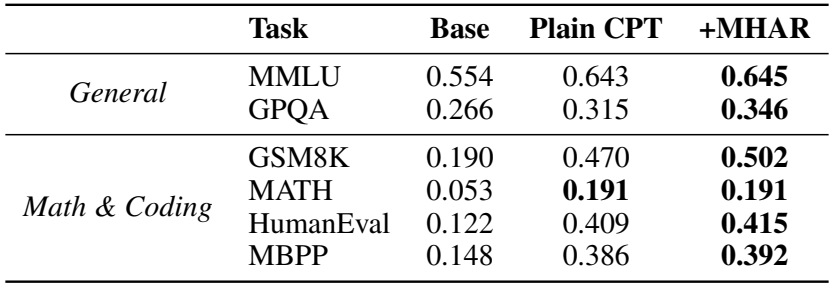
La variante utiliza ocho deltas de bloque al agrupar 32 capas de cuatro en cuatro, más una fuente nula aprendible: ocho cabezas leen como máximo nueve fuentes. No equivale a conservar todas las salidas históricas. El conjunto de datos disponible comprende unos 1,9 billones de tokens, pero el entrenamiento efectivo emplea unos 10.000 millones. La comparación con preentrenamiento continuado ordinario, Plain CPT, iguala calendario, orden de datos y lotes.
Separar el entrenamiento adicional de la aportación de MHAR
En GSM8K, la exactitud es del 19,0 % para el modelo original, del 47,0 % para Plain CPT y del 50,2 % para MHAR: la ganancia adicional es de 3,2 puntos. GPQA pasa del 31,5 % con Plain CPT al 34,6 % con MHAR, una diferencia de 3,1 puntos. Gran parte de la mejora desde el modelo original procede del entrenamiento continuado en sí.
MATH se mantiene en el 19,1 % en ambos casos. Las diferencias en MMLU, HumanEval y MBPP tampoco se describen como estadísticamente claras. Las pruebas pareadas arrojan p = 0,004 en GSM8K y p = 0,038 en GPQA; no sustituyen la repetición con varias semillas en todas las condiciones de uso.
Más cabezas no implica necesariamente mejores resultados
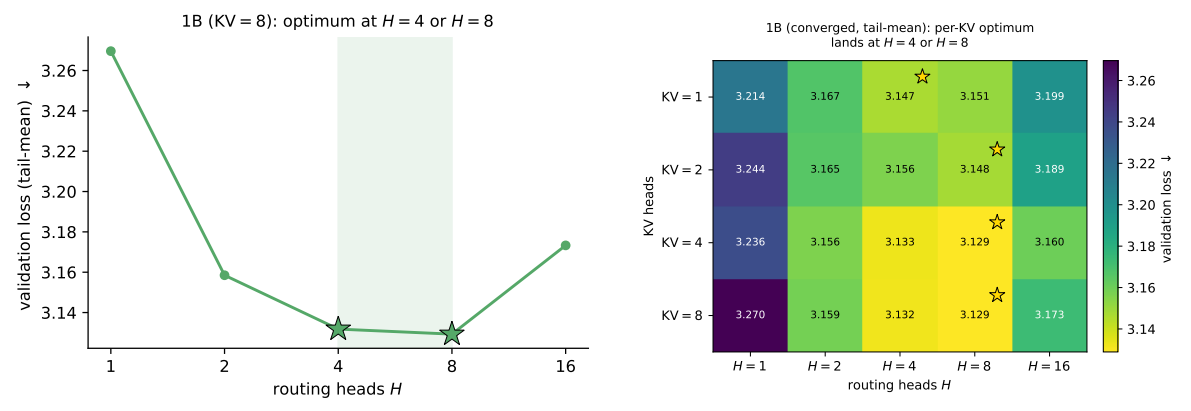
En el ensayo de 1B con corpus web y ocho cabezas KV, las pérdidas con 1, 4, 8 y 16 cabezas de encaminamiento son 3,270, 3,132, 3,129 y 3,173. Cuatro y ocho ofrecen resultados próximos, mientras que dieciséis empeora. Pocos grupos obligan a compartir preferencias; una división excesiva puede separar características que conviene tratar juntas.
Ocho no es una regla universal. La anchura del modelo, la fase de entrenamiento y los datos pueden cambiar la partición adecuada. Los ensayos con corpus web también emplean condiciones de inicialización distintas de las principales, por lo que las diferencias no pueden atribuirse exclusivamente a la distribución de datos.
El tráfico de memoria importa más allá del número de operaciones
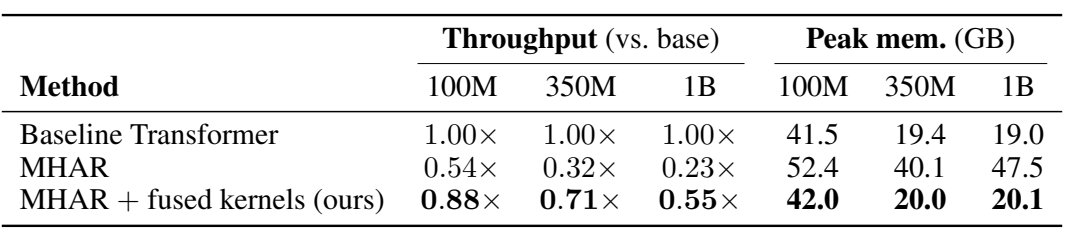
Tomando como 1,00 el rendimiento de entrenamiento de la referencia del mismo tamaño, MHAR sin fusión alcanza 0,54 / 0,32 / 0,23 en 100M / 350M / 1B; con el núcleo fusionado llega a 0,88 / 0,71 / 0,55. La fusión reduce accesos repetidos y almacenamiento intermedio, pero el entrenamiento completo sigue siendo más lento que la referencia.
En 1B, la memoria máxima baja de 47,5 GB a 20,1 GB, cerca de los 19,0 GB de referencia, mientras que el rendimiento permanece en el 55 % del valor de referencia. Acelerar un núcleo de encaminamiento no equivale a acelerar todo el modelo en la misma proporción. Igualar pasos tampoco demuestra superioridad con un presupuesto idéntico de tiempo real.
Alcance y límites de la evidencia
MHAR plantea tanto un diseño para modelos nuevos como una ruta interna adicional para continuar entrenando modelos existentes. No obstante, la evidencia principal se centra en datos ingleses y determinadas arquitecturas y escalas. No acredita por sí sola ventajas en modelos coreanos, sistemas multimodales, servicios de contexto largo o latencia y coste de inferencia en producción.
Sería útil ampliar las repeticiones con distintas semillas bajo el protocolo pertinente, comparar con igual tiempo o cómputo total, separar los efectos de datos e inicialización y medir memoria y latencia de inferencia. Mejores métricas de entrenamiento no prueban automáticamente respuestas más rápidas para el usuario.
Características y efectos desde la perspectiva de patentes
El problema técnico es más concreto que mejorar la exactitud: una distribución común en profundidad no representa plenamente las necesidades de cada subespacio y el acceso repetido añade carga de memoria. La relación central une partición coherente de características, normalización independiente sobre las fuentes, agregación ponderada y recombinación.
La ejecución fusionada reduce tensores intermedios y accesos a memoria. Los deltas de bloque y la compuerta inicializada a cero abordan el número de fuentes y la conservación del comportamiento inicial del modelo preentrenado. Son respuestas a problemas de implementación distintos y no deben fundirse en una afirmación genérica de mejora.
Frente a las conexiones residuales ordinarias, las salidas históricas pasan a seleccionarse individualmente; frente a una cabeza, la selección depende del subespacio; frente a la atención entre tokens, las fuentes se distribuyen en profundidad. Los efectos deben vincularse a esas relaciones y a las condiciones reales de comparación. Este análisis de la aportación técnica no constituye una conclusión de patentabilidad ni afirma que se hayan concedido derechos de patente.
Consideración final
MHAR rediseña quién lee la información calculada, de qué fuentes y en qué proporciones. Su aportación se entiende mejor al valorar conjuntamente la selección por subespacios, la conservación del cálculo preentrenado y el tráfico real de memoria. Una ruta de información prometedora no garantiza una implementación más rápida.
Se conservan las indicaciones y formas originales; su contenido se explica en el texto.
Recursos relacionados: patentes de IA