인공지능 특허 전문 변리사의 논문 분석
작성자: 김용덕 변리사
안녕하세요. 아이피렉스 특허법률사무소, 김용덕 변리사입니다.
오늘은 언어모델이 이전 층에서 계산한 정보를 어떻게 다시 읽을 것인지 다룬 「Multi-Head Attention Residuals」를 분석합니다. 이 논문은 새로운 토큰을 더 많이 학습시키는 문제보다, 이미 모델 내부에 만들어진 정보를 다음 계산에 전달하는 방식에 주목합니다.
MHAR의 핵심은 서로 다른 특징 묶음이 과거 층의 정보를 서로 다른 비율로 선택하게 만드는 것입니다.
이 글에서는 논문의 구조와 실험을 먼저 살펴보고, 마지막에 기술적 과제·해결수단·차별적 구성·기술적 효과를 변리사 관점에서 정리합니다. 아래 수치와 실험 결과는 논문 연구진이 보고한 내용이며, 필자가 직접 수행한 연구나 실험을 의미하지 않습니다.
1. 논문 기본 정보와 핵심 질문
논문 제목: Multi-Head Attention Residuals · 논문 저자: Cheng Luo, Zefan Cai, Junjie Hu · 소속: Independent Researcher 및 University of Wisconsin–Madison · 분석 기준: arXiv:2607.27230v2, 2026년 7월 31일 개정본 · 공개 형태: arXiv 사전 공개 논문 · 원문 라이선스: CC BY 4.0
이 논문을 이해하는 출발점은 단순합니다. 언어모델은 많은 층을 거치면서 문맥과 특징을 계산합니다. 그런데 현재 층이 필요한 정보가 바로 직전 층의 상태에 가장 잘 남아 있다는 보장은 없습니다. 여러 단계 앞에서 만들어진 표현을 현재 목적에 맞게 다시 선택할 수 있다면 어떨까요?
연구진은 이러한 ‘깊이 방향의 정보 선택’을 어텐션으로 구현하고, 하나의 선택 기준을 전체 특징에 공통으로 적용하는 제약을 완화합니다. 여기서 깊이는 문장 길이가 아니라 모델의 층과 서브레이어가 쌓인 방향입니다.
2. 배경: 잔차 연결은 무엇을 전달하는가
2.1 기존 잔차 연결의 장점과 제약
트랜스포머의 잔차 연결은 입력 상태에 현재 계산 결과를 더해 다음 단계로 전달합니다. 이전 정보를 유지하면서 새로운 변화를 누적할 수 있어 깊은 신경망 학습의 중요한 구성입니다. 다만 기본적인 pre-norm 구조에서 각 서브레이어는 이렇게 누적된 최신 상태를 직접 입력받습니다.
이를 여러 사람이 차례로 고쳐 쓰는 하나의 메모에 비유할 수 있습니다. 최신 메모에는 앞선 내용의 흔적이 남아 있지만, 특정 단계의 원래 메모만 따로 꺼내 읽는 인터페이스는 없습니다. 과거 특징이 완전히 사라진다는 뜻이 아니라, 각각의 출력을 독립된 후보로 선택하기 어렵다는 뜻입니다.
2.2 Attention Residuals가 만든 변화
Attention Residuals는 임베딩과 과거 어텐션·MLP 서브레이어 출력을 개별 정보원으로 보관합니다. 현재 위치의 학습 가능한 질의 벡터가 각 정보원의 중요도를 계산하고, 깊이 방향으로 softmax를 적용해 가중합을 만듭니다. 과거 출력을 하나의 메모리처럼 읽는 방식입니다.
그러나 단일 헤드 방식에서는 하나의 깊이 가중치가 전체 특징 차원에 공통으로 적용됩니다. 서로 다른 특징 묶음이 서로 다른 층을 선호하더라도 하나의 분포에 맞춰야 합니다. 논문은 이 제약을 ‘강제된 타협’으로 설명합니다.
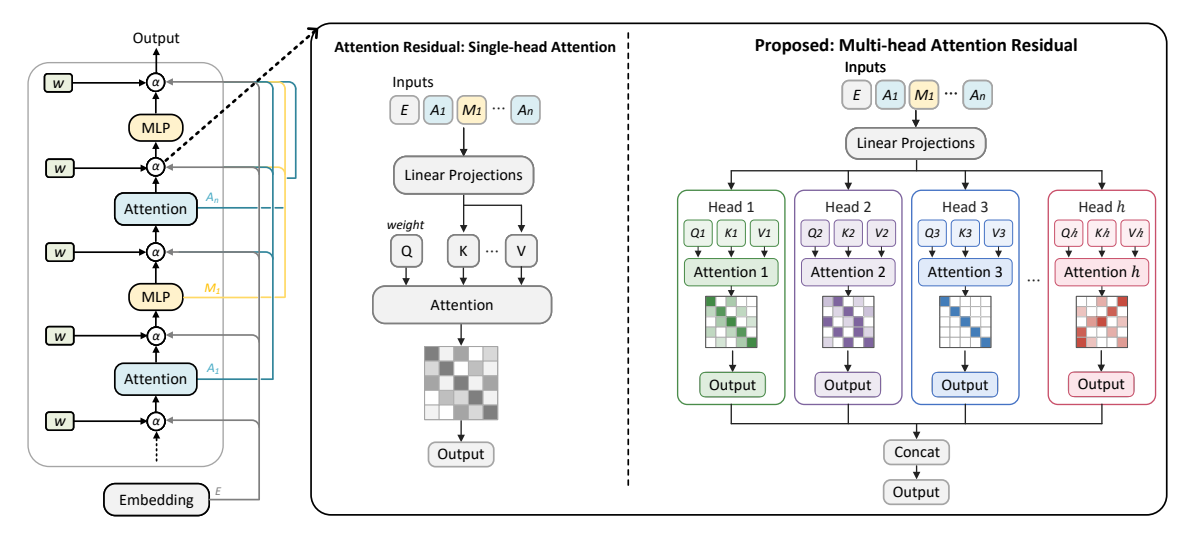
그림 1. 단일 헤드와 다중 헤드의 깊이 정보 읽기 구조. 원문 Figure 1에서 발췌.
그림의 왼쪽은 과거 서브레이어 출력들이 다음 계산에 연결되는 모습을 보여줍니다. 확대된 중앙 부분은 하나의 선택 분포를 사용하는 경우이고, 오른쪽은 여러 특징 부분공간이 각자의 분포로 읽은 뒤 결과를 연결하는 경우입니다. 본문 방법의 핵심은 기존 질의와 특징 차원의 재배치이며, 도식에 표시된 일반적인 어텐션 블록만 보고 별도의 대형 투영망을 추가한다고 해석해서는 안 됩니다.
3. MHAR의 원리: 특징을 나누고, 깊이를 따로 선택한다
3.1 하나의 질의를 여러 부분공간으로 나누기
MHAR는 길이 d인 질의 벡터와 각 정보원의 특징 벡터를 H개 부분으로 나눕니다. 각 헤드는 d/H개 차원을 담당하고, 해당 부분공간에서 과거 정보원에 대한 점수를 계산합니다. 그다음 헤드마다 깊이 방향의 softmax를 독립적으로 수행합니다.
각 헤드가 만든 가중합을 이어 붙이면 다시 길이 d의 입력이 됩니다. 같은 과거 층이라도 어떤 특징 묶음에서는 크게, 다른 특징 묶음에서는 작게 반영할 수 있습니다. 헤드 수 H가 1이면 단일 헤드 Attention Residuals로 돌아갑니다.
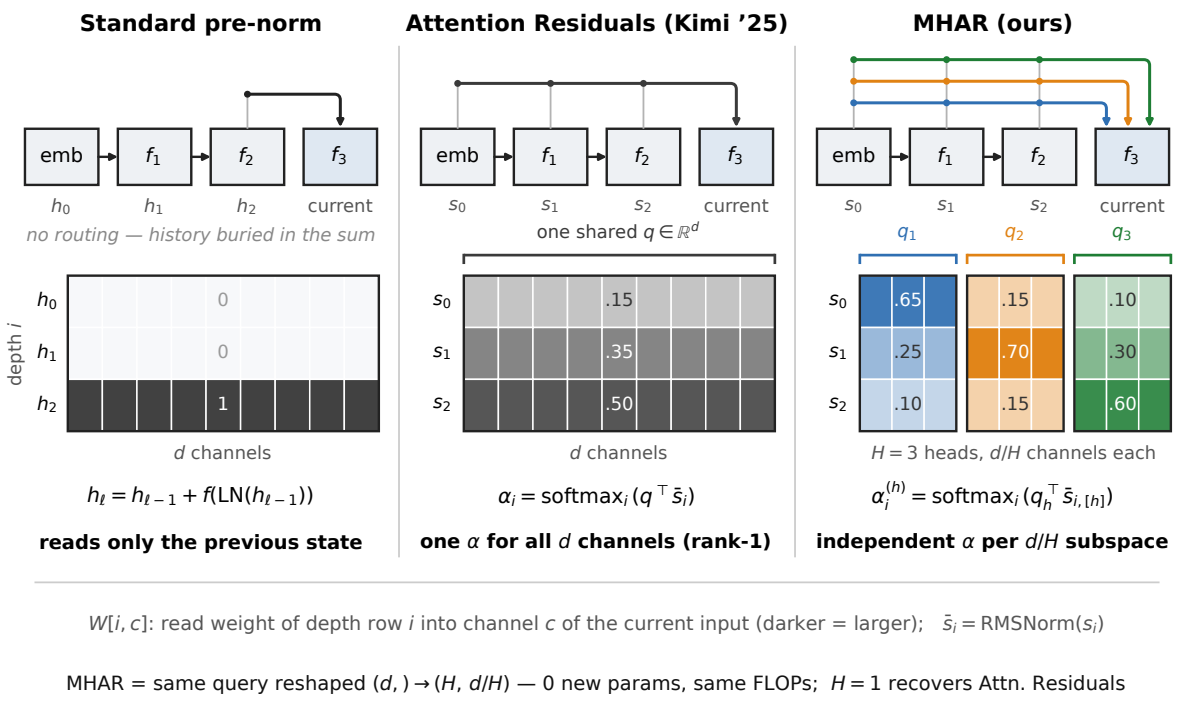
그림 2. 깊이별 읽기 가중치가 달라지는 방식. 원문 Figure 2의 수치는 원리를 설명하는 예시이며 실험 측정값이 아닙니다.
그림 2의 세로축은 과거 정보원, 가로축은 특징 채널입니다. 중앙의 단일 헤드는 모든 열에 동일한 깊이 가중치를 적용합니다. 오른쪽 MHAR에서는 특징 묶음별로 다른 색의 열 블록이 나타납니다. 차별점은 과거 층을 읽는다는 사실 자체보다, 그 선택 규칙을 특징 부분공간별로 분리한다는 데 있습니다.
3.2 토큰 어텐션과 혼동하지 않기
일반적인 멀티헤드 자기어텐션은 문장 안에서 어떤 토큰을 참고할지 계산합니다. MHAR가 나누는 것은 현재 위치에서 과거의 어느 층 출력을 얼마나 읽을지 결정하는 경로입니다. 토큰 사이의 관계를 계산하는 장치와 층 사이의 정보 선택 장치는 서로 다른 축에서 작동합니다.
또한 특정 헤드가 문법, 다른 헤드가 수학을 전담한다고 논문이 입증한 것은 아닙니다. 연구진은 학습된 헤드들이 서로 다른 깊이 선택 패턴을 형성한다는 관찰을 제시합니다. 그것을 곧바로 사람이 붙인 의미 범주별 전문화로 해석하는 것은 별도의 검증이 필요합니다.
4. 실제 처리 순서와 구현상의 의미
첫째, 현재 위치까지 사용할 수 있는 임베딩과 과거 서브레이어 출력을 모읍니다. 아직 계산되지 않은 미래 층의 출력은 읽지 않습니다.
둘째, 정보원에 RMSNorm을 적용해 키로 사용할 표현을 만들고, 질의와 함께 헤드별 부분공간으로 나눕니다. 값으로 합칠 대상은 원래 정보원입니다.
셋째, 헤드별 질의와 키의 적합도를 계산하고, 각 헤드 내부에서 정보원 축으로 softmax를 수행합니다. 헤드 간에 하나의 softmax를 공유하는 방식이 아닙니다.
넷째, 헤드마다 해당 특징 부분의 가중합을 계산한 뒤 이어 붙입니다. 이렇게 얻은 표현을 현재 어텐션 또는 MLP 서브레이어의 입력으로 사용합니다.
처음부터 학습하는 주요 실험에서는 라우팅 질의를 0으로 초기화하므로 시작 시 정보원 선택은 균등한 분포가 됩니다. 이후 학습을 통해 각 위치와 헤드에 맞는 선택 기준이 형성됩니다.
‘추가 파라미터가 없다’는 표현의 비교 대상은 단일 헤드 방식입니다. 일반 트랜스포머와 비교하면 라우팅 질의와 정규화 등에 따른 작은 추가 비용이 있습니다.
논문은 일반 기준 모델 대비 파라미터 증가를 약 0.02%, 이론적 연산량 증가를 약 0.5~1.2%로 보고합니다. 하지만 과거 정보원을 반복해서 읽는 메모리 이동은 별개의 비용입니다. 연구진이 융합 Triton 커널을 함께 제안한 이유도 이 구현상 부담 때문입니다.
5. 처음부터 학습한 모델에서는 무엇이 달라졌나
5.1 실험 조건부터 확인하기
연구진은 100M, 350M, 1B 규모의 Qwen3 계열 구조를 사용해 2만 스텝 동안 모델을 처음부터 학습했습니다. 주요 데이터는 정제·중복 제거된 영어 anneal_pt_v3 말뭉치로, 합성 데이터와 STEM·코드 비중이 높은 구성입니다. 같은 규모 안에서는 데이터, 일정, 배치 등 조건을 맞춰 기본 잔차 연결, Hyper-Connections, 단일 헤드, MHAR를 비교합니다.
주요 손실값은 마지막 5천 스텝 구간의 11회 평가를 평균한 값입니다. 단 한 번의 평가보다 변동을 줄이려는 방식입니다. 다만 여러 무작위 시드의 평균 실험은 아니므로 작은 차이를 곧바로 보편적 우위로 확대해서 읽지 않아야 합니다.
다만 논문 부록 H에는 별도의 FineWeb-Edu 실험 조건에서 세 개 시드를 사용한 추가 강건성 검증도 있습니다. 이 결과는 주요 표의 평가 평균과 구분하여 읽어야 하며, 모든 환경에서의 재현성을 의미하지는 않습니다.
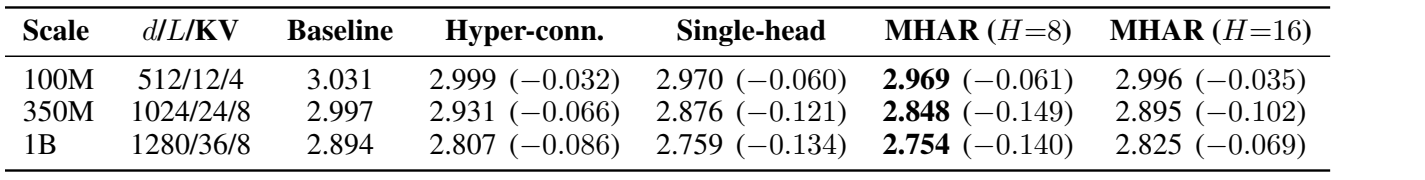
표 1. 처음부터 학습한 모델의 검증 손실. 낮을수록 좋습니다. 원문 Table 1의 표 영역을 발췌.
100M에서는 기본 모델 3.031, 단일 헤드 2.970, MHAR 2.969입니다. 350M에서는 각각 2.997, 2.876, 2.848이며, 1B에서는 2.894, 2.759, 2.754입니다. MHAR는 세 규모에서 기본 모델보다 낮은 손실을 보였습니다.
여기서 기본 모델 대비 개선과 다중 헤드 자체의 추가 효과를 구분해야 합니다. 예를 들어 350M의 기본 모델 대비 차이는 0.149지만, 단일 헤드 대비 추가 차이는 0.028입니다. 100M과 1B에서는 단일 헤드와 MHAR의 차이가 훨씬 작습니다. 개선 전체를 헤드 분할만의 효과라고 설명하면 비교 결과를 과장하게 됩니다.
5.2 손실 감소가 다른 평가에도 이어지는가
별도의 하위 과제 평가에서 1B 모델의 WikiText-2 perplexity는 기본 모델 56.4에서 MHAR 45.4로 낮아졌고, LAMBADA 정확도는 8.8%에서 16.0%로 높아졌습니다. 이는 학습 손실 외 지표에서도 개선 가능성을 보여줍니다.
그러나 모든 항목이 일관되게 좋아진 것은 아닙니다. 100M의 HellaSwag는 35.0%에서 33.0%로 낮아졌고, 논문은 200개 평가 샘플의 약 ±3%포인트 잡음 범위도 함께 언급합니다. 규모별 문맥 길이도 다르므로 서로 다른 규모의 숫자를 단순한 순위표로 비교하기보다 동일 규모 안에서 읽는 것이 타당합니다.
6. 이미 학습된 8B 모델에 붙이는 방법
6.1 처음의 동작을 유지하는 델타 경로
이미 학습된 모델의 정보 전달 방식을 갑자기 바꾸면 기존 동작을 훼손할 수 있습니다. 8B 추가 사전학습 실험에서는 앞서 설명한 대체 방식과 달리 기존 잔차 스트림을 유지하고, 라우팅 결과를 별도의 가산 경로로 더하는 델타 형태를 사용합니다.
추가 경로의 출력 게이트를 0으로 초기화하면 변환 직후에는 원래 모델과 같은 출력을 낼 수 있습니다. 연구진은 시작 시 fp32 기준 최대 로짓 차이가 0이었다고 보고합니다. 학습이 진행되면서 게이트가 열리고 새로운 경로가 작동하는 구조입니다.
또한 이 실험은 모든 과거 서브레이어 출력을 그대로 모으는 방식이 아닙니다. 32개 층을 4개 층씩 묶어 얻은 8개 블록 델타와 학습 가능한 null 정보원을 사용해, 각 위치에서 최대 9개 정보원을 8개 헤드로 읽습니다. 원래 구조의 보존, 정보원 수 제한, 부분공간별 선택이 결합됩니다.
6.2 추가 학습 효과와 MHAR 효과를 분리하기
기준 모델은 Marin-8B이며, 일반 추가 사전학습(Plain CPT)과 MHAR 적용 모델을 같은 학습 일정·데이터 순서·배치로 비교합니다. 전체 데이터 풀은 약 1.9조 토큰이지만, 이 실험에서 실제 학습한 양은 약 100억 토큰입니다. 데이터 풀의 크기를 실제 학습량으로 읽지 않도록 구분해야 합니다.
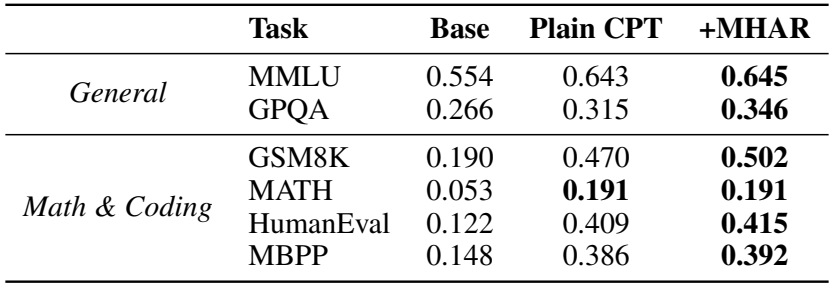
표 2. 8B 추가 사전학습 후 과제별 정확도. 원문 Table 3에서 발췌. MHAR의 추가 기여는 Plain CPT와 비교합니다.
GSM8K는 원래 모델 19.0%, Plain CPT 47.0%, MHAR 50.2%입니다. 따라서 MHAR의 추가 차이는 3.2%포인트입니다. GPQA는 Plain CPT 31.5%에서 MHAR 34.6%로 3.1%포인트 높아졌습니다. 원래 모델에서 최종 모델까지의 전체 증가에는 추가 학습 자체의 효과가 크게 포함되어 있습니다.
반면 MATH는 두 방식 모두 19.1%였습니다. MMLU, HumanEval, MBPP의 수치 차이도 논문에서는 통계적으로 뚜렷하지 않은 것으로 설명합니다. GSM8K와 GPQA의 대응 표본 검정 결과는 각각 p=0.004, p=0.038이지만, 여러 시드 반복으로 모든 환경에서의 재현성을 확인한 결과는 아닙니다.
7. 헤드는 많을수록 좋은가
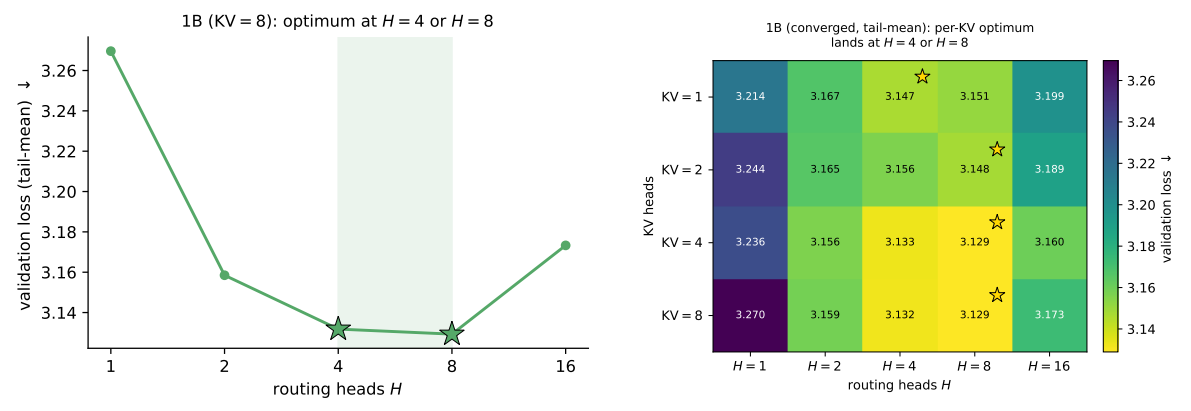
그림 3. 라우팅 헤드 수에 따른 검증 손실 변화. 원문 Figure 5에서 발췌. 앞의 Table 1과 다른 웹 말뭉치 계열 실험이므로 절대 손실값을 섞어 비교하지 않습니다.
그림 3의 1B 실험에서 KV 헤드 수를 8로 고정하면, 라우팅 헤드 1개일 때 손실은 3.270, 4개일 때 3.132, 8개일 때 3.129, 16개일 때 3.173입니다. 4개와 8개가 거의 비슷하게 좋고, 16개로 늘리면 다시 나빠집니다.
헤드가 너무 적으면 서로 다른 특징의 선호를 하나의 선택 분포에 맞춰야 합니다. 반대로 너무 잘게 나누면 함께 처리하는 것이 유리한 특징 묶음까지 분리할 수 있습니다. 따라서 설계 변수는 헤드 수의 최대화가 아니라 적절한 분할 단위입니다.
다만 이 결과를 모든 모델에서 ‘8개가 정답’이라는 규칙으로 바꿀 수는 없습니다. 학습 정도, 모델 폭, 데이터 구성에 따라 최적점이 달라질 수 있습니다. 논문의 웹 말뭉치 계열 실험은 주요 실험과 초기화 조건도 다르므로 데이터 분포 하나만의 효과를 분리한 실험으로 해석하기 어렵습니다.
8. 계산량보다 실제 메모리 이동이 중요하다
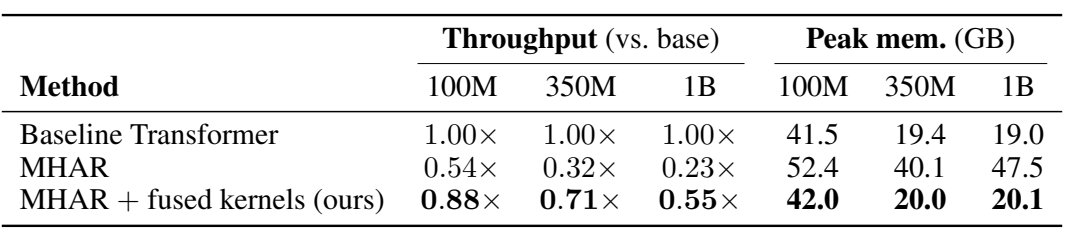
표 3. 학습 처리량과 최대 메모리 사용량. 논문 원문 표 발췌. 처리량은 동일 규모의 기본 트랜스포머를 1.00으로 정규화한 값입니다.
MHAR의 구현 비용은 과거 정보원을 반복해서 읽고 중간 결과를 만드는 과정에서 발생합니다. 융합 커널은 여러 계산을 묶어 이러한 메모리 이동과 중간 저장을 줄입니다. 원문 표에서 일반 구현의 처리량은 기본 모델 대비 0.54배·0.32배·0.23배이고, 융합 커널 적용 후에는 0.88배·0.71배·0.55배입니다.
융합 커널로 큰 폭의 개선이 있었지만 기본 모델보다 여전히 느립니다. 1B의 경우 최대 메모리는 47.5GB에서 20.1GB로 낮아져 기본 모델의 19.0GB에 가까워졌으나, 처리량은 기본 모델의 55% 수준입니다. 메모리 사용량 개선과 실행 시간 개선은 별도로 확인해야 합니다.
또한 라우팅 연산 하나의 가속 배율과 전체 학습 속도의 가속 배율은 다릅니다. 논문에서 제시하는 특정 커널의 배수 개선을 전체 모델 학습이 그만큼 빨라졌다는 뜻으로 옮기면 안 됩니다. 일반 트랜스포머와 같은 스텝 수를 비교한 결과가 같은 실제 시간 예산에서의 우위까지 입증하지는 않습니다.
9. 적용 가능성과 아직 남은 한계
이 구조는 모델을 새로 학습할 때의 정보 전달 설계와, 기존 모델을 추가 학습할 때의 내부 경로 확장이라는 두 방향을 보여줍니다. 새로운 모델의 크기를 늘리는 대신 이미 계산한 표현의 활용 방식을 조정한다는 점에서 의미가 있습니다.
다만 주요 실험은 영어 데이터와 특정 규모·구조에 집중되어 있습니다. 한국어 모델, 멀티모달 모델, 긴 문맥 서비스, 실제 배포 환경의 추론 지연과 비용에 대한 효과를 이 결과만으로 단정할 수 없습니다. 학습 성능 향상이 곧바로 서비스 응답 속도 개선으로 이어지는 것도 아닙니다.
검증을 확대한다면 여러 시드 반복, 동일 실제 시간 또는 동일 총 계산 예산에서의 비교, 다른 데이터·초기화 조건의 분리 실험, 추론 환경의 메모리와 지연 측정이 중요합니다. 이는 논문의 의미를 줄이기 위한 조건이 아니라, 제안된 구성의 효과가 유지되는 범위를 정확히 파악하기 위한 조건입니다.
10. 변리사 관점의 기술 분석
10.1 기술적 과제: 부분공간마다 다른 정보 요구
기술적 과제는 단순히 ‘언어모델의 정확도를 높인다’보다 구체적으로 볼 수 있습니다. 과거 층의 출력을 재사용할 때 전체 특징 차원에 하나의 깊이 선택 분포를 공통 적용하면, 부분공간마다 다른 정보 요구를 충분히 반영하기 어렵다는 문제입니다. 동시에 과거 출력의 반복 접근으로 메모리 이동 부담이 발생합니다.
10.2 해결수단: 분할·독립 선택·재결합
핵심 해결수단은 정보원과 질의를 동일한 특징 분할에 따라 나누고, 각 부분에서 깊이 가중치를 독립적으로 계산한 뒤 가중합을 재결합하는 처리 관계입니다. 각각의 구성요소 이름보다 어떤 축으로 나누고, 어느 축으로 정규화하며, 어떤 출력을 합치는지가 구조를 이해하는 데 중요합니다.
구현 수준에서는 융합 커널로 중간 텐서와 반복 접근을 줄입니다. 기존 8B 모델에 적용할 때에는 블록 델타를 정보원으로 사용하고 0으로 초기화한 게이트를 통해 기존 계산을 보존하면서 추가 경로를 학습합니다. 이들은 서로 다른 적용 상황에서 발생하는 비용과 초기 동작의 문제를 다루는 구성입니다.
10.3 차별적 내용: 같은 메모리를 서로 다르게 읽는 관계
기존 잔차 연결과 비교하면 과거 출력을 개별적으로 선택한다는 점이 다릅니다. 단일 헤드 Attention Residuals와 비교하면 하나의 깊이 분포를 공유하지 않고 부분공간별로 독립 선택한다는 점이 다릅니다. 일반적인 멀티헤드 토큰 어텐션과 비교하면 선택의 대상 축이 토큰이 아니라 과거 층의 출력이라는 점이 다릅니다.
따라서 이 논문의 기술적 차별성은 ‘멀티헤드’라는 이름만으로 설명되지 않습니다. 깊이 메모리, 특징 분할, 헤드별 정규화, 부분별 가중합, 연결이라는 결합관계에서 이해할 수 있습니다. 여기서의 차별성은 논문이 비교한 기술 구성에 대한 설명입니다.
10.4 기술적 효과: 입증된 범위와 비용을 함께 보기
실험으로 확인된 효과는 정해진 학습 조건에서의 검증 손실 감소, 일부 언어·추론 평가의 향상, 8B 추가 학습에서의 특정 과제 개선입니다. 융합 커널의 효과는 일반 MHAR 구현 대비 처리량과 메모리 사용량 개선으로 구분할 수 있습니다.
그 효과를 설명할 때에는 비교 대상을 함께 적어야 합니다. 단일 헤드 대비 헤드 분할의 비용과 일반 모델 대비 라우팅 전체의 비용은 다르고, 동일 스텝에서의 성능 차이와 동일 시간에서의 효율 차이도 다릅니다. 기술적 구성과 관찰된 결과를 이렇게 연결해야 논문의 기여를 과장 없이 정확하게 설명할 수 있습니다.
11. 마무리
MHAR는 모델 안에 이미 존재하는 정보를 누가, 어느 범위에서, 어떤 비율로 읽을 것인지 다시 설계한 연구입니다. 하나의 공통 선택 규칙을 특징 부분공간별 선택 규칙으로 바꾸는 작은 구조 변화가 학습 결과에 영향을 줄 수 있음을 보여줍니다.
동시에 좋은 정보 전달 구조가 곧바로 빠른 실행을 보장하지 않는다는 사실도 드러납니다. 이 논문을 읽을 때에는 부분공간별 선택이라는 아이디어, 기존 모델을 보존하는 연결 방식, 실제 메모리 이동 비용을 함께 보아야 합니다. 그 연결을 살피는 것이 새로운 인공지능 기술의 과제와 해결수단을 이해하는 출발점입니다.
논문과 연구 도표의 저자: Cheng Luo, Zefan Cai, Junjie Hu. arXiv:2607.27230v2, CC BY 4.0. 이 글은 기술 분석이며 특허성 또는 특허권 취득 여부에 대한 판단을 의미하지 않습니다.