
対象論文と研究課題
対象はWhen RAG Hurts: Diagnosing and Mitigating Attention Distraction in Retrieval-Augmented LVLMsです。著者はBeidi Zhao、Wenlong Deng、Xinting Liao、Yushu Li、Nazim Shaikh、Yao Nie、Xiaoxiao Liで、所属はブリティッシュコロンビア大学電気・コンピュータ工学部門、Vector Institute、Roche Diagnosticsです。ICML 2026の論文集PMLR 306、161272–161290頁、識別子pmlr-v306-zhao26gの19頁版を参照します。会期は2026年7月6–11日で、未確認のDOIやarXiv番号は補いません。
視覚言語モデルは、画像だけなら正答できた問題でも、有用な検索文書を加えると誤ることがあります。MAD-RAGは、文書との統合時に画像に基づく表現を保持する研究です。追加学習や検索器の置換ではなく、推論時の内部処理に着目しています。
画像への注意が弱まる二つの現象
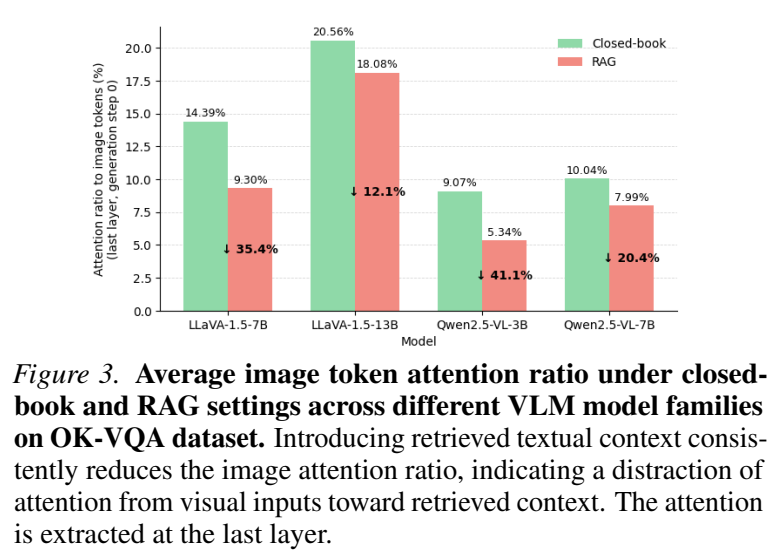
モダリティ間の注意散漫は、テキストを加えると画像トークンへの注意が減る現象です。画像内の注意散漫は、質問に関係する領域から背景等へ注意が移る現象です。猫種の例は、関連文書が正しくても、画像中の対象を適切に捉え続けるとは限らないことを示します。
図3の12.1–41.1%は、画像トークンに配分されたアテンションの相対的な減少率であり、回答正解率の低下ではありません。ヒートマップ分析ではシンクトークンの影響を除いていますが、可視化だけで内部の因果過程すべてが証明されるわけではありません。
入力順序と同じ質問の二重配置
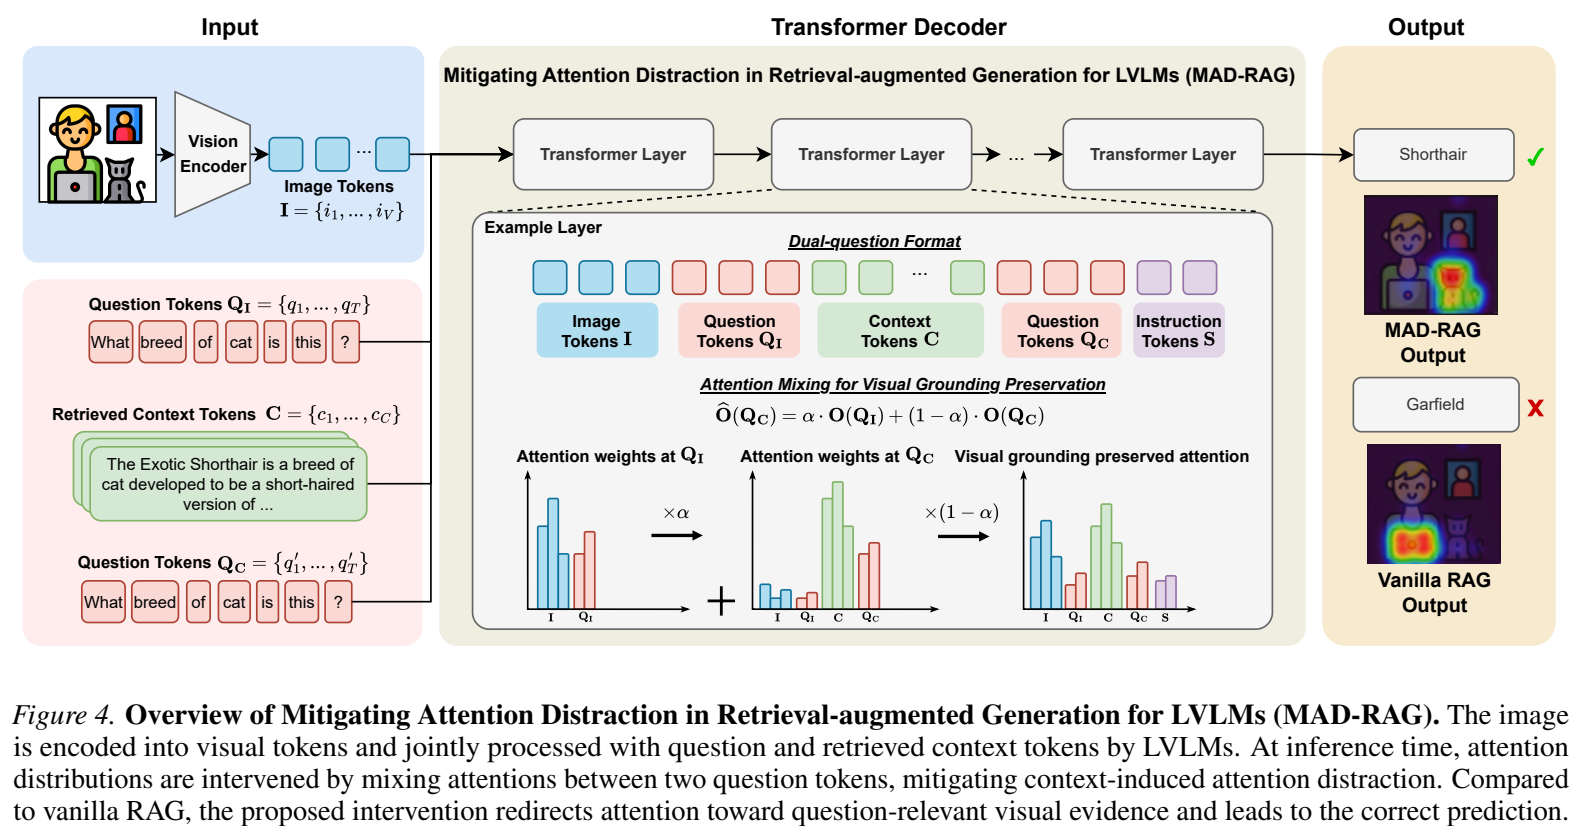
因果的デコーダーの簡略化した入力[I, Q, C]では、質問Qは先行する画像Iを参照できますが、後続する検索文脈Cは参照できません。一方、生成される回答はそれまでの入力全体を参照できます。質問位置の表現と回答生成時に利用できる情報を区別する必要があります。
MAD-RAGは同一の質問を複製し、[I, QI, C, QC]と配置します。前の質問で画像への接地を支え、後の質問で検索内容を統合します。「先に画像の観察を残す」という説明は比喩であり、観察文を別途書かせることや質問文の変更を必須とする手法ではありません。
アテンション出力を混合する処理
各層でnew O(QC) = α O(QI) + (1−α) O(QC)という形で二つの出力を混合し、主要実験ではα = 0.5を使用します。これは内部の推論処理であり、「画像をよく見る」と指示するだけのプロンプト技法でも、重みを再学習する処理でもありません。
OK-VQAのアブレーションでは、通常RAG、質問の後置、質問の複製、MAD-RAGの順に、LLaVA-1.5-7Bは65.46、68.17、69.65、70.22、Qwen2.5-VL-7Bは63.80、61.92、63.85、64.91でした。質問位置の入れ替えだけでは悪化する場合があります。
比較実験の条件
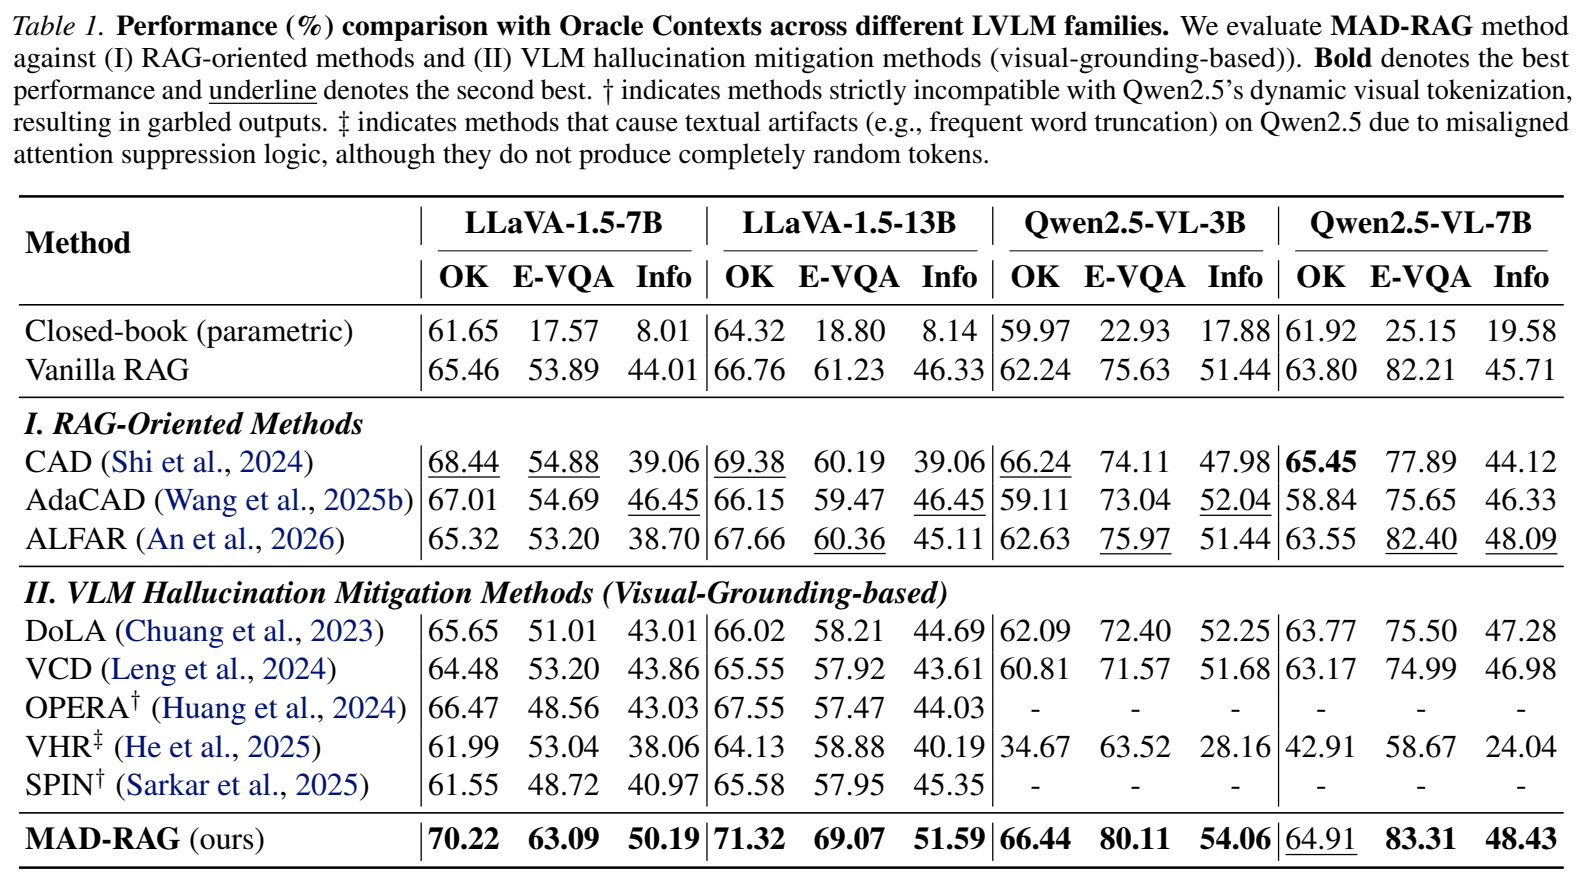
LLaVA-1.5の7B・13B、Qwen2.5-VLの3B・7Bを、OK-VQA、E-VQA、InfoSeekで評価しています。評価問題数はそれぞれ5,046、3,750、4,708件です。単一のNVIDIA A100、貪欲デコーディング、シード0を用い、CAD、AdaCAD、ALFARや視覚ハルシネーション対策と比較しています。一部のQwenとの組合せには非互換や文字出力の乱れがあります。
主要表は検索品質を揃えるためoracle文脈を使いますが、すべて完全な正解文書という意味ではありません。OK-VQAは正解文字列を含むがノイズを伴い得る文脈、E-VQAは作成者提供の関連文書、InfoSeekは確認された画像とWikipediaの対応を用います。この条件の数値を、そのまま実サービス全般の性能とみなすことはできません。
全体スコアの改善と例外
表1のLLaVA-1.5-7Bでは、OK-VQAが65.46→70.22、E-VQAが53.89→63.09、InfoSeekが44.01→50.19です。改善は4.76、9.20、6.18パーセントポイントであり、相対改善率とは異なります。
Qwen2.5-VL-7Bは63.80→64.91、82.21→83.31、45.71→48.43でした。ただし、同モデルのOK-VQAではCADの65.45がMAD-RAGの64.91を上回ります。すべての条件で全手法に勝つとはせず、比較表全体を確認できるよう原図を残しています。
誤答回復率の母集団
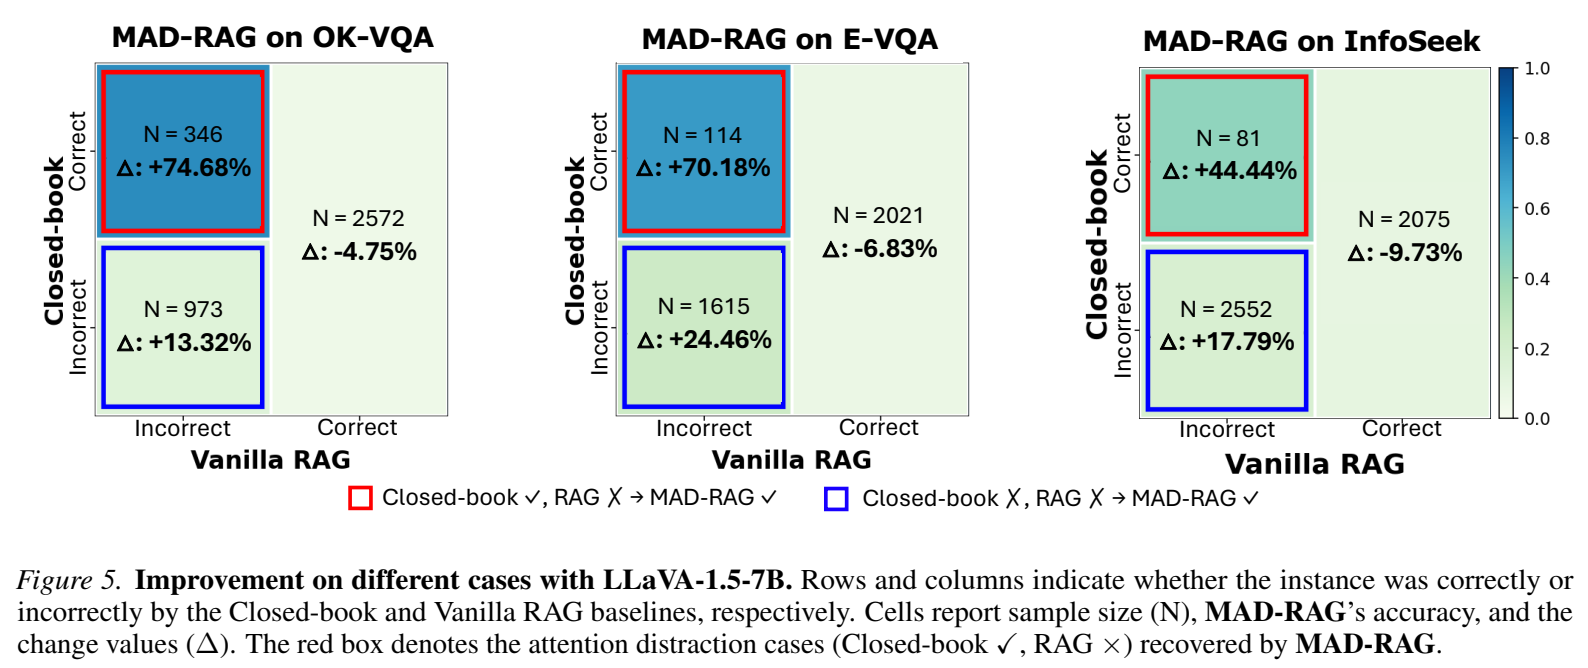
図5は、検索なしでは正答し、通常RAGでは誤答した部分集合を取り出しています。LLaVA-1.5-7Bについて、OK-VQAの346件中74.68%、E-VQAの114件中70.18%、InfoSeekの81件中44.44%が回復しました。これらは該当集合内の割合で、データセット全体の正解率ではありません。
通常RAGで正答していたものが新たに誤答となる割合も、順に4.75%、6.83%、9.73%と報告されています。改善側だけでなく、この失敗側も合わせて評価する必要があります。
実検索と処理時間
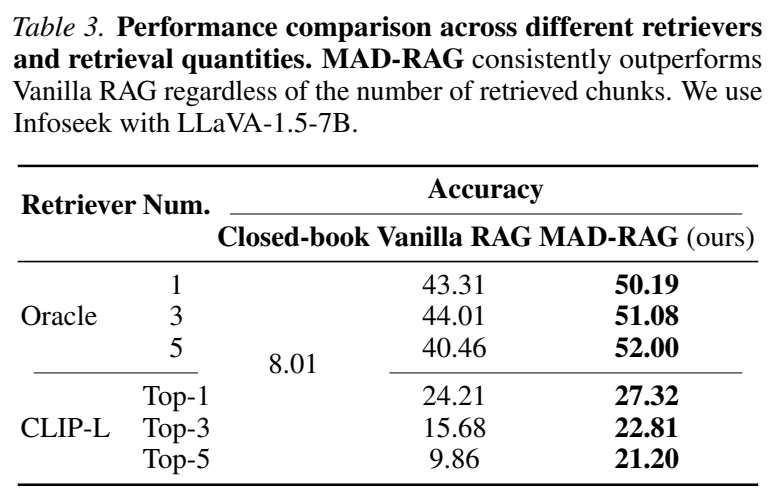
表3はInfoSeekとLLaVA-1.5-7BでCLIP-L検索を使い、通常RAG→MAD-RAGがtop-1で24.21→27.32、top-3で15.68→22.81、top-5で9.86→21.20となりました。各条件では改善しますが、MAD-RAGでも断片数を増やすとtop-1より低下します。検索品質の問題を解消するわけではありません。表1の50.19と、表3のoracle3断片の51.08は別々の報告値として扱います。
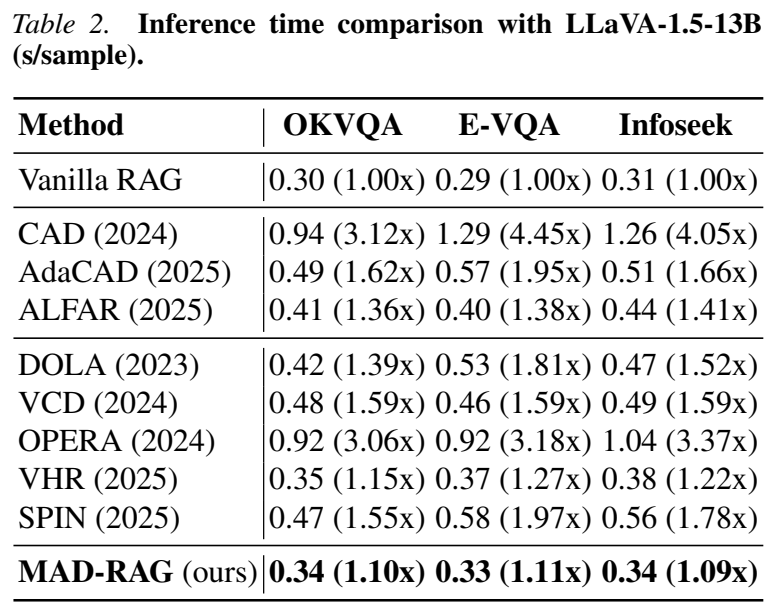
表2のLLaVA-1.5-13Bでは1問当たり0.34、0.33、0.34秒、倍率は1.10倍、1.11倍、1.09倍です。追加負荷は約9–11%で、ゼロではありません。丸められた秒数から倍率が厳密に再現するとは限らず、他システムの遅延を示す数値でもありません。
実装できる範囲と残る課題
手法全体には内部アテンション計算へのアクセスが必要です。非公開APIに同じ質問を繰り返すだけでは同じ処理になりません。元の画像認識が不適切なら、その表現を混ぜることで誤りを引き継ぐ可能性があり、論文の失敗例でも論じられています。
韓国語資料、長文、医療用途、あらゆる運用システムへの効果を一律に確認した研究ではありません。αの適応的な選択や理論的説明は今後の課題です。導入評価では検索品質、画像への接地、介入で生じる誤りを分けて測ることが有用です。
弁理士の視点で捉える技術的差異
課題は必要な文書が足りないことだけではなく、画像に存在していた根拠が情報統合の途中で弱まることです。入力順序と中間表現の具体的な組合せは、出力ロジットの調整や検索器の改善とは異なる構成上の着眼点になります。
発明の説明では、対象の失敗、内部データの流れ、介入方法、条件を明示した効果を整理します。実験上の改善は、新規性・特許性・実施自由を当然に意味しません。先行開示と請求項に照らした検討が別途必要です。
研究成果を読み取るために
MAD-RAGは、テキストを増やすことと同じくらい、画像から得た根拠を保持することが重要であると示しています。文脈の前後に同じ質問を置き、内部出力を混ぜることで、その相互作用を具体的に扱います。
oracleと実検索、全体スコアと選別された失敗例、回復と新規誤答を区別して図表を読むと、寄与と限界が明確になります。条件を残した説明が、技術の正確な理解につながります。
論文の図表は著者らの原図を保持した抜粋です。説明とキャプションは本稿用に作成しています。著作権は論文著者に帰属し、CC BY 4.0に基づき出所を表示します。 Zhao et al., ICML 2026 / PMLR 306:161272–161290 · CC BY 4.0