
El estudio y su objeto
Se examina When RAG Hurts: Diagnosing and Mitigating Attention Distraction in Retrieval-Augmented LVLMs, de Beidi Zhao, Wenlong Deng, Xinting Liao, Yushu Li, Nazim Shaikh, Yao Nie y Xiaoxiao Li. Sus afiliaciones incluyen ingeniería eléctrica e informática de la Universidad de Columbia Británica, Vector Institute y Roche Diagnostics. Se utiliza la versión de diecinueve páginas de ICML 2026, PMLR 306, páginas 161272–161290, identificador pmlr-v306-zhao26g. El congreso se celebró del 6 al 11 de julio de 2026; no se añaden identificadores DOI o arXiv sin verificar.
Un modelo de visión y lenguaje puede acertar una pregunta sobre una imagen y fallar al recibir texto recuperado útil. MAD-RAG estudia esa pérdida de fundamento visual y propone conservar la información condicionada por la imagen durante su integración con documentos, sin entrenamiento adicional ni sustitución del recuperador.
Dos clases de distracción
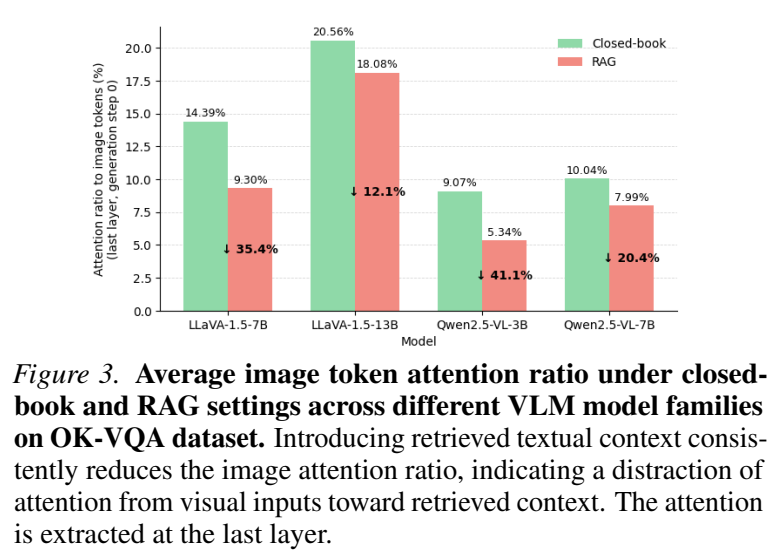
La distracción entre modalidades reduce la atención asignada a los tokens de imagen al introducir texto. La distracción dentro de la imagen desplaza la atención desde zonas relevantes hacia fondos o regiones ajenas a la pregunta. El ejemplo de la raza de un gato muestra por qué disponer de hechos útiles no asegura identificar correctamente el objeto visual.
La figura 3 presenta una reducción relativa del 12.1–41.1% en la atención a los tokens de imagen; no es una caída de exactitud de respuesta. El análisis de mapas elimina efectos de tokens sumidero, pero una visualización no demuestra por sí sola todo el mecanismo causal.
Orden de entrada y duplicación de la pregunta
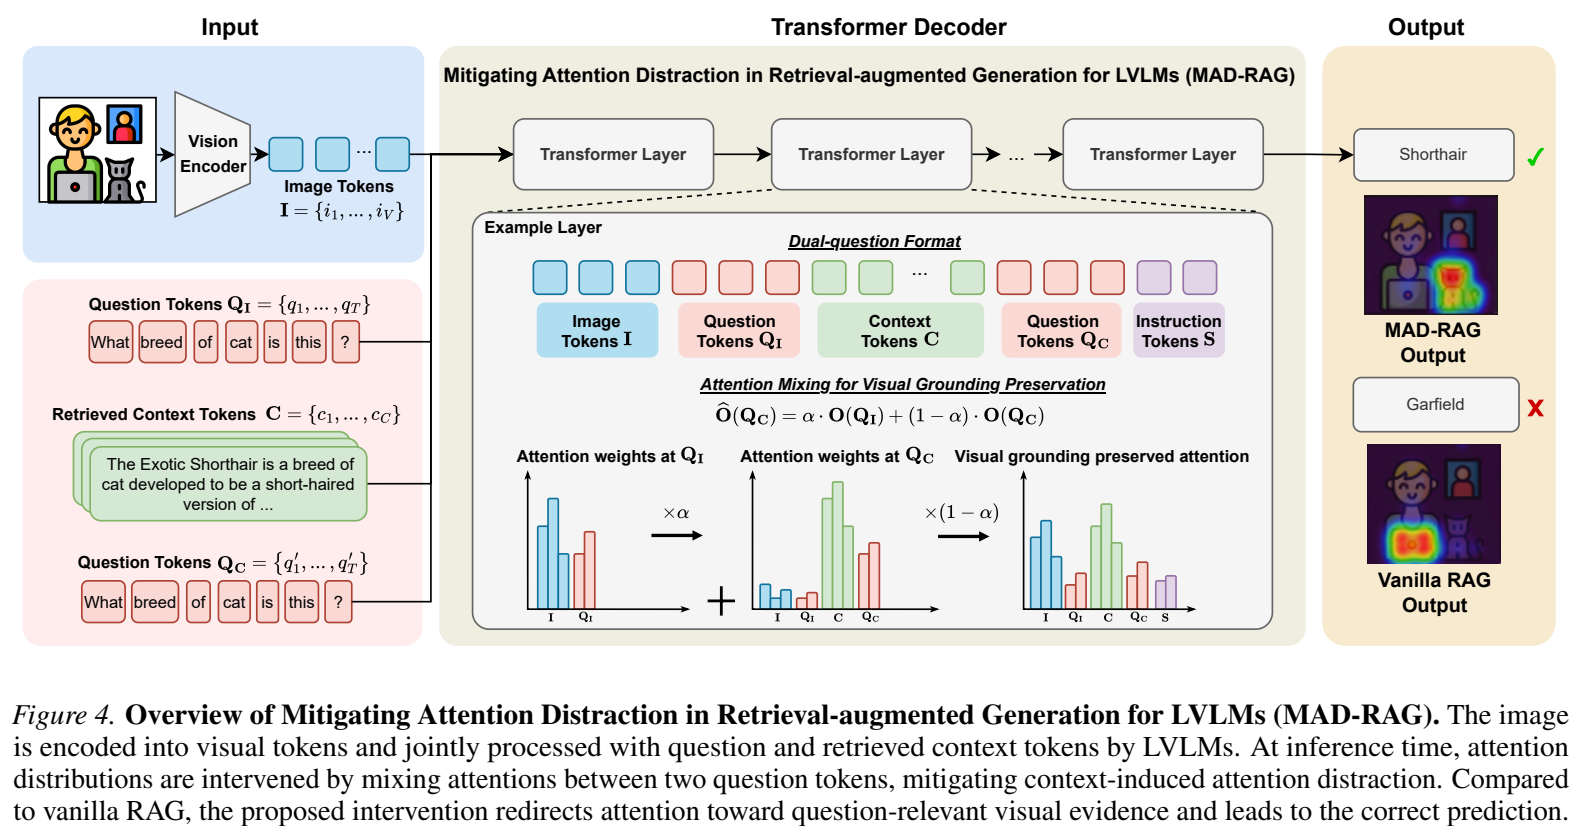
En un decodificador causal con la secuencia simplificada [I, Q, C], los tokens de pregunta Q pueden atender a la imagen anterior I, pero no al contexto posterior C. Al generar la respuesta sí están disponibles las entradas previas completas. Debe distinguirse la representación de la pregunta de la información accesible durante la generación.
MAD-RAG duplica la misma pregunta en [I, QI, C, QC]. La primera copia favorece el anclaje visual y la segunda integra el contexto recuperado. Hablar de conservar una observación de la imagen es una analogía explicativa: no se exige redactar previamente una observación ni cambiar la pregunta.
La intervención en las salidas de atención
En cada capa se combina new O(QC) = α O(QI) + (1−α) O(QC), con α = 0.5 en los experimentos principales. Se modifica una operación interna durante la inferencia; no basta con pedir por escrito que el modelo mire mejor, ni se trata de entrenar sus pesos.
La ablación de OK-VQA compara RAG ordinario, pregunta pospuesta, pregunta duplicada y MAD-RAG completo. LLaVA-1.5-7B obtiene 65.46, 68.17, 69.65 y 70.22; Qwen2.5-VL-7B obtiene 63.80, 61.92, 63.85 y 64.91. Cambiar únicamente el orden puede empeorar el resultado.
Condiciones de evaluación
Se emplean LLaVA-1.5-7B/13B y Qwen2.5-VL-3B/7B en OK-VQA, E-VQA e InfoSeek, con 5,046, 3,750 y 4,708 preguntas evaluadas, respectivamente. Se utiliza una NVIDIA A100, decodificación voraz y semilla 0. Los comparadores incluyen CAD, AdaCAD, ALFAR y métodos contra alucinaciones visuales; algunas combinaciones con Qwen son incompatibles o generan anomalías textuales.
La tabla principal utiliza contextos oracle para controlar la calidad de recuperación. No todos equivalen a una verdad perfecta: OK-VQA incorpora cadenas de respuesta potencialmente ruidosas; E-VQA, documentos pertinentes facilitados por sus autores; e InfoSeek, asociaciones verificadas de imágenes y Wikipedia. Esos resultados no deben presentarse como rendimiento incondicional en producción.
Puntuaciones globales y excepciones
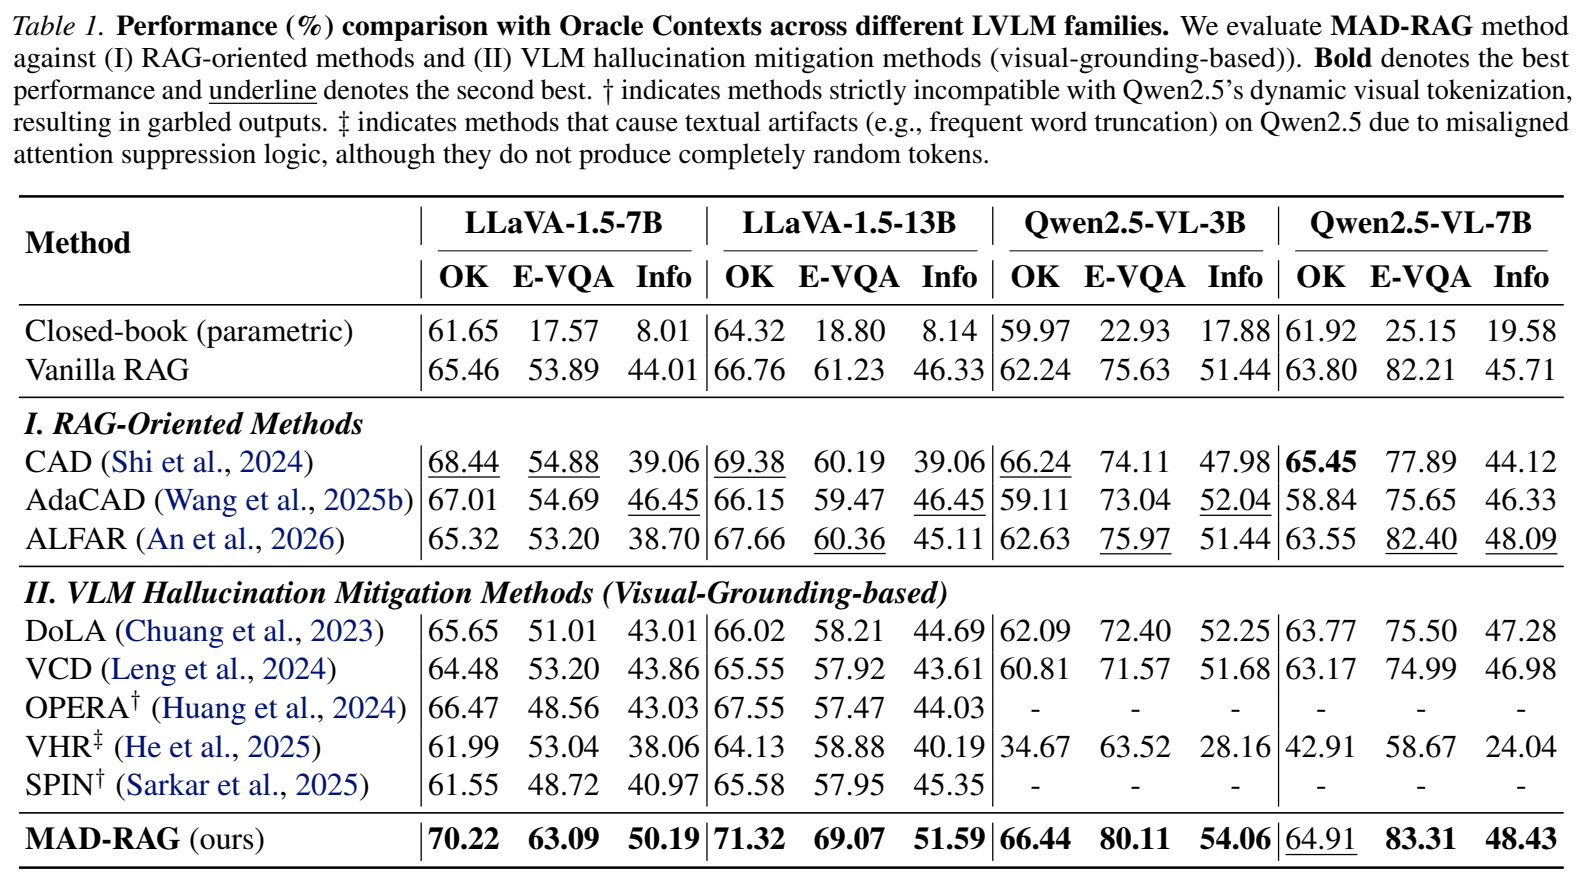
Para LLaVA-1.5-7B, la tabla 1 indica 65.46→70.22 en OK-VQA, 53.89→63.09 en E-VQA y 44.01→50.19 en InfoSeek. Son aumentos de 4.76, 9.20 y 6.18 puntos porcentuales, no porcentajes relativos de mejora.
Qwen2.5-VL-7B pasa de 63.80→64.91, 82.21→83.31 y 45.71→48.43. No se supera a todos los métodos en cada celda: CAD alcanza 65.45 en el OK-VQA de Qwen, por encima de 64.91. Se conserva la tabla original para permitir una lectura completa.
Qué significa recuperar errores
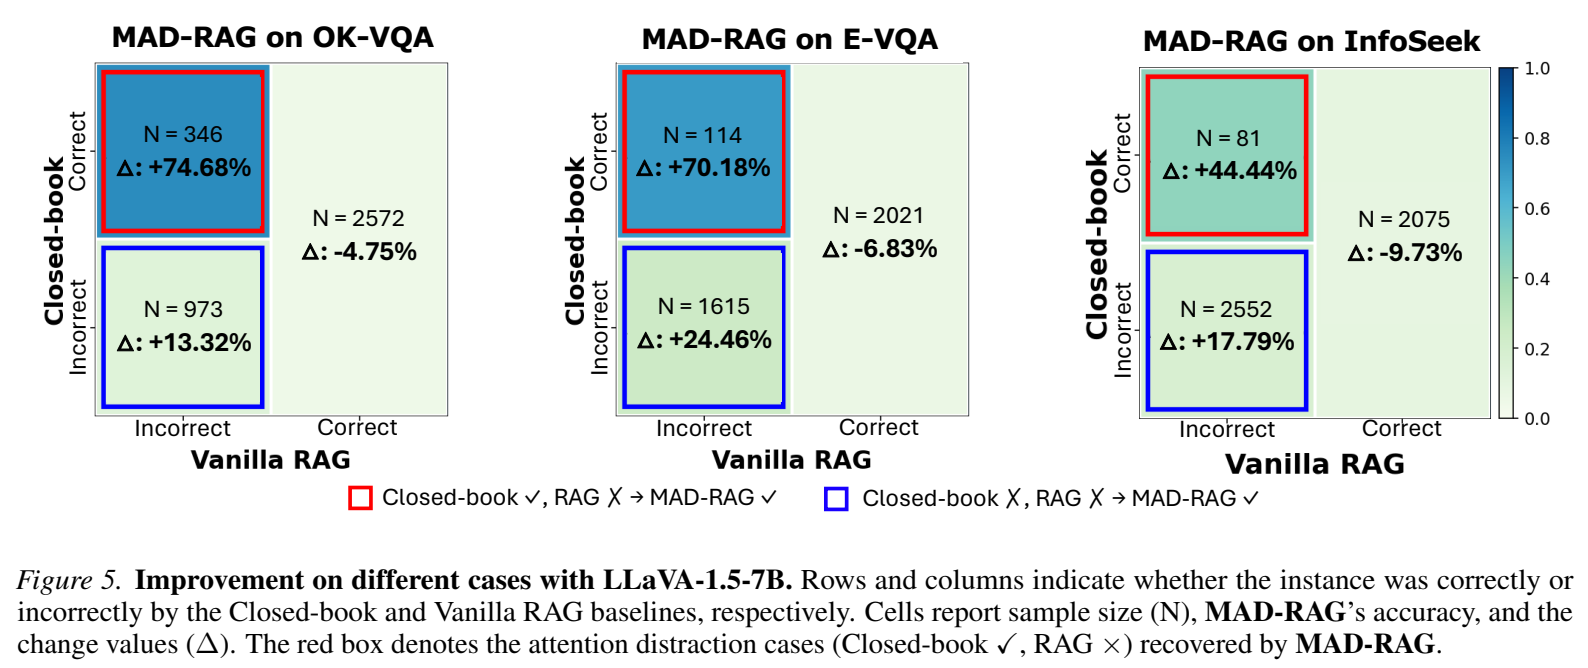
La figura 5 separa las preguntas acertadas sin recuperación y falladas con RAG ordinario. Con LLaVA-1.5-7B se recupera el 74.68% de 346 casos de OK-VQA, el 70.18% de 114 de E-VQA y el 44.44% de 81 de InfoSeek. Esas tasas corresponden a subconjuntos concretos y no a la exactitud global.
También se pierden respuestas que RAG ordinario acertaba: las tasas reportadas son 4.75%, 6.83% y 9.73%, respectivamente. Deben considerarse tanto los errores corregidos como los nuevos, sin describir el procedimiento como una corrección sin contrapartidas.
Recuperación real y coste
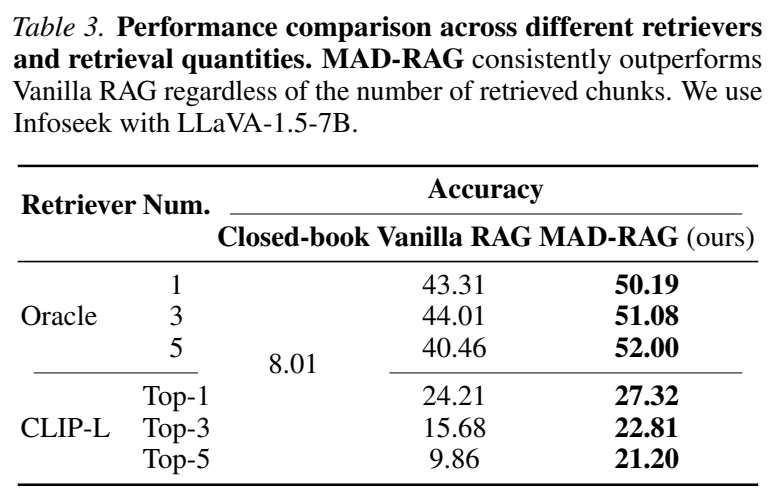
La tabla 3 evalúa CLIP-L en InfoSeek con LLaVA-1.5-7B. RAG ordinario→MAD-RAG arroja 24.21→27.32 con top-1, 15.68→22.81 con top-3 y 9.86→21.20 con top-5. Hay mejora en cada comparación, pero añadir fragmentos todavía reduce el resultado respecto de top-1; no desaparece el problema de recuperación. El 50.19 de la tabla 1 y el 51.08 del oracle de tres fragmentos de la tabla 3 se mantienen como valores distintos.
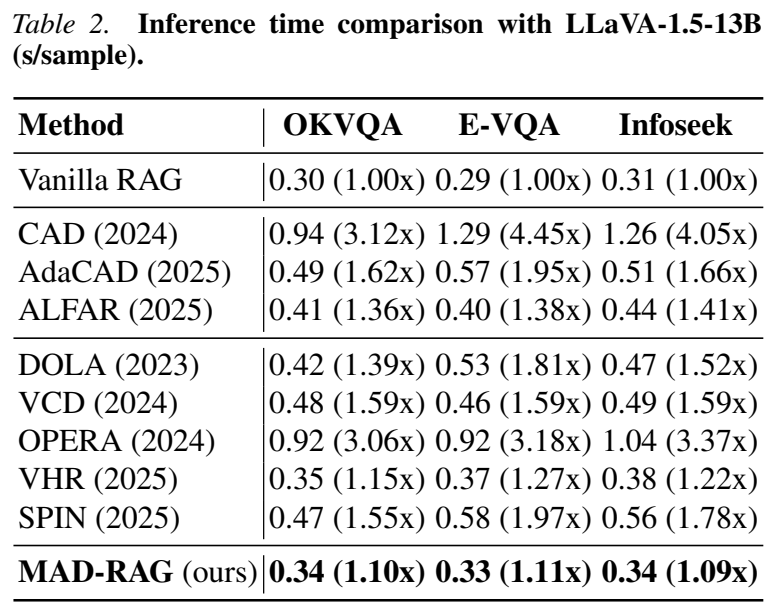
La tabla 2, con LLaVA-1.5-13B, informa de 0.34, 0.33 y 0.34 segundos por muestra y factores de 1.10×, 1.11× y 1.09×. El sobrecoste indicado es aproximadamente del 9–11%, no nulo. Los tiempos redondeados no necesariamente reproducen los factores exactos, ni permiten deducir la latencia de otras aplicaciones.
Límites de implementación
El método completo requiere acceso al cálculo interno de atención. Repetir una pregunta mediante una API comercial cerrada no implementa esa intervención. Si la base visual inicial es errónea, mezclarla con la representación posterior puede propagar errores, como muestra el análisis de fallos.
No se ha acreditado su eficacia para toda documentación coreana, documentos extensos, tareas médicas o sistemas desplegados. La elección adaptativa de α y una explicación teórica más profunda siguen siendo líneas de trabajo. Una evaluación útil separará calidad de recuperación, fundamento visual y errores introducidos.
Lectura desde la práctica de patentes
El problema no consiste únicamente en carecer de documentos: la evidencia que ya contiene la imagen puede debilitarse durante la fusión. El orden de entrada y la combinación específica de representaciones intermedias son decisiones técnicas diferentes de ajustar logits de salida o mejorar el recuperador.
Una memoria técnica debe explicar el fallo, el flujo de datos afectado, la intervención y sus efectos bajo condiciones expresas. Un beneficio experimental no determina por sí mismo novedad, patentabilidad o libertad de operación; sigue siendo necesario contrastar las divulgaciones anteriores y las reivindicaciones pertinentes.
La contribución en su contexto
MAD-RAG muestra que conservar evidencia visual puede ser tan relevante como aportar más texto. Situar la misma pregunta a ambos lados del contexto y mezclar las salidas de atención proporciona una intervención concreta para estudiar esa relación.
Las figuras deben leerse distinguiendo oracle y recuperación real, puntuaciones totales y subconjuntos de fallos, y respuestas recuperadas frente a nuevas equivocaciones. Estas condiciones permiten explicar con precisión tanto la contribución como sus límites.
Las figuras y tablas son extractos que conservan el contenido original; las explicaciones y los pies se han adaptado. Los autores mantienen los derechos y se atribuye la fuente conforme a CC BY 4.0. Zhao et al., ICML 2026 / PMLR 306:161272–161290 · CC BY 4.0