
研究对象与问题
本文解读When RAG Hurts: Diagnosing and Mitigating Attention Distraction in Retrieval-Augmented LVLMs,作者为Beidi Zhao、Wenlong Deng、Xinting Liao、Yushu Li、Nazim Shaikh、Yao Nie和Xiaoxiao Li,所属机构包括不列颠哥伦比亚大学电气与计算机工程部门、Vector Institute及Roche Diagnostics。依据ICML 2026正式论文集PMLR第306卷161272–161290页的19页版本,标识为pmlr-v306-zhao26g;会议日期为2026年7月6–11日,不添加未核实的DOI或arXiv编号。
视觉语言模型可能在只看图片时答对,加入有用检索文本后反而答错。MAD-RAG关注文档整合过程中视觉依据被削弱的问题,通过推理阶段的内部干预保留图像条件信息,不要求额外训练或更换检索器。
注意力分散的两种形式
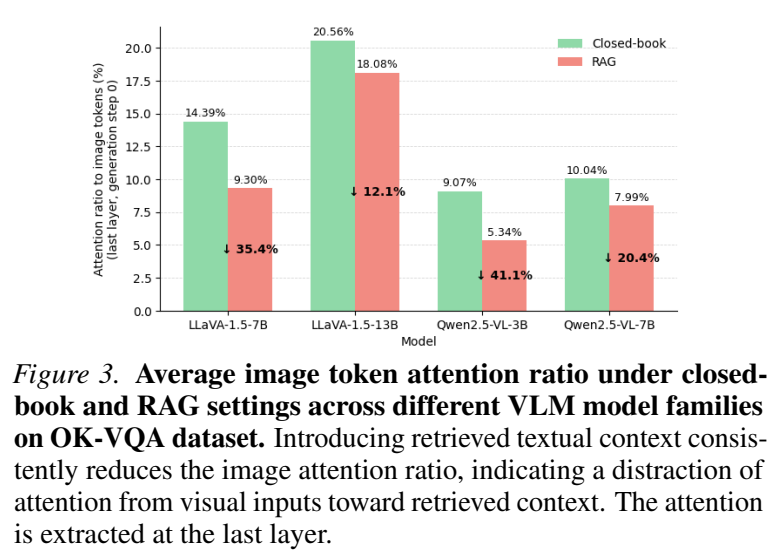
跨模态分散是指加入文本后,分配给图像词元的注意力降低;图像内部分散则表现为从与问题相关的区域移向背景或无关位置。猫品种示例说明,文档包含有用事实,也不保证模型始终看准图像对象。
图3的12.1–41.1%是图像词元注意力占比的相对下降,不是回答准确率的下降。热图分析去除了注意力汇聚词元的影响,但可视化本身并不能完整证明内部因果过程。
输入顺序与双问题设计
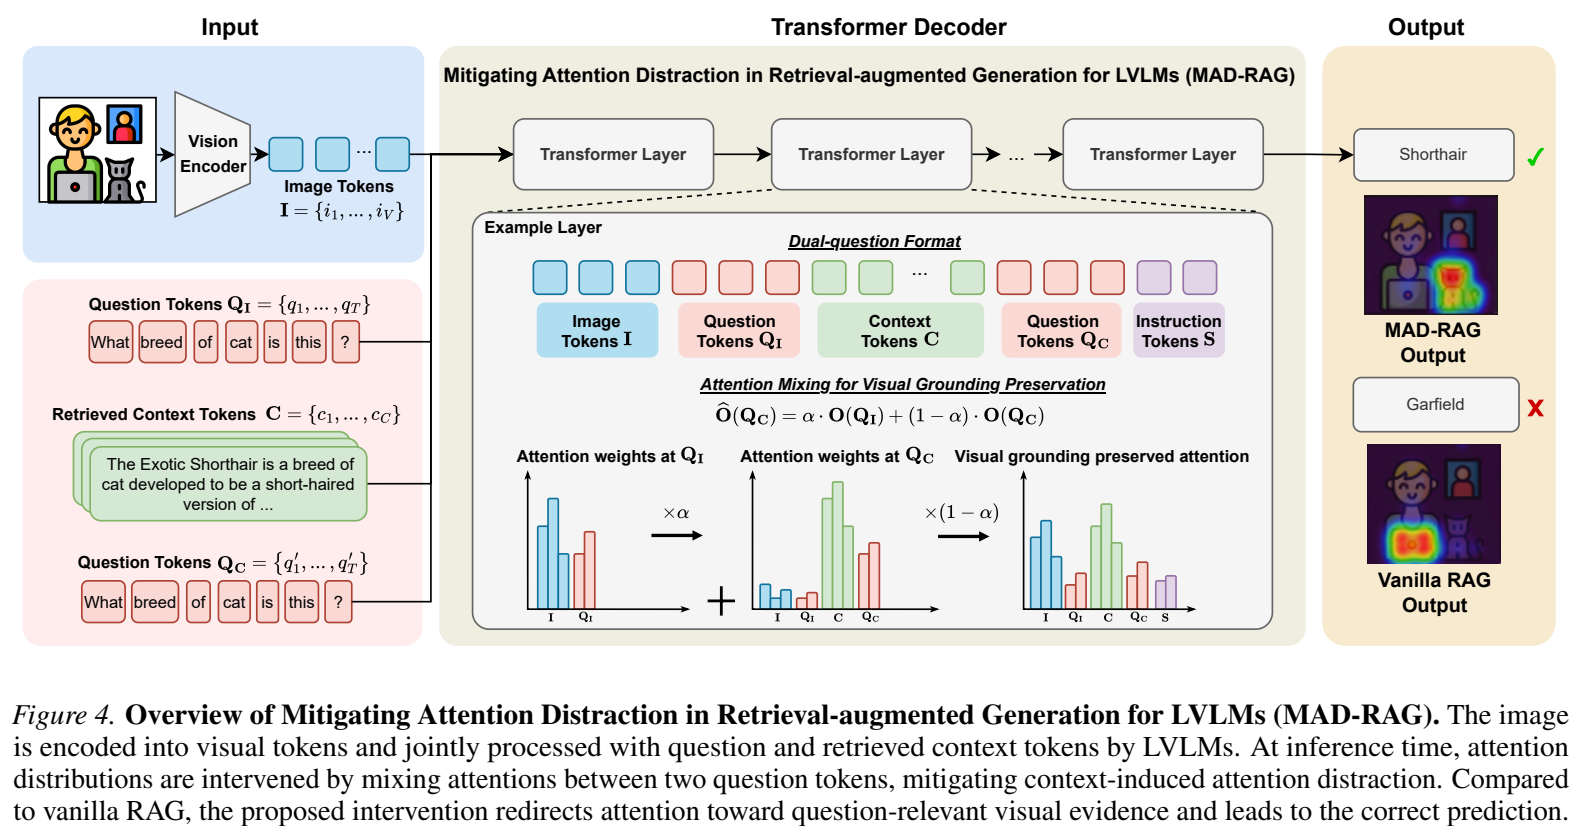
在因果解码器的简化序列[I, Q, C]中,问题Q能看到之前的图像I,不能看到之后的检索上下文C;生成答案时则能够访问前面的全部输入。因此,问题位置的表示与答案生成阶段可用的信息并不相同。
MAD-RAG将同一问题复制为[I, QI, C, QC]。前一份侧重建立视觉依据,后一份整合检索信息。“先保留对图片的观察”是一种解释比喻,不表示必须先输出一段观察文字,也不要求改写问题内容。
在内部混合注意力输出
方法在各层按new O(QC) = α O(QI) + (1−α) O(QC)混合两处注意力输出,主要实验取α = 0.5。这是推理时内部计算的改变,不是仅通过提示词要求“仔细看图”,也不是训练模型权重。
OK-VQA消融比较了普通RAG、问题后置、复制问题和完整方法。LLaVA-1.5-7B依次为65.46、68.17、69.65、70.22;Qwen2.5-VL-7B依次为63.80、61.92、63.85、64.91。可见,单纯改变问题位置也可能造成退步。
实验究竟比较了什么
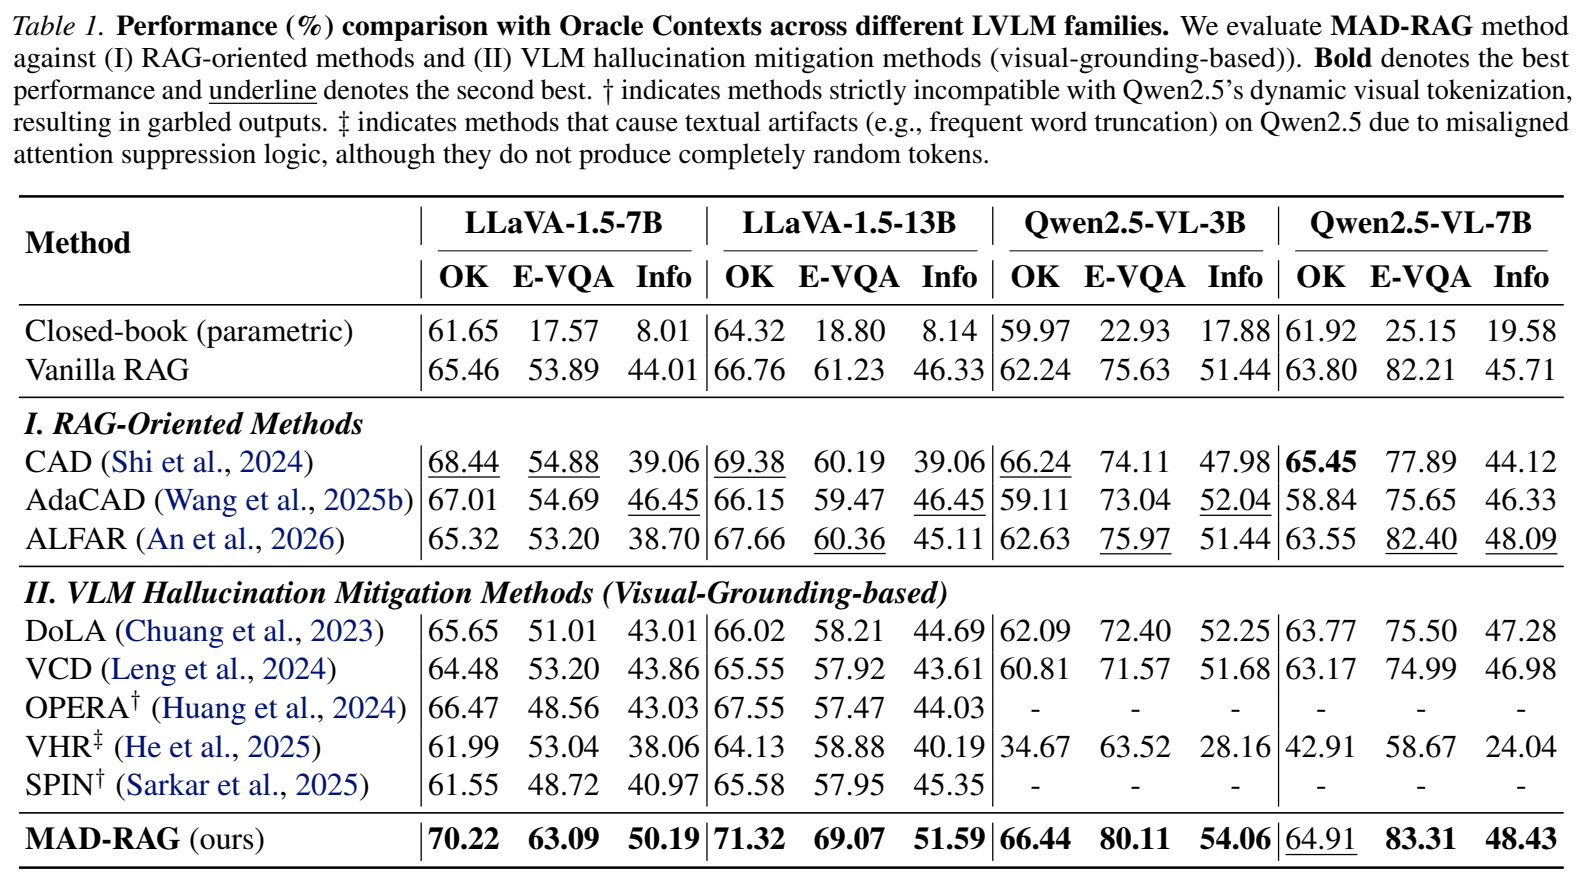
模型为LLaVA-1.5-7B/13B与Qwen2.5-VL-3B/7B;OK-VQA、E-VQA、InfoSeek的评价问题数分别为5,046、3,750、4,708。实验使用单张NVIDIA A100、贪心解码及随机种子0,并比较CAD、AdaCAD、ALFAR和视觉幻觉缓解方法。部分方法与Qwen组合不兼容或产生文本异常。
主表使用oracle上下文以控制检索质量,但不等于所有文档都是完美真值。OK-VQA上下文包含答案字符串且可能有噪声,E-VQA使用作者提供的相关文档,InfoSeek采用核实的图像与Wikipedia对应关系。不能把这些条件下的结果直接当作任意生产系统表现。
整体分数及其例外
表1中,LLaVA-1.5-7B在OK-VQA上由65.46升至70.22,E-VQA由53.89升至63.09,InfoSeek由44.01升至50.19。增加的是4.76、9.20、6.18个百分点,并非相对百分比。
Qwen2.5-VL-7B对应为63.80→64.91、82.21→83.31、45.71→48.43。方法并非在每格结果中领先所有对照:其OK-VQA的64.91低于CAD的65.45。保留原表有助于读者完整理解比较,而不是只看最高增幅。
恢复率属于特定错误子集
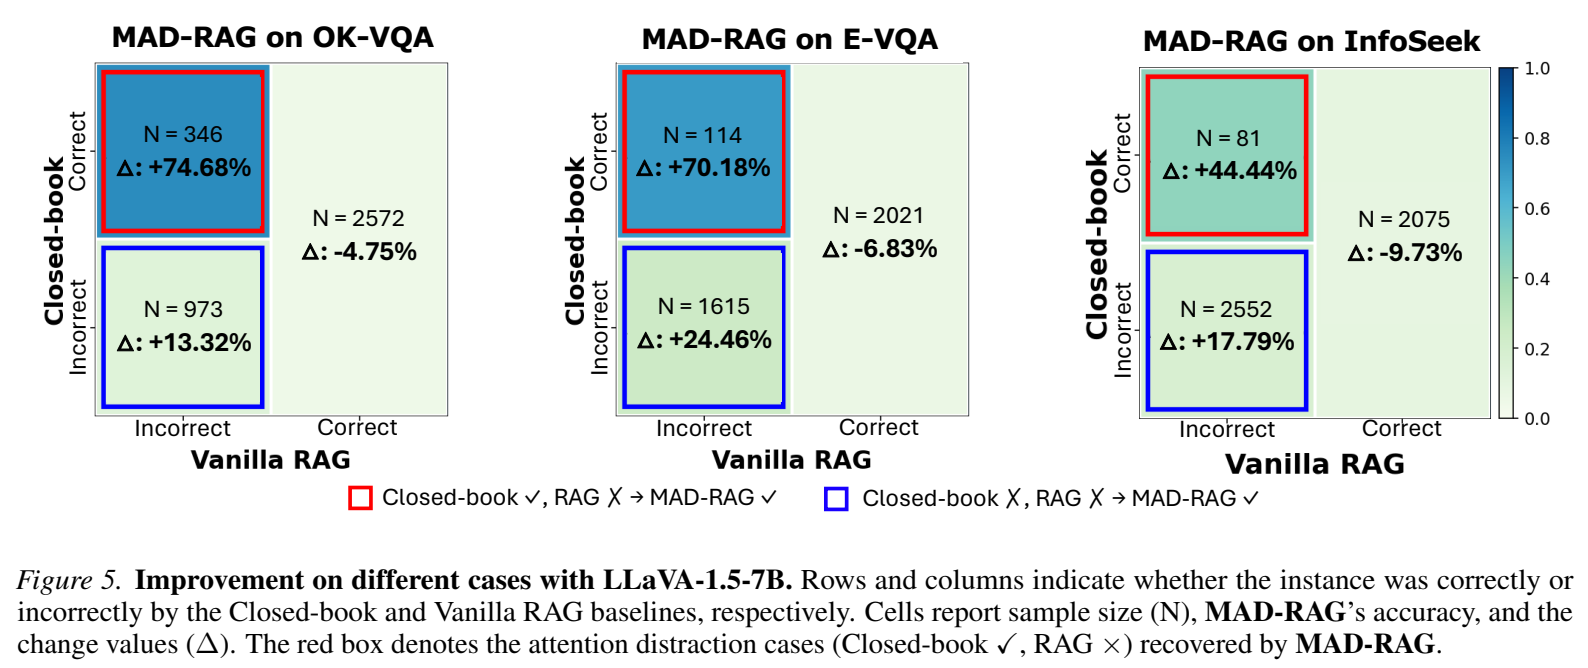
图5筛出“不检索时答对、普通RAG答错”的问题。LLaVA-1.5-7B在OK-VQA的346个此类样本中恢复74.68%,E-VQA的114个中恢复70.18%,InfoSeek的81个中恢复44.44%。这些比例不是整个数据集的准确率。
普通RAG原本答对、经干预后答错的情况也存在,报告比例依次为4.75%、6.83%、9.73%。评价时应同时观察纠错收益和新增错误,不能将其描述为只纠错而无损失的机制。
真实检索与计算成本
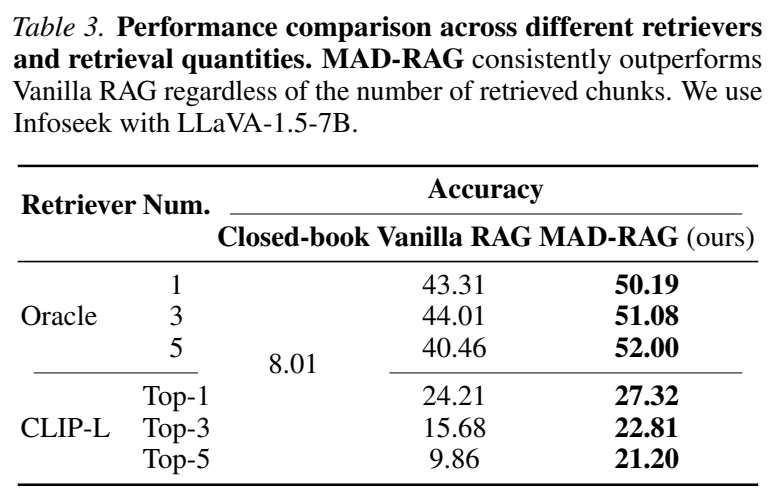
表3在InfoSeek、LLaVA-1.5-7B及CLIP-L检索条件下,top-1的普通RAG→MAD-RAG为24.21→27.32,top-3为15.68→22.81,top-5为9.86→21.20。每组有改善,但增加片段后,MAD-RAG分数仍低于top-1,说明它不能消除检索质量问题。表1的50.19与表3中oracle三片段的51.08分别保留,不擅自统一数值。
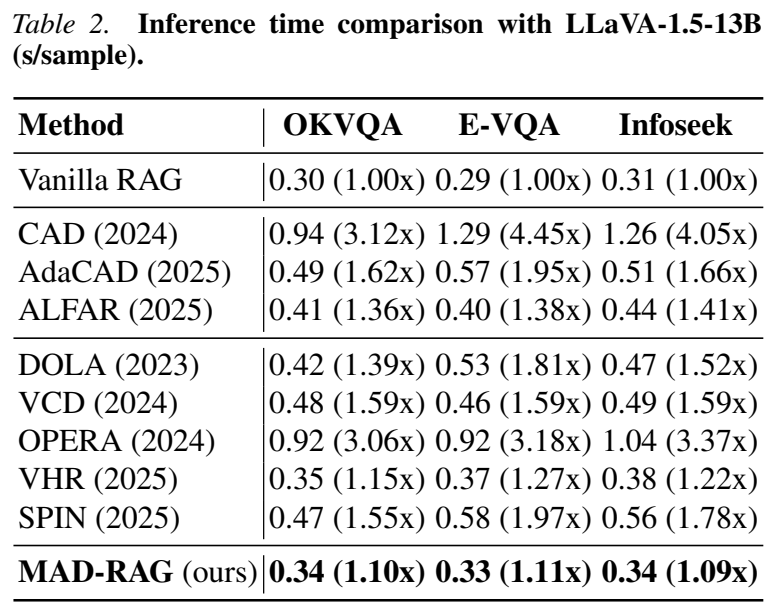
表2使用LLaVA-1.5-13B,每样本耗时为0.34、0.33、0.34秒,倍率为1.10、1.11、1.09,约增加9–11%,并非零开销。四舍五入的秒数未必能精确复现倍率,也不能推断其他系统的延迟。
实现边界与局限
完整方法需要访问内部注意力计算。通过封闭商业API重复问题,并不等于实现了相同干预。如果初始视觉依据本身错误,混合它可能继续传播错误,论文的失败分析也指出这一风险。
论文没有验证所有韩文资料、长文档、医疗任务或实际业务系统。自适应选择α、更深入的理论解释仍属研究方向。部署评价应把检索质量、视觉依据及干预引入的错误分别测量。
从专利实务看技术差异
问题不仅是缺少资料,也可能是已有图像证据在信息融合中被削弱。输入顺序与中间表示的特定组合属于具体实现选择,区别于只调输出logits或提高检索器质量。
技术交底宜明确故障模式、受影响的数据流、干预位置以及特定条件下的效果。论文中的实验收益并不直接证明新颖性、可专利性或自由实施,仍需结合在先公开和实际权利要求分析。
如何把握研究贡献
MAD-RAG表明,保留已经获得的视觉依据,与提供更多文本同样值得关注。把相同问题放在上下文两侧并混合内部注意力输出,为研究这一相互作用提供了具体方式。
阅读图表时,应区分oracle与真实检索、整体分数与筛选出的错误集合、被修复与新产生的错误。保留这些条件,才能准确说明技术贡献及其边界。
论文图表为保留原始内容的摘录,说明与图注为本文撰写。版权归论文作者,按CC BY 4.0注明来源。 Zhao et al., ICML 2026 / PMLR 306:161272–161290 · CC BY 4.0