
Исследование и поставленная задача
Рассматривается работа When RAG Hurts: Diagnosing and Mitigating Attention Distraction in Retrieval-Augmented LVLMs. Авторы: Beidi Zhao, Wenlong Deng, Xinting Liao, Yushu Li, Nazim Shaikh, Yao Nie и Xiaoxiao Li; организации включают подразделение электротехники и компьютерной инженерии Университета Британской Колумбии, Vector Institute и Roche Diagnostics. Использована версия ICML 2026 объёмом 19 страниц: PMLR 306, с. 161272–161290, идентификатор pmlr-v306-zhao26g. Конференция проходила 6–11 июля 2026 года; неподтверждённые DOI и номера arXiv не добавляются.
Визуально-языковая модель может правильно ответить по изображению и ошибиться после получения полезного найденного текста. MAD-RAG исследует потерю визуальной опоры при объединении информации и сохраняет представления, обусловленные изображением, без дополнительного обучения и замены поискового компонента.
Два вида отвлечения внимания
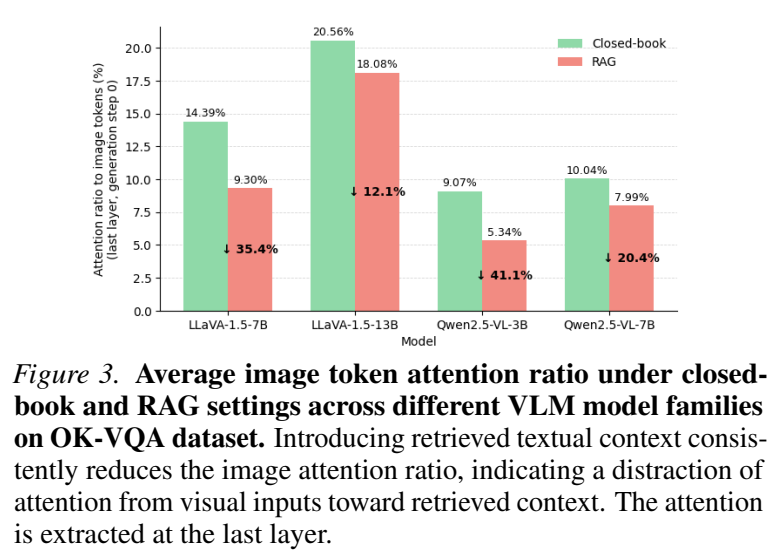
Межмодальное отвлечение уменьшает внимание к токенам изображения после добавления текста. Внутри изображения внимание смещается с значимых для вопроса областей на фон или посторонние участки. Пример с породой кошки показывает: полезные сведения в документе ещё не гарантируют правильного определения визуального объекта.
На рисунке 3 приведено относительное уменьшение доли внимания к изображению на 12.1–41.1%, а не снижение точности ответов. При анализе карт убирается влияние токенов, концентрирующих внимание, однако сама визуализация не доказывает весь причинный механизм.
Порядок входов и два экземпляра вопроса
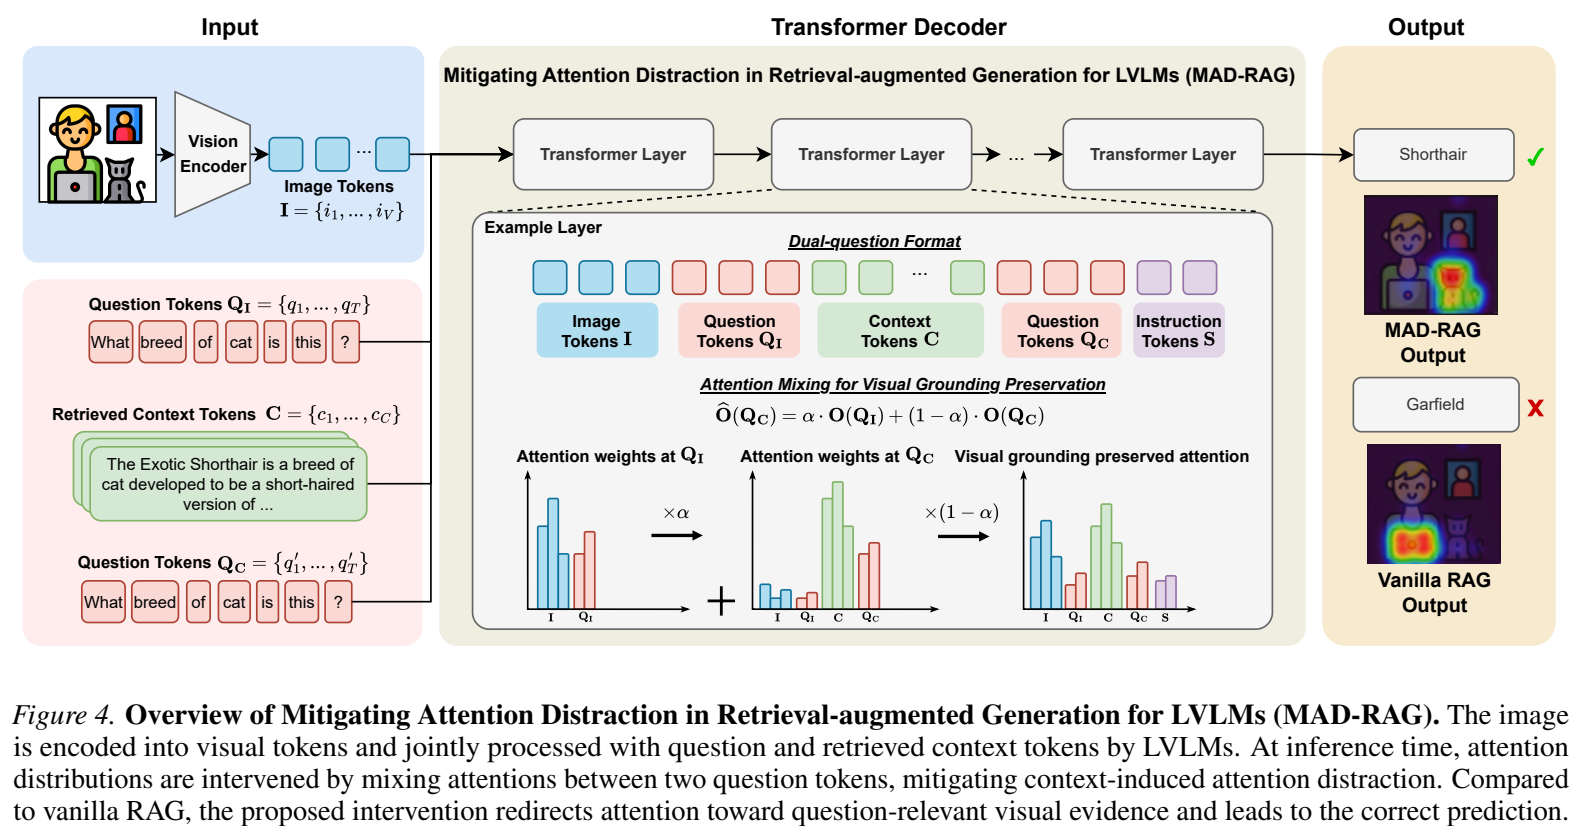
В причинном декодере для упрощённой последовательности [I, Q, C] токены вопроса Q видят предшествующее изображение I, но не последующий найденный контекст C. Генерируемый ответ может использовать все предшествующие входы. Поэтому представление вопроса и доступная при генерации информация — не одно и то же.
MAD-RAG повторяет тот же вопрос: [I, QI, C, QC]. Первый экземпляр формирует визуальную опору, второй объединяет её с контекстом. Образ «сначала сохранить наблюдение» служит пояснением: метод не требует отдельного письменного описания увиденного и не меняет формулировку вопроса.
Смешивание внутренних выходов внимания
На каждом слое применяется new O(QC) = α O(QI) + (1−α) O(QC), в основных опытах α = 0.5. Это вмешательство во внутренний расчёт при выводе, а не только инструкция внимательнее смотреть на картинку и не обучение весов.
Абляция на OK-VQA сравнивает обычный RAG, перенос вопроса, его дублирование и полный MAD-RAG. Для LLaVA-1.5-7B результаты составили 65.46, 68.17, 69.65 и 70.22; для Qwen2.5-VL-7B — 63.80, 61.92, 63.85 и 64.91. Один лишь перенос вопроса способен ухудшить качество.
Условия экспериментов
LLaVA-1.5-7B/13B и Qwen2.5-VL-3B/7B проверялись на OK-VQA, E-VQA и InfoSeek с 5,046, 3,750 и 4,708 оценочными вопросами. Использовались одна NVIDIA A100, жадное декодирование и seed 0. Сравнение включало CAD, AdaCAD, ALFAR и методы подавления визуальных галлюцинаций; некоторые сочетания с Qwen несовместимы либо создают текстовые артефакты.
Основная таблица использует oracle-контексты для контроля качества поиска. Это не всегда идеальные достоверные документы: OK-VQA содержит строки ответов и возможный шум, E-VQA — релевантные документы авторов набора, InfoSeek — проверенные связи изображений с Wikipedia. Такие показатели нельзя без условий переносить на производственную эксплуатацию.
Общие оценки и исключения
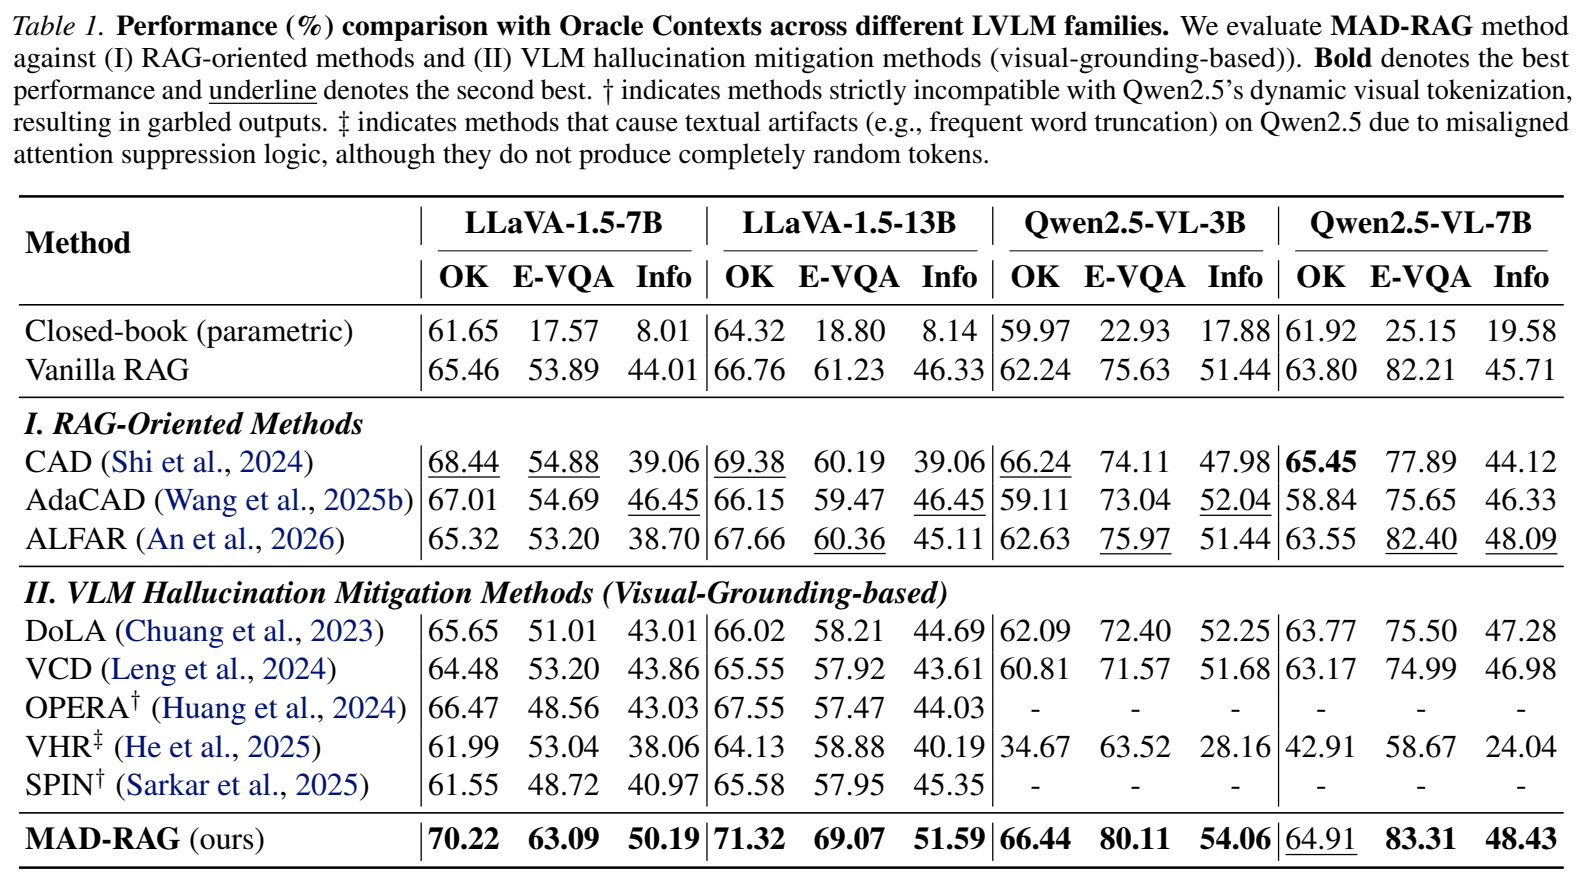
В таблице 1 LLaVA-1.5-7B улучшает OK-VQA с 65.46 до 70.22, E-VQA с 53.89 до 63.09 и InfoSeek с 44.01 до 50.19. Прирост составляет 4.76, 9.20 и 6.18 процентного пункта, а не относительных процента.
Для Qwen2.5-VL-7B изменения равны 63.80→64.91, 82.21→83.31 и 45.71→48.43. Метод не лучший в каждой ячейке: CAD получает 65.45 на OK-VQA с Qwen против 64.91 у MAD-RAG. Исходная таблица сохранена для оценки всей картины.
К какой группе относится доля исправлений
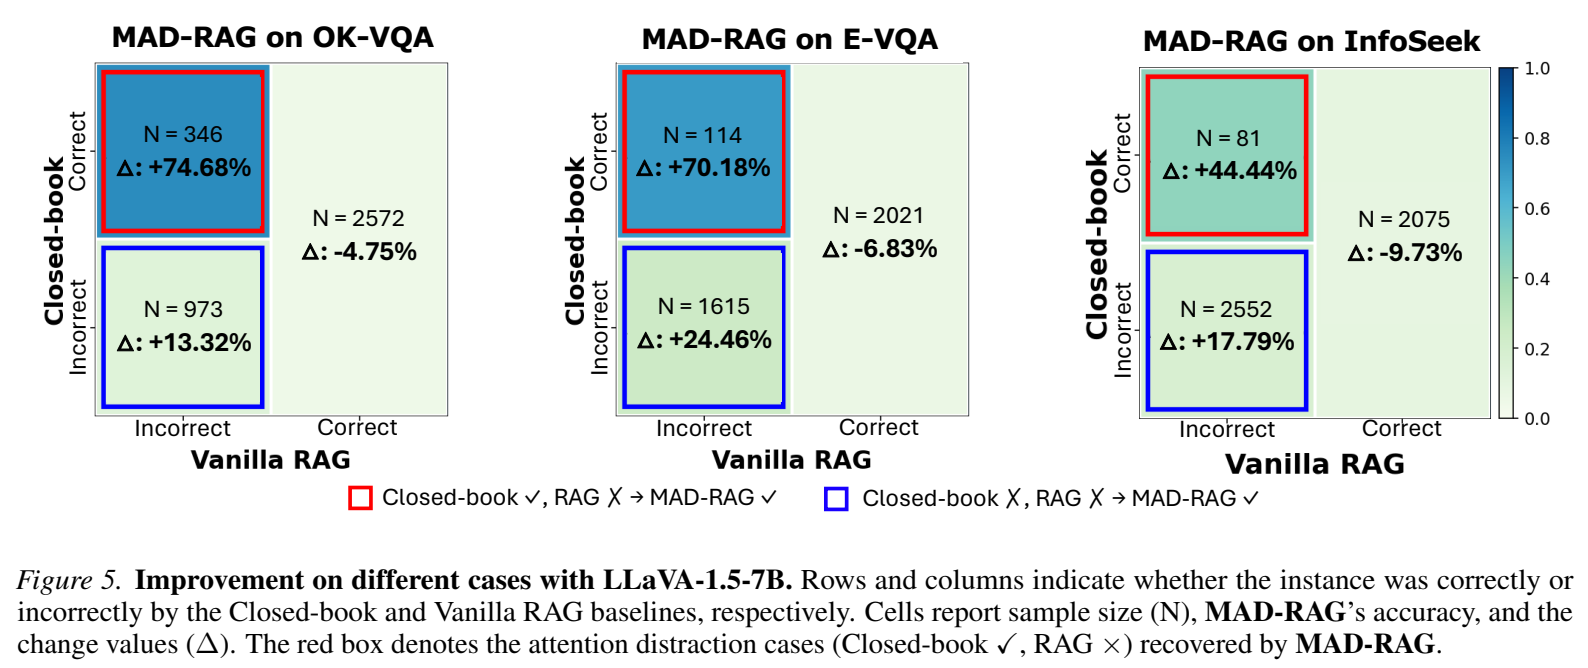
Рисунок 5 выделяет вопросы, на которые модель без поиска ответила правильно, а обычный RAG — неправильно. С LLaVA-1.5-7B исправлены 74.68% из 346 таких случаев OK-VQA, 70.18% из 114 E-VQA и 44.44% из 81 InfoSeek. Это доли внутри выбранных подмножеств, не общая точность тестов.
Есть и новые ошибки там, где обычный RAG отвечал правильно: соответственно 4.75%, 6.83% и 9.73%. Вмешательство следует оценивать по исправлениям и потерям вместе, а не представлять как безусловное улучшение каждого ответа.
Реальный поиск и вычислительные затраты
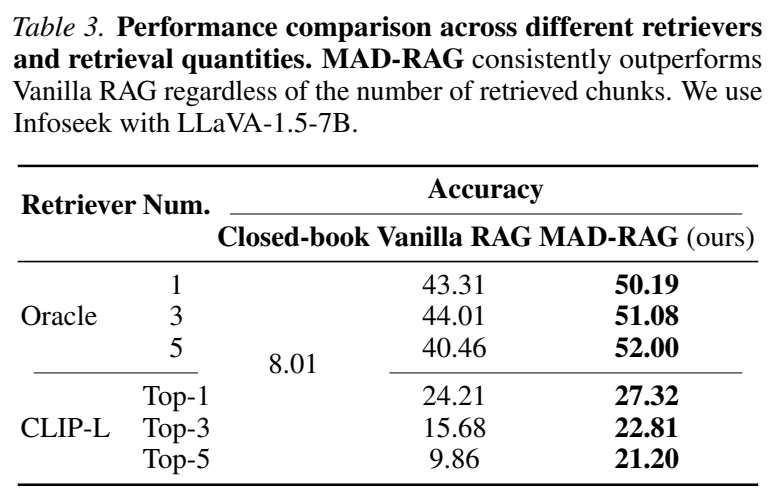
Таблица 3 использует CLIP-L на InfoSeek с LLaVA-1.5-7B. Обычный RAG→MAD-RAG даёт 24.21→27.32 для top-1, 15.68→22.81 для top-3 и 9.86→21.20 для top-5. Метод улучшает каждое сравнение, но большее число фрагментов всё равно снижает его оценку относительно top-1. Проблема качества поиска не исчезает. Значение 50.19 в таблице 1 и 51.08 для трёх oracle-фрагментов в таблице 3 приводятся раздельно, без искусственного согласования.
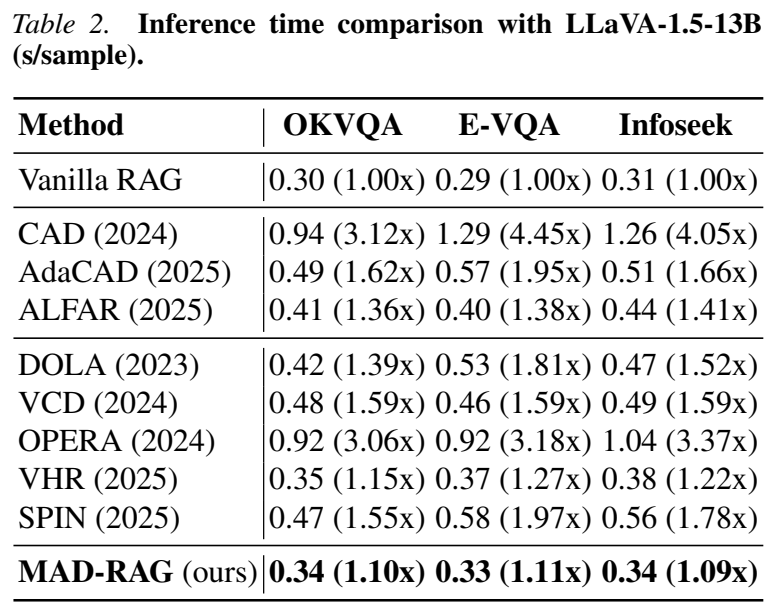
В таблице 2 для LLaVA-1.5-13B указаны 0.34, 0.33 и 0.34 секунды на пример и коэффициенты 1.10×, 1.11× и 1.09×. Дополнительные затраты составляют около 9–11%, а не ноль. Округлённые времена не обязательно точно воспроизводят коэффициенты; они также не определяют задержку других систем.
Границы применимости
Полный метод требует доступа к внутренним вычислениям внимания. Повторение вопроса через закрытый коммерческий API не реализует такое вмешательство. Если исходная визуальная опора ошибочна, её смешивание может распространить ошибку, что отражено в разборе неудачных случаев.
Работа не подтверждает результат для любых корейских материалов, длинных документов, медицинских задач или действующих приложений. Адаптивный выбор α и более глубокое теоретическое объяснение остаются направлениями исследования. При внедрении следует раздельно оценивать поиск, визуальную опору и внесённые вмешательством ошибки.
Взгляд патентного специалиста
Проблема может заключаться не в отсутствии документов, а в ослаблении уже имеющегося визуального основания при слиянии информации. Порядок входов и конкретное сочетание промежуточных представлений — технические решения, отличающиеся от настройки выходных логитов или улучшения поиска.
При описании разработки полезно указать тип отказа, затронутый поток данных, место вмешательства и измеряемый эффект с условиями. Экспериментальный выигрыш сам по себе не устанавливает новизну, патентоспособность или патентную чистоту. Необходим отдельный анализ прежних публикаций и формулы прав.
Как читать вклад работы
MAD-RAG показывает, что сохранение визуальных оснований может быть столь же важным, как добавление текста. Одинаковый вопрос до и после контекста и смешивание внутренних выходов дают конкретный способ исследовать их взаимодействие.
Следует различать oracle и реальный поиск, общие оценки и выбранные группы ошибок, исправленные и вновь неверные ответы. Указание этих условий позволяет точнее объяснить результат и пределы метода.
Иллюстрации и таблицы приведены как фрагменты с сохранением исходного содержания; пояснения и подписи подготовлены для статьи. Права принадлежат авторам работы; источник указан по CC BY 4.0. Zhao et al., ICML 2026 / PMLR 306:161272–161290 · CC BY 4.0