
論文と分析の対象
Test-Time Training Done RightはLarge Chunk Test-Time Training(LaCT)を提案します。著者はTianyuan Zhang、Sai Bi、Yicong Hong、Kai Zhang、Fujun Luan、Songlin Yang、Kalyan Sunkavalli、William T. Freeman、Hao Tanで、所属はMITとAdobe Researchです。2025年5月29日公開のarXiv:2505.23884、DOIは10.48550/arXiv.2505.23884です。ICLR 2026への掲載は別途確認しましたが、本稿の構造・数値・図は32ページのarXiv v1に統一しています。原図はZhangらによるもので、CC BY 4.0に基づき掲載します。
高速重みは現在の入力を覚える状態
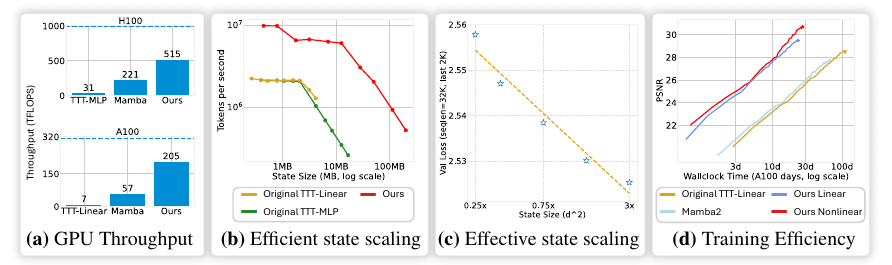
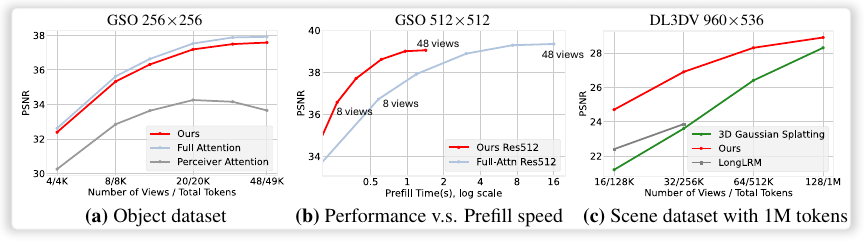
通常のアテンションはクエリから保存済みのキーと値を参照します。TTTでは小さなネットワークの重みWにキーと値の関係を記憶し、クエリを与えて読み出します。この高速重みは現在の入力に応じて変化しますが、基盤モデルの低速重みは推論中に固定されます。モデル全体を新しい正解で再学習する意味ではありません。1トークンや16~64トークンごとの更新は、重みのメモリー転送を繰り返しGPU演算器を十分に使えない場合があります。LaCTはタスクに応じて2Kから約1Mトークンをまとめて更新します。図1の処理量、状態サイズ、損失、視点合成の時間は別々の指標です。
局所アテンションと非線形記憶の分担
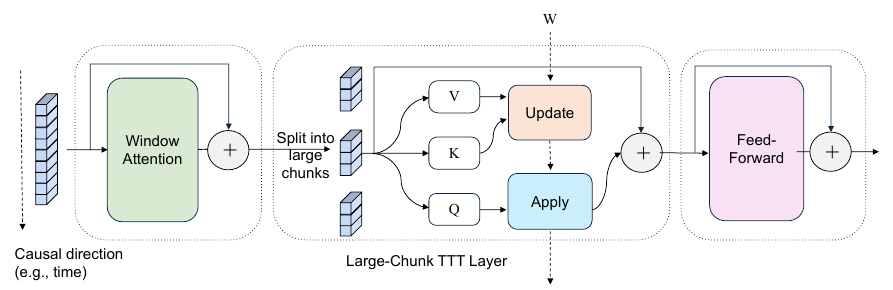
ウィンドウアテンションは近傍の順序や空間関係を捉えます。大きなチャンクの更新はトークンを集合として扱うため、局所構造を補う仕組みが必要です。標準の記憶は三つの行列を持つSwiGLU MLPで、キーに対する出力と値の負の内積を損失とし、トークン別学習率を反映して勾配を集約します。クエリは高速重みから情報を読み出します。固定サイズでも容量は有限です。勾配降下法、モメンタム、Muonが比較され、MuonではNewton–Schulz反復で行列勾配を変換し、更新後にL2正規化を施します。更新回数の削減が大きな非線形状態と高度な更新則を使いやすくします。
未来情報を混ぜない処理順序
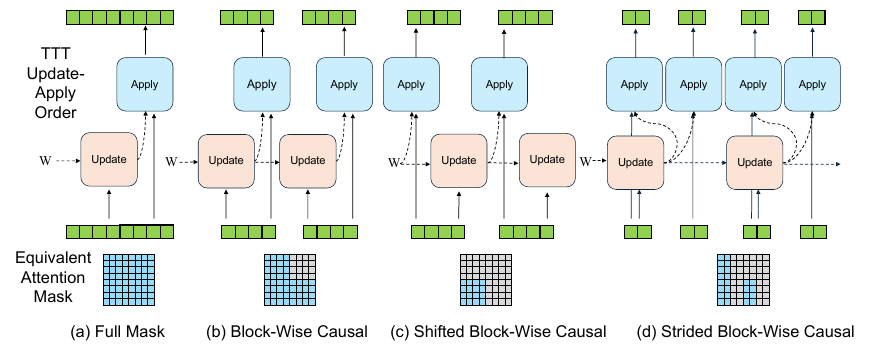
入力からQ・K・Vと学習率を作り、局所アテンションと記憶の出力を組み合わせ、フィードフォワード層へ渡します。言語・動画ではQ・K・Vを共有し出力を加算する構成も使います。言語モデルでは過去のチャンクまでを反映した記憶を現在のチャンクに適用してから、現在の情報で次のチャンク用に更新します。内部の因果関係は因果的スライディングウィンドウが担当します。既知のカメラ姿勢を持つ画像集合では入力を先に記憶してから新視点を読み出せます。動画はクリーンなフレームでのみ記憶を更新し、ノイズ付きチャンクは過去の記憶を参照します。
視点合成の速度は条件付きの結果
物体はObjaverseで学習しGoogle Scanned Objectsで評価、シーンはDL3DVを使用します。PSNRは再構成画質の指標で、ここでは高い方が良好です。表2はA100、512×512画像48枚、入力約196K・デコード4Kトークンの条件です。全アテンションは入力16.1秒・描画2.3 FPS、Perceiverは16.8秒・34.4 FPS、LaCTは1.4秒・38.7 FPSで、モデル規模は284M・287M・312Mです。入力時間の約11.5倍の差はこの設定の比較であり、LLM応答速度一般の主張ではありません。画質は全アテンションに近いものの全点で上回りません。最大シーン設定は960×536画像128枚、約100万視覚トークンで、同長の言語文書を評価した結果ではありません。
言語モデルの品質と処理量
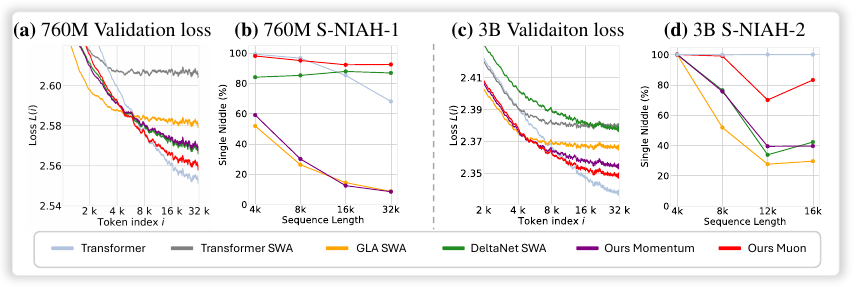
学習長は32,768トークンです。760Mモデルは40B学習トークンと2,048の窓、3Bは60Bと4,096の窓を使用し、GLAとDeltaNetにも同じスライディングウィンドウを付けています。位置別損失とS-NIAH検索精度ではMuon構成がこれらの反復状態モデルより良好ですが、全アテンションが優れる点もあります。表3のA100-40GB、3B、32K学習処理量は、Transformer 4.1K tokens/s、窓のみ6.4K、GLA 5.0K、DeltaNet 5.1K、LaCT勾配降下法5.0K、モメンタム4.9K、Muon 4.3Kです。Muonの品質改善には更新コストがあり、最速構成ではありません。
チャンクを大きくするだけでは足りない
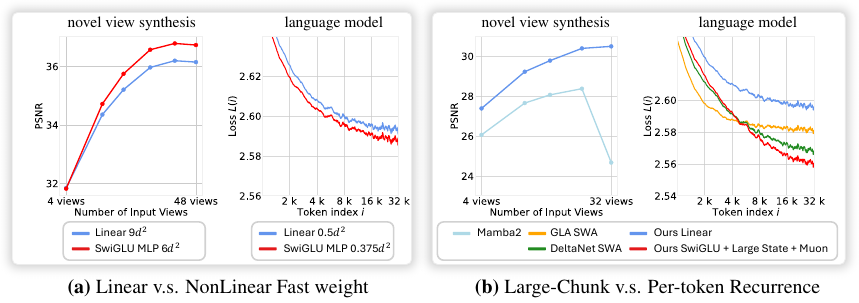
図8は記憶関数と更新単位を分けて比較しています。小さい非線形SwiGLU状態が大きい線形状態を上回る例があり、同一状態サイズの線形チャンク更新はGLAを上回りません。大きな非線形状態とMuonの組合せが改善に寄与しています。最大設定で高速重みがモデルの約40%を占めるという値も全構成の定数ではありません。容量とメモリー消費、更新負荷を併せて評価する必要があります。
動画実験と分散計算
事前学習済みWan 2.1を1.3B・14Bの自己回帰動画拡散モデルへ適応しています。14B設定の8.8秒動画は56,160視覚トークンで、学習中のクリーン・ノイズ付きチャンクを交互に並べた約107Kとは異なります。5,000回の学習後、2,000動画と五つのノイズ時点で除去損失を評価しました。人の好みや長時間動画の品質を直接示す指標ではなく、非公開学習データも再現性の制約です。チャンクを複数装置に分割して勾配を合算する文脈並列化が可能ですが、1~3%のオーバーヘッドは特定の視点合成学習条件に限られます。
残された検証課題
SwiGLUと線形高速重みには一部のアテンションが持つQ・Kの一様回転に対する不変性がなく、その影響は十分に調べられていません。視点合成は既知のカメラ姿勢を前提とし、姿勢不明の再構成、複雑な言語推論、大規模化は未検証です。固定状態に情報を圧縮するため、細部の保持、同時リクエスト、生成時の遅延やメモリー使用量は用途別に測る必要があります。これは導入に向けた本稿の検討事項で、追加実験の報告ではありません。
特許実務の観点から見た技術的構成
課題は、頻繁な更新とメモリー転送がGPU並列性の活用を妨げる点です。解決構成は大きなチャンクの勾配計算、非線形高速重み、正規化を伴う更新、局所アテンションを結び、タスクに応じて更新・読出し順序と文脈並列化を選びます。アテンションと反復状態の併用自体には先行研究があるため、大きな並列計算単位が状態容量と更新則の選択をどう広げるかが技術説明の中心です。効果は視点合成や760M・3B言語モデルという条件と、品質・速度の交換関係を明記して評価すべきです。論文の構成分析と、特許要件を満たすかという判断は別問題です。