
Публикация и версия для анализа
Работа Test-Time Training Done Right предлагает Large Chunk Test-Time Training, или LaCT. Авторы — Tianyuan Zhang, Sai Bi, Yicong Hong, Kai Zhang, Fujun Luan, Songlin Yang, Kalyan Sunkavalli, William T. Freeman и Hao Tan; указаны MIT и Adobe Research. Первая публикация датирована 29 мая 2025 года: arXiv:2505.23884, DOI 10.48550/arXiv.2505.23884. Публикация в ICLR 2026 подтверждена отдельно, однако механизмы, числа и рисунки здесь последовательно рассматриваются по 32-страничной версии arXiv v1. Иллюстрации Zhang и соавторов используются по CC BY 4.0.
Быстрые веса как память текущего контекста
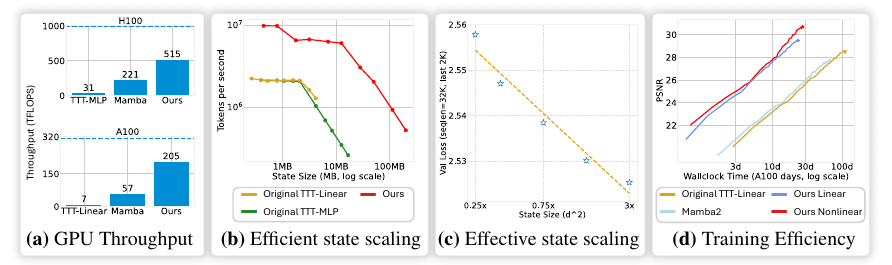
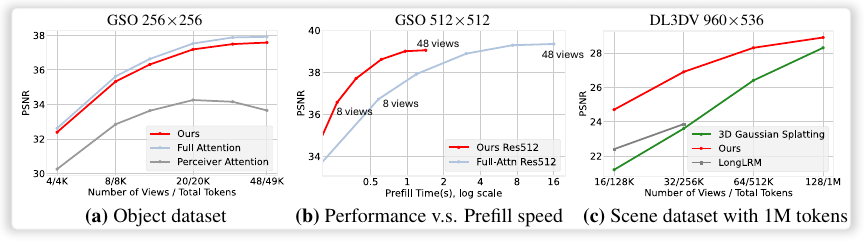
Обычное внимание обращается к сохраненным ключам и значениям. TTT записывает их связь в изменяемые веса W небольшой сети, а запрос читает эту память. Быстрые веса меняются для текущей последовательности, тогда как медленные веса базовой модели при инференсе фиксированы. Это не переобучение всей модели по новым человеческим ответам. Обновления после каждого токена или каждых 16–64 токенов требуют частого переноса весов и могут недостаточно загружать вычислительные блоки GPU. LaCT использует блоки от 2K до примерно 1M токенов в зависимости от задачи. Рисунок 1 показывает разные показатели производительности, размера состояния, потерь и синтеза ракурсов, а не единый коэффициент ускорения сервиса.
Нелинейная память дополняет локальное внимание
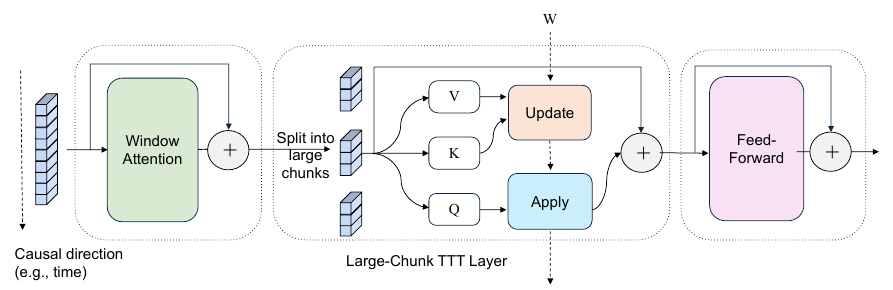
Оконное внимание обрабатывает локальный порядок и пространственные отношения. Крупноблочное обновление рассматривает токены как множество, поэтому локальная структура требует отдельного механизма. Базовая память — SwiGLU MLP с тремя матрицами. Отрицательное скалярное произведение связывает выход для ключа со значением; градиенты блока суммируются с учетом скорости обучения каждого токена. Запросы читают быстрые веса. Фиксированный размер не означает бесконечной емкости. Сравниваются градиентный спуск, импульс и Muon: последний преобразует матричные градиенты итерациями Ньютона–Шульца, а после обновления выполняется L2-нормализация. Более редкие крупные обновления позволяют использовать емкие состояния и сложные правила.
Порядок операций исключает утечку будущего
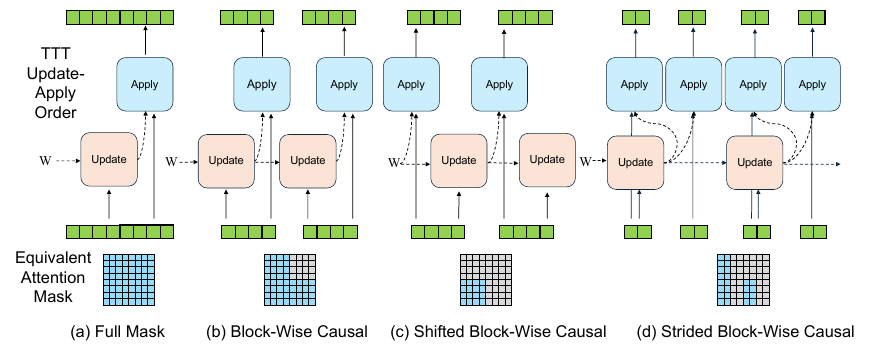
Из входа получают Q, K, V и скорости обучения, объединяют результаты внимания и памяти и передают их полносвязному блоку. В языковых и видеоконфигурациях Q, K и V могут быть общими, а выходы складываются. Для языка текущий блок сначала читает память прошлых блоков и лишь затем обновляет ее для следующего. Причинное скользящее внимание обеспечивает связи внутри блока. Иначе предсказание могло бы видеть будущие токены. Набор изображений с известными позами камер можно сначала записать, а затем запросить новый ракурс. В видео память обновляется только чистыми блоками кадров; зашумленные блоки читают ранее накопленное состояние.
Синтез ракурсов и условия измерения
Объектные модели обучают на Objaverse и оценивают на Google Scanned Objects, сцены — на DL3DV. PSNR характеризует качество восстановления; здесь большее значение лучше. Таблица 2 использует A100, 48 изображений 512×512, около 196K входных и 4K декодируемых токенов. Полное внимание: обработка входа 16,1 с и рендеринг 2,3 FPS; Perceiver: 16,8 с и 34,4 FPS; LaCT: 1,4 с и 38,7 FPS. Размеры моделей — 284M, 287M и 312M. Разница входной задержки примерно в 11,5 раза относится к этому опыту, не к скорости ответа любого LLM. Качество близко к полному вниманию, но не превосходит его во всех точках. Максимальная сцена использует 128 изображений 960×536 и около миллиона визуальных токенов, а не языковой документ такой длины.
Языковые модели: качество и пропускная способность
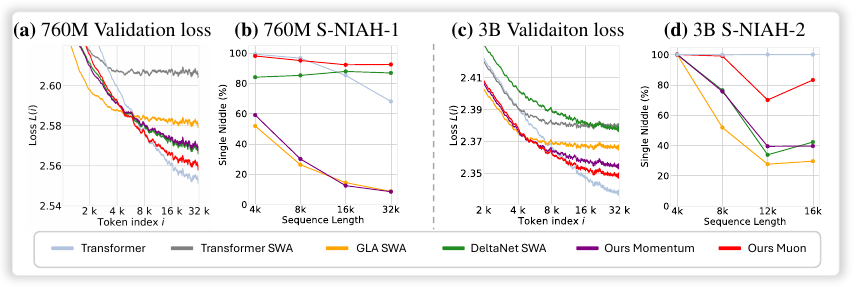
Длина обучения составляет 32 768 токенов. Модель 760M использует 40B обучающих токенов и окно 2 048, модель 3B — 60B и окно 4 096. GLA и DeltaNet дополнены тем же скользящим вниманием. Позиционные потери и поиск S-NIAH лучше у LaCT с Muon, чем у этих рекуррентных базовых моделей, но полное внимание сохраняет преимущество в ряде точек. Таблица 3 для обучения 3B при 32K на A100-40GB дает: Transformer 4,1K токенов/с, только окно 6,4K, GLA 5,0K, DeltaNet 5,1K, LaCT с градиентным спуском 5,0K, импульсом 4,9K и Muon 4,3K. Улучшение качества Muon сопровождается затратами на обновление, а не максимальной скоростью.
Увеличения блока самого по себе недостаточно
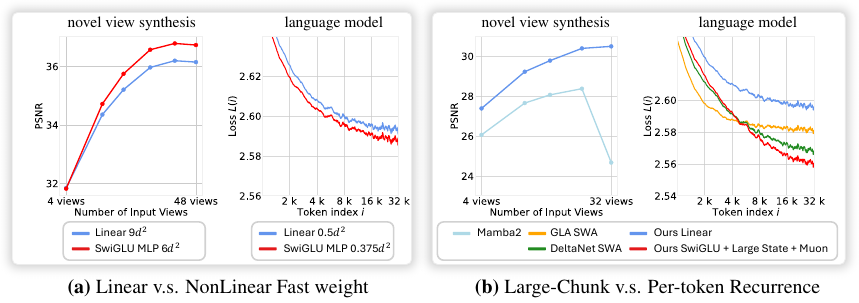
Рисунок 8 разделяет представление памяти и шаг обновления. Меньшее нелинейное состояние SwiGLU может превосходить большее линейное. Линейное блочное обновление при равном размере состояния не обходит GLA; улучшение дает сочетание большого нелинейного состояния с Muon. В максимальной конфигурации быстрые веса составляют около 40% параметров, но это не постоянная доля для всех моделей LaCT. Емкость необходимо оценивать вместе с памятью и стоимостью обновления.
Видео и распределенные вычисления
Предобученный Wan 2.1 преобразуется в авторегрессионные диффузионные видеомодели 1,3B и 14B. Клип 8,8 с в варианте 14B содержит 56 160 визуальных токенов. Около 107K токенов при обучении включают чередующиеся чистые и зашумленные блоки и обозначают другую величину. После 5 000 итераций оценивают потери удаления шума на 2 000 видео в пяти шумовых временных точках. Это не непосредственная оценка человеческих предпочтений или качества длинного видео; закрытые обучающие данные ограничивают воспроизводимость. Контекстный параллелизм делит блок между устройствами и суммирует градиенты. Указанные накладные расходы 1–3% относятся к конкретному обучению синтезу ракурсов, а не любой сети и числу устройств.
Ограничения и вопросы внедрения
SwiGLU и линейные быстрые веса не обладают инвариантностью к одинаковому вращению запросов и ключей, свойственной некоторым механизмам внимания; практические последствия исследованы недостаточно. Синтез предполагает известные позы камер. Восстановление без них, сложное языковое рассуждение и существенно большие языковые модели не подтверждены экспериментами. Сжатие контекста в фиксированное состояние требует отдельно измерять сохранение деталей, параллельные запросы, задержку генерации и расход памяти. Это наши вопросы прикладной проверки, а не дополнительные результаты авторов.
Технический вклад с позиции патентного анализа
Проблема возникает на пересечении переноса данных, частых обновлений и неполного использования параллелизма GPU. Решение объединяет градиенты крупных блоков, нелинейные быстрые веса, нормализованные обновления и оконное внимание, выбирая порядок чтения и записи по задаче и при необходимости распределяя контекст. Внимание вместе с рекуррентным состоянием применялось ранее; существенна связь крупной параллельной операции с емкостью памяти и выбором оптимизатора. Эффекты следует описывать в условиях синтеза ракурсов либо языковых моделей 760M/3B и учитывать обмен между качеством и скоростью. Такой разбор механизма не означает заключения о его патентоспособности.
Статья LaCT и исходные рисунки
Лицензия на рисунки: CC BY 4.0
Патенты в области ИИ и технический анализ