
La publicación y la versión examinada
Test-Time Training Done Right presenta Large Chunk Test-Time Training, o LaCT. Sus autores son Tianyuan Zhang, Sai Bi, Yicong Hong, Kai Zhang, Fujun Luan, Songlin Yang, Kalyan Sunkavalli, William T. Freeman y Hao Tan, de MIT y Adobe Research. Apareció el 29 de mayo de 2025 como arXiv:2505.23884, DOI 10.48550/arXiv.2505.23884. Se ha comprobado su publicación en ICLR 2026, pero mecanismos, cifras y figuras de este análisis proceden coherentemente de las 32 páginas de arXiv v1. Las figuras se atribuyen a Zhang y colaboradores y se utilizan bajo CC BY 4.0.
Pesos rápidos para recordar el contexto
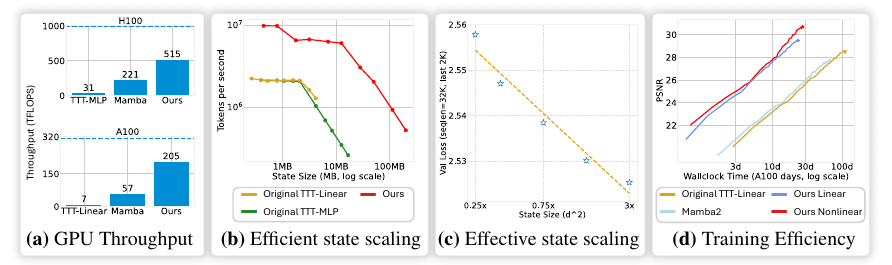
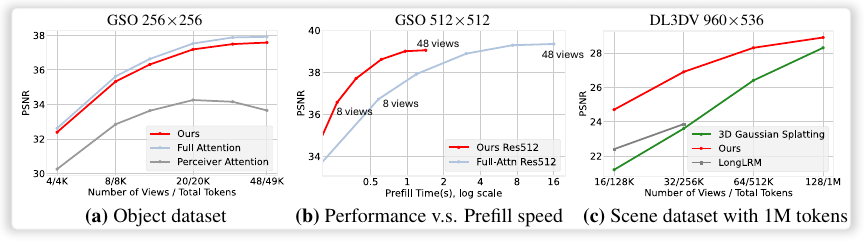
La atención ordinaria consulta claves y valores almacenados. TTT guarda esa relación en pesos adaptables W de una pequeña red y la lee mediante consultas. Los pesos rápidos cambian con la entrada actual, mientras los pesos lentos del modelo base permanecen fijos durante la inferencia; no se reentrena todo el modelo con nuevas respuestas humanas. Actualizar cada token o cada 16–64 tokens obliga a mover pesos repetidamente y puede desaprovechar las unidades de cálculo de la GPU. LaCT agrupa entre 2K y aproximadamente 1M de tokens según la tarea. La figura 1 reúne métricas distintas de rendimiento, tamaño del estado, pérdida y síntesis de vistas; no expresa un multiplicador universal de velocidad del servicio.
Memoria no lineal y atención local
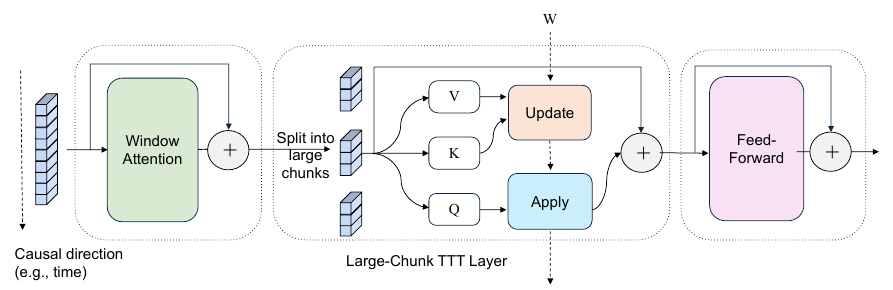
La atención por ventanas recoge orden y relaciones espaciales locales; la actualización por bloques trata los tokens como un conjunto y necesita ese complemento. La memoria habitual es una MLP SwiGLU con tres matrices. Una pérdida de producto interno negativo relaciona las salidas para las claves con los valores; se suman gradientes del bloque con tasas de aprendizaje por token. Las consultas leen después los pesos rápidos. Un estado fijo no tiene capacidad infinita. Se comparan descenso de gradiente, momento y Muon; este transforma gradientes matriciales mediante iteraciones Newton–Schulz y se aplica normalización L2 tras actualizar los pesos. Reducir la frecuencia de actualización facilita estados y reglas más complejos.
El orden de lectura evita información futura
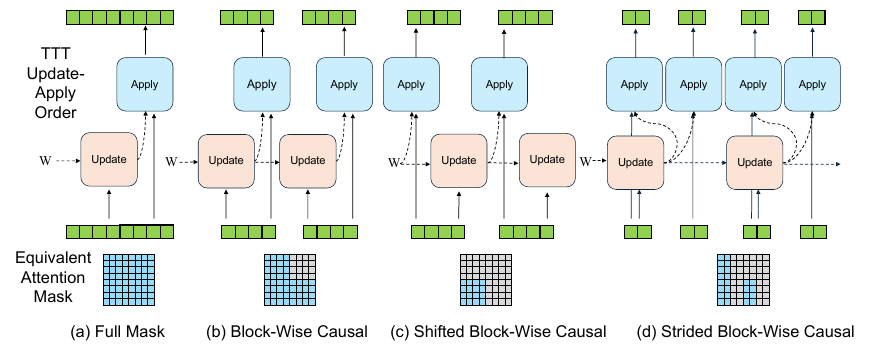
La entrada genera Q, K, V y tasas de aprendizaje. Se combinan atención local y memoria antes de las capas de avance; las variantes de lenguaje y vídeo pueden compartir Q, K y V y sumar sus salidas. En lenguaje, el bloque actual lee la memoria de los bloques anteriores y solo después la actualiza para el siguiente. La ventana deslizante causal resuelve dependencias internas, evitando filtrar tokens futuros. Para imágenes con poses de cámara conocidas, primero puede incorporarse el conjunto y después consultarse la vista objetivo. En vídeo solo actualizan la memoria los bloques limpios; los ruidosos leen información previa.
Síntesis de vistas bajo condiciones concretas
Los objetos se entrenan con Objaverse y se evalúan en Google Scanned Objects; las escenas utilizan DL3DV. PSNR mide la calidad de reconstrucción, mejor cuanto mayor en esta comparación. La tabla 2 usa A100, 48 imágenes de 512×512, unos 196K tokens de entrada y 4K de decodificación. Atención completa: 16,1 segundos de entrada y 2,3 FPS de renderizado; Perceiver: 16,8 segundos y 34,4 FPS; LaCT: 1,4 segundos y 38,7 FPS. Los tamaños son 284M, 287M y 312M parámetros. La razón aproximada de 11,5 en latencia corresponde a ese ensayo, no a la respuesta de cualquier LLM. La calidad se aproxima a la atención completa sin superarla en todos los puntos. El máximo de escenas emplea 128 imágenes de 960×536, cerca de un millón de tokens visuales, no una prueba lingüística de esa longitud.
Lenguaje: calidad y velocidad no son equivalentes
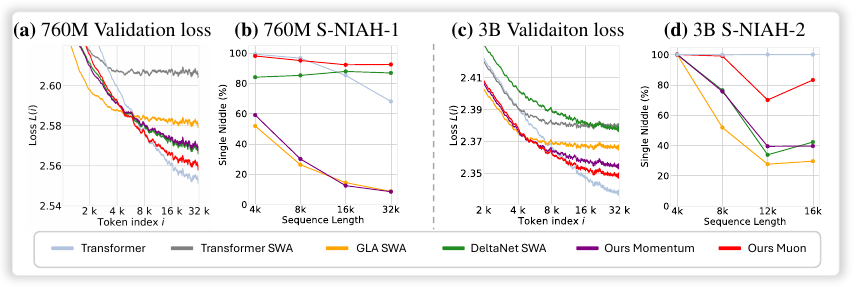
Las secuencias de entrenamiento tienen 32.768 tokens. El modelo 760M usa 40B tokens y ventana de 2.048; el 3B, 60B y ventana de 4.096. GLA y DeltaNet reciben la misma atención deslizante. La pérdida por posición y la recuperación S-NIAH favorecen a LaCT con Muon frente a esas referencias recurrentes, aunque la atención completa sigue siendo mejor en algunos puntos. La tabla 3 mide entrenamiento 3B a 32K en A100-40GB: Transformer 4,1K tokens/s, solo ventana 6,4K, GLA 5,0K, DeltaNet 5,1K, LaCT con gradiente 5,0K, momento 4,9K y Muon 4,3K. La mejora de Muon tiene un coste de actualización y no ofrece el máximo rendimiento de procesamiento.
El tamaño del bloque no explica todo
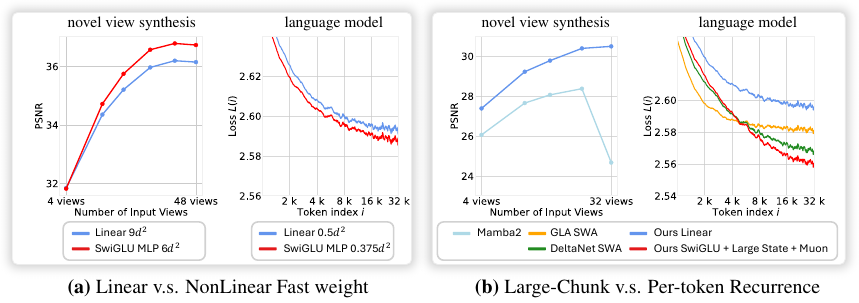
La figura 8 separa representación y granularidad. Una memoria SwiGLU no lineal menor puede superar a una lineal mayor. Una actualización lineal por bloques, con igual tamaño de estado, no supera GLA; sí lo hace la combinación de estado no lineal grande y Muon. En la configuración máxima, los pesos rápidos representan alrededor del 40% de los parámetros, no una proporción constante de LaCT. Capacidad, memoria y coste de actualización deben valorarse conjuntamente.
Vídeo y cálculo distribuido
Se adapta Wan 2.1 preentrenado a modelos de difusión de vídeo autorregresivos de 1,3B y 14B. Un clip de 8,8 segundos en la configuración 14B contiene 56.160 tokens visuales. Los aproximadamente 107K tokens del entrenamiento incluyen bloques limpios y ruidosos alternados y son otra magnitud. Tras 5.000 iteraciones se evalúa la pérdida de eliminación de ruido en 2.000 vídeos y cinco instantes de ruido. No mide directamente preferencia humana ni calidad de vídeos largos; los datos privados también limitan la reproducción. El paralelismo de contexto reparte un bloque y suma sus gradientes. La sobrecarga comunicada del 1–3% corresponde a un entrenamiento concreto de síntesis de vistas, no a toda red o número de dispositivos.
Límites y comprobaciones para una aplicación
SwiGLU y los pesos rápidos lineales carecen de la invariancia ante rotaciones uniformes de consultas y claves presente en ciertas formas de atención; sus consecuencias prácticas siguen poco estudiadas. La síntesis supone poses conocidas. No se demuestra reconstrucción sin poses, razonamiento lingüístico complejo ni escalado a modelos lingüísticos mucho mayores. Comprimir en un estado fijo exige comprobar retención de detalles, concurrencia, latencia de generación y memoria en cada uso. Estas son consideraciones de implementación del análisis, no resultados adicionales del artículo.
Lectura técnica desde la práctica de patentes
El problema combina tráfico de memoria, actualizaciones frecuentes y escaso aprovechamiento paralelo de GPU. La solución reúne gradientes por bloques grandes, pesos rápidos no lineales, actualizaciones normalizadas y atención local, con orden de lectura adecuado y paralelismo opcional. Combinar atención y recurrencia ya tenía antecedentes; interesa cómo el bloque grande permite ampliar el estado y elegir optimizadores. Los efectos deben describirse con sus condiciones de síntesis de vistas o modelos 760M/3B, además del compromiso entre calidad y velocidad. Analizar esa arquitectura no equivale a afirmar que satisface los requisitos de patentabilidad.
Artículo de LaCT y figuras originales
Licencia de las figuras: CC BY 4.0
Consultar patentes de IA y análisis técnicos