작성자: 김용덕 변리사
안녕하세요. 아이피렉스 특허법률사무소, 김용덕 변리사입니다.
인공지능이 긴 문서나 여러 장의 이미지를 처리하려면 앞에서 읽은 정보를 어떻게든 기억해야 합니다. 모든 정보를 펼쳐 놓고 다시 읽으면 비용이 커지고, 작은 메모에 압축하면 중요한 내용을 놓칠 수 있습니다. 오늘 살펴볼 「Test-Time Training Done Right」는 이 기억을 갱신하는 단위를 크게 바꾸는 연구입니다.
LaCT의 핵심은 큰 묶음으로 임시 기억을 갱신하고, 가까운 정보의 관계는 윈도 어텐션으로 처리하는 데 있습니다.
이 글에서는 연구진이 제시한 구조와 실험 결과를 분석합니다. 먼저 기술적 배경을 설명하고, 실제 처리 순서와 수치를 살펴본 뒤 기술적 과제·해결수단·차별적 구성·기술적 효과를 변리사 관점에서 정리하겠습니다.
1. 논문 기본 정보와 분석 범위
논문명은 Test-Time Training Done Right이며, 방법 이름 LaCT는 Large Chunk Test-Time Training의 약칭입니다. 저자는 Tianyuan Zhang, Sai Bi, Yicong Hong, Kai Zhang, Fujun Luan, Songlin Yang, Kalyan Sunkavalli, William T. Freeman, Hao Tan입니다. 원문에 기재된 소속은 Massachusetts Institute of Technology와 Adobe Research입니다.
최초 공개일은 2025년 5월 29일이며, 식별자는 arXiv:2505.23884, DOI는 10.48550/arXiv.2505.23884입니다. ICLR 2026 공식 논문집에서 학회 게재 사실을 확인했습니다. 다만 아래 설명과 그림·수치는 재사용 조건이 확인되는 32쪽짜리 arXiv v1을 기준으로 통일했습니다. 학회 게재본과 초기 공개본의 버전을 혼합하지 않습니다.
2. 왜 자주 기억을 갱신하면 느려질까요
2.1 임시 기억으로 쓰는 빠른 가중치
일반적인 어텐션은 질의 Q와 저장된 키 K·값 V의 관계를 계산해 필요한 정보를 읽습니다. TTT는 키와 값의 관계를 작은 신경망의 가중치 W에 담고, 질의를 그 신경망에 넣어 정보를 읽는 방식입니다. 입력을 처리하는 동안 바뀌는 W를 빠른 가중치, 즉 fast weights라고 부릅니다.
여기서 테스트 시점 학습은 새로운 정답을 사람이 제공해 모델 전체를 다시 학습시키는 의미가 아닙니다. 현재 입력에서 얻은 키·값 관계를 이용해 임시 상태를 갱신합니다. 추론 중 고정되는 기본 모델의 느린 가중치와, 현재 문맥을 기억하는 빠른 가중치를 구별해야 합니다.
2.2 계산량과 실제 GPU 효율은 다릅니다
기억을 토큰 하나마다, 또는 16~64개 정도의 작은 묶음마다 갱신하면 세밀하게 반응할 수 있습니다. 그러나 매번 가중치를 메모리에서 읽고 계산하고 다시 기록해야 합니다. 한 번에 수행하는 계산이 적으면 GPU의 연산 장치를 충분히 사용하기 어렵습니다.
비유하면 물건 한 개를 옮길 때마다 큰 트럭을 출발시키는 상황에 가깝습니다. LaCT는 여러 물건을 모아 운송하듯, 한 번의 가중치 갱신에 많은 토큰을 함께 처리합니다. 논문은 작업에 따라 2K부터 약 1M 토큰까지 서로 다른 청크 크기를 사용합니다.
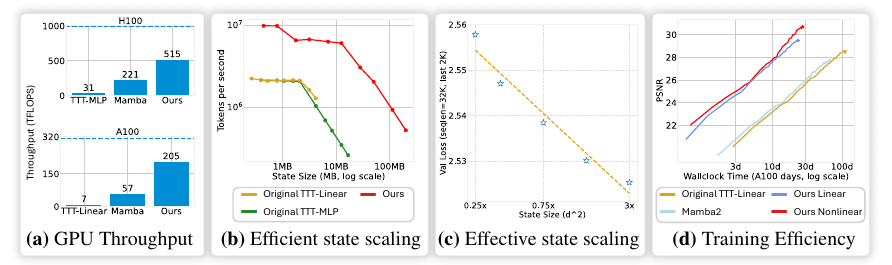
그림 1. GPU 처리량, 상태 크기, 손실과 학습 시간을 서로 다른 실험으로 비교한 결과 (Zhang 외, arXiv v1, Figure 1)
그림 1의 세로축은 모두 같은 지표가 아닙니다. (a)는 GPU 연산 처리량, (b)는 상태 크기에 따른 초당 처리 토큰, (c)는 언어모델의 검증 손실, (d)는 시점 합성의 학습 시간 대비 PSNR입니다. 이 그림을 하나의 “전체 서비스 속도 몇 배”라는 수치로 읽어서는 안 됩니다. 상태를 키울 수 있는 실행 효율과 그 상태가 만드는 성능 차이를 나눠 보여 주는 자료입니다.
3. LaCT의 구조는 세 부분으로 나뉩니다
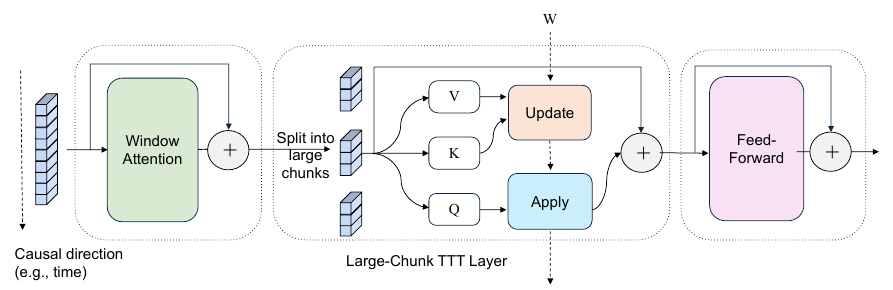
그림 2. 윈도 어텐션, 큰 청크 TTT, 피드포워드 층의 결합 구조 (Zhang 외, arXiv v1, Figure 2)
3.1 가까운 관계는 윈도 어텐션이 읽습니다
윈도 어텐션은 일정 범위 안의 토큰 관계를 직접 계산합니다. 문장에서는 가까운 단어 사이의 순서와 관계, 이미지에서는 같은 이미지 안의 공간적 관계를 처리합니다. 큰 청크 TTT의 갱신은 청크를 토큰의 집합으로 다루므로, 이처럼 내부 구조를 읽어 주는 장치가 함께 필요합니다.
3.2 먼 문맥은 비선형 빠른 가중치에 담습니다
LaCT의 기본 빠른 가중치 신경망은 세 개의 행렬을 사용하는 SwiGLU MLP입니다. 키를 이 신경망에 넣은 출력이 값과 잘 대응하도록 갱신 방향을 구합니다. 논문에서 사용하는 목적은 두 벡터의 내적에 음수를 붙인 손실이며, 각 토큰의 학습률을 반영한 청크 전체 손실의 기울기를 합칩니다.
그다음 질의 Q에 현재 빠른 가중치를 적용해 과거 문맥의 정보를 읽습니다. 고정 크기의 기억이므로 입력 길이가 늘어날 때 모든 과거 토큰을 그대로 저장하는 구조와 다릅니다. 다만 “크기가 고정된다”는 말은 기억 용량이 무한하다는 뜻이 아닙니다. 얼마나 큰 상태를 쓰고 어떤 정보가 보존되는지가 여전히 중요합니다.
3.3 갱신 규칙과 정규화가 기억의 안정성을 보완합니다
연구진은 기본 경사하강법, 모멘텀, Muon 갱신을 비교했습니다. Muon은 행렬 형태의 기울기를 Newton–Schulz 반복으로 변환하는 방식이며, LaCT에서는 갱신 후 빠른 가중치에 L2 정규화도 적용합니다. 청크가 커서 갱신 횟수가 줄어들면, 한 번의 갱신에 이런 처리를 더하더라도 비용을 나눠 부담할 여지가 생깁니다.
4. 실제 처리 순서와 미래 정보 차단
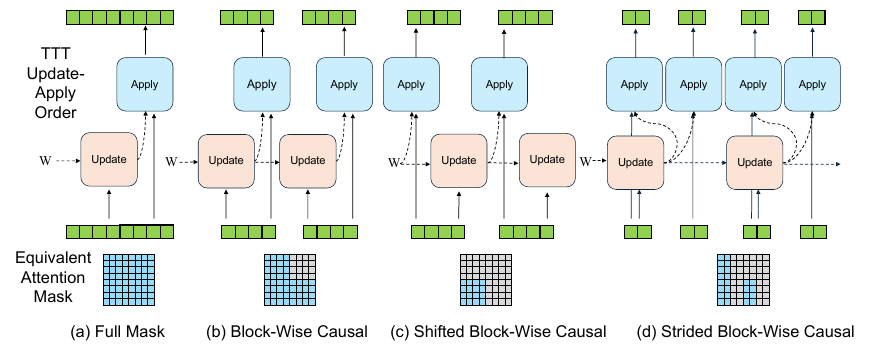
그림 3. Update와 Apply의 순서에 따라 달라지는 정보 접근 범위 (Zhang 외, arXiv v1, Figure 3)
첫째, 입력을 토큰으로 바꾸고 Q·K·V 및 토큰별 학습률을 만듭니다. 둘째, 윈도 어텐션으로 가까운 토큰의 관계를 계산합니다. 셋째, 작업에 맞는 순서로 빠른 가중치를 읽고 갱신합니다. 넷째, 읽어 낸 정보를 결합하고 피드포워드 층을 거쳐 다음 층으로 전달합니다. 언어모델과 영상 실험에서는 어텐션과 TTT가 같은 Q·K·V를 공유하고 출력을 합치는 구성도 사용합니다.
언어모델에서는 현재 청크의 정보를 기억에 먼저 모두 넣은 뒤 같은 청크를 예측하면 미래 토큰이 새어 들어갈 수 있습니다. 따라서 이전 청크까지 반영한 기억을 현재 청크에 먼저 적용하고, 현재 청크로 기억을 갱신해 다음 청크에 넘기는 순서를 사용합니다. 청크 안의 토큰별 인과관계는 인과적 슬라이딩 윈도 어텐션이 담당합니다.
카메라 위치를 알고 있는 여러 이미지로 새로운 시점을 만드는 작업은 다릅니다. 입력 이미지들의 정보를 먼저 기억에 반영하고 목표 시점의 질의에 적용할 수 있습니다. 영상 생성에서는 깨끗한 프레임 청크로만 기억을 갱신하고, 노이즈가 있는 청크를 처리할 때는 이전에 정리된 정보를 읽습니다. 같은 Update·Apply라는 연산도 데이터의 순서 조건에 따라 배치가 달라집니다.
5. 새로운 시점의 이미지를 만드는 실험
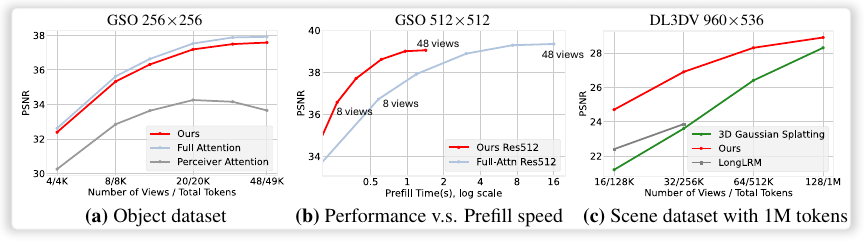
그림 4. 시점 합성의 화질, 입력 처리 지연, 입력 이미지 수에 따른 비교 (Zhang 외, arXiv v1, Figure 4)
시점 합성은 카메라 자세가 주어진 여러 이미지를 입력받아 보지 못한 위치의 이미지를 만드는 작업입니다. 객체 실험은 Objaverse로 학습하고 Google Scanned Objects에서 평가했으며, 장면 실험은 DL3DV를 사용했습니다. PSNR은 복원한 이미지와 정답 이미지의 차이를 평가하며, 여기서는 높을수록 좋습니다.
원문 Table 2의 속도 비교는 A100에서 512×512 이미지 48장, 입력 약 196K 토큰과 디코딩 4K 토큰이라는 조건입니다. 전체 어텐션 모델은 입력 처리 16.1초·렌더링 2.3 FPS, Perceiver 방식은 16.8초·34.4 FPS, LaCT는 1.4초·38.7 FPS를 보고했습니다. 모델 크기는 각각 284M, 287M, 312M으로 완전히 같지는 않습니다.
이 조건에서 입력 처리 시간 16.1초와 1.4초를 나누면 약 11.5배 차이입니다. 이는 해당 시점 합성 설정의 측정값을 비교한 계산이며, 언어모델의 응답 속도나 모든 GPU에서 같은 배율을 보장하는 결과는 아닙니다. 그림 4(a)에서는 LaCT가 전체 어텐션에 가까운 화질을 보이지만, 모든 점에서 이를 능가하는 것도 아닙니다.
장면 실험의 최대 설정은 960×536 이미지 128장으로 약 100만 토큰 규모입니다. 이때의 긴 문맥은 이미지 토큰의 집합입니다. 일반적인 언어모델이 100만 토큰의 문서를 같은 품질로 처리했다는 의미로 확대해서는 안 됩니다.
6. 언어모델에서는 무엇이 확인되었나요
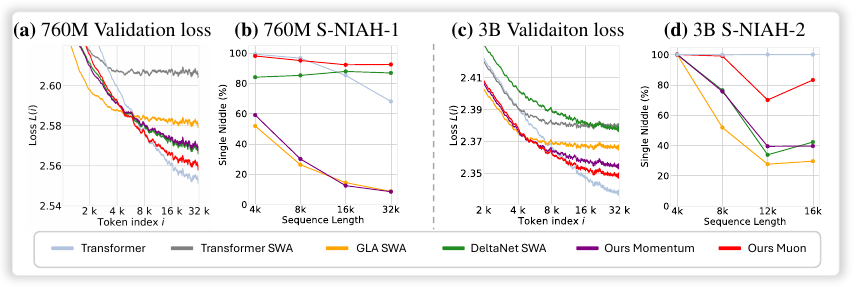
그림 5. 760M·3B 언어모델의 위치별 손실과 정보 검색 정확도 (Zhang 외, arXiv v1, Figure 5)
언어모델은 32,768 토큰 길이로 학습했습니다. 760M 모델은 40B 학습 토큰과 2,048 토큰 윈도를, 3B 모델은 60B 학습 토큰과 4,096 토큰 윈도를 사용했습니다. GLA와 DeltaNet에도 같은 슬라이딩 윈도 어텐션을 붙여 비교했습니다. 평가에는 문맥 내 위치별 검증 손실과 S-NIAH 검색 정확도가 사용됩니다.
그림 5에서 뒤쪽 토큰의 손실이 계속 낮아지는지 보면 앞 문맥을 얼마나 활용하는지 살필 수 있습니다. LaCT의 Muon 구성은 GLA·DeltaNet보다 낮은 손실과 높은 검색 정확도를 보였습니다. 그러나 전체 어텐션 Transformer가 더 좋은 지점을 포함하므로 “모든 비교 모델보다 우수하다”는 결론은 적절하지 않습니다.
속도도 별도로 봐야 합니다. 원문 Table 3은 A100-40GB, 3B 모델, 32K 길이의 학습 처리량을 제시합니다. Transformer는 4.1K tokens/s, 윈도 어텐션만 사용한 모델은 6.4K, GLA+윈도는 5.0K, DeltaNet+윈도는 5.1K였습니다. LaCT는 기본 경사하강법 5.0K, 모멘텀 4.9K, Muon 4.3K였습니다. Muon의 성능 이점에는 갱신 비용이 있으며, 가장 높은 처리량을 기록한 구성은 아닙니다.
7. 큰 청크 하나만으로 좋아지는 것은 아닙니다
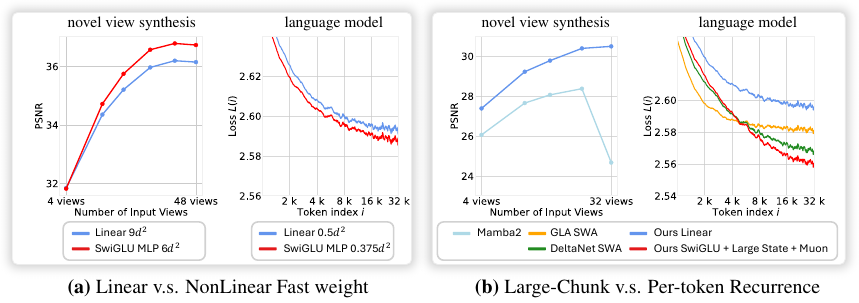
그림 8. 선형·비선형 기억과 토큰별·청크별 갱신을 나누어 비교한 실험 (Zhang 외, arXiv v1, Figure 8)
그림 8(a)에서는 더 작은 상태를 사용하는 비선형 SwiGLU 기억이 더 큰 선형 기억보다 좋은 결과를 보입니다. 이는 기억을 저장하는 파라미터 수만큼이나 기억을 표현하는 함수의 형태가 중요하다는 근거입니다.
그림 8(b)의 언어모델 비교는 특히 주의해서 읽어야 합니다. 같은 상태 크기의 선형 청크 갱신은 GLA 기준선보다 좋지 않았습니다. 큰 비선형 상태와 Muon을 함께 사용한 구성이 그 기준선을 넘어섰습니다. 따라서 최종 개선을 청크 크기라는 단일 원인에 전부 돌릴 수 없습니다.
연구진은 상태 크기를 늘리는 실험도 수행했습니다. 가장 큰 설정은 빠른 가중치가 전체 모델 가중치의 약 40%를 차지합니다. 이는 한 실험 설정의 비율이며 모든 LaCT 모델의 공통 상수는 아닙니다. 상태를 크게 만들면 정보를 담는 능력이 좋아질 수 있지만 메모리 부담과 갱신 비용도 함께 고려해야 합니다.
8. 영상 적용과 계산비용의 범위
영상에서는 사전학습된 Wan 2.1을 기반으로 1.3B 및 14B 규모의 자기회귀 영상 확산 모델을 구성했습니다. 14B의 8.8초 영상은 56,160개의 시각 토큰에 해당합니다. 학습 중 노이즈·깨끗한 청크를 교대로 배치했을 때의 약 107K 토큰은 별도의 수치이므로, 생성 영상의 토큰 수와 혼동하지 않아야 합니다.
평가는 5,000회 학습 반복 후 2,000개 영상에서 다섯 노이즈 시점의 잡음 제거 손실을 측정했습니다. 이 결과는 예측 손실에 관한 증거입니다. 사람의 시각적 선호나 장시간 생성의 품질을 직접 평가한 결과와 동일하지 않습니다. 학습 데이터에 비공개 영상 모음이 사용된 점도 재현 범위를 판단할 때 고려해야 합니다.
큰 청크의 토큰을 여러 장치로 나누고 각 장치가 구한 갱신 기울기를 합하는 문맥 병렬화도 가능합니다. 논문은 해당 시점 합성 학습 설정에서 처리량 오버헤드가 1~3%였다고 보고했습니다. 통신비용은 장치 수와 네트워크 등 조건에 좌우되므로, 모든 분산 환경의 일반값으로 받아들이기는 어렵습니다.
9. 적용할 때 확인해야 할 한계
첫째, SwiGLU와 선형 빠른 가중치 구성에는 일반 어텐션의 일부 회전 불변성이 없습니다. 연구진도 이 성질이 실제 성능에 미치는 영향을 충분히 탐색하지 않았다고 설명합니다. 위치 표현과 결합할 때 별도의 검증이 필요한 지점입니다.
둘째, 시점 합성은 카메라 자세가 알려진 입력을 사용합니다. 자세를 모르는 이미지에서의 재구성까지 입증한 연구는 아닙니다. 언어모델의 복잡한 추론 능력이나 더 큰 파라미터 규모의 확장성도 계산 예산 때문에 충분히 평가되지 않았습니다.
셋째, 상태 크기를 입력 길이와 무관하게 유지하는 설계는 정보를 압축하는 과정입니다. 매우 긴 문맥에서 정확한 세부 사실을 얼마나 보존하는지, 실제 서비스의 단일 요청·동시 요청·생성 단계에서 지연과 메모리가 어떤지는 용도별로 다시 측정해야 합니다. 이는 논문의 보고 범위를 넘어 적용을 검토할 때 필요한 해설자의 판단입니다.
10. 변리사 관점의 기술 분석
10.1 기술적 과제
이 논문의 과제는 긴 입력을 처리하면서도 기억 갱신이 메모리 이동에 묶여 GPU를 제대로 사용하지 못하는 문제입니다. 작은 상태와 잦은 갱신은 구현 효율을 낮추고, 표현력이 큰 비선형 기억이나 복잡한 갱신 규칙을 사용하기 어렵게 만듭니다. 입력 내부의 순서·공간 관계와 멀리 떨어진 정보를 함께 처리해야 한다는 과제도 있습니다.
10.2 해결수단과 구성의 결합
해결수단은 큰 청크 단위의 기울기 계산, 비선형 빠른 가중치, L2 정규화를 포함한 갱신 규칙, 국소 관계를 처리하는 윈도 어텐션의 결합입니다. 데이터의 인과관계에 맞춰 Update·Apply 순서를 바꾸고, 필요하면 청크 안의 토큰을 여러 장치에 나눠 계산합니다. 각 구성은 기억의 표현력, 실행 효율, 정보 접근 범위를 서로 보완합니다.
10.3 기존 접근과 구별되는 내용
어텐션과 반복 상태를 함께 쓰는 아이디어 자체는 이전 연구에도 있었습니다. 이 논문에서 읽어야 할 차이는 매우 큰 청크를 하드웨어 병렬 처리 단위로 삼고, 그 효율을 큰 비선형 상태와 갱신 규칙의 선택 폭을 넓히는 데 사용했다는 점입니다. 단순히 “TTT를 사용했다”는 이름보다 청크 크기·기억 함수·갱신 순서·윈도 어텐션의 연결 관계가 기술적 설명의 중심입니다.
10.4 실험으로 확인된 기술적 효과
시점 합성에서는 정해진 A100 조건에서 입력 처리 지연 감소와 빠른 렌더링을, 언어모델에서는 760M·3B 조건에서 특정 반복 상태 기준선 대비 긴 문맥 손실과 검색 정확도 개선을 확인할 수 있습니다. 설계 선택 실험은 비선형 상태와 Muon 결합의 의미를 뒷받침합니다. 동시에 처리량과 품질의 교환관계, 과제별 측정 범위까지 함께 적어야 효과의 설명이 정확해집니다.
11. 마무리
LaCT는 인공지능의 기억을 더 자주 고치기보다, 한 번에 충분한 정보를 처리하도록 설계한 연구입니다. 큰 청크가 GPU의 병렬성을 활용하게 하고, 윈도 어텐션이 가까운 관계를 맡으며, 비선형 빠른 가중치가 먼 문맥을 담는 구조가 핵심입니다.
이 논문의 의미는 청크 하나의 크기보다 여러 구성의 연결에서 드러납니다. 어떤 입력에서 어떤 순서로 기억을 갱신하고, 그 결과 어떤 지표가 얼마나 달라졌는지를 함께 보면 LaCT의 기술적 기여와 아직 검증이 필요한 영역을 구분할 수 있습니다.