
论文与分析版本
Test-Time Training Done Right提出Large Chunk Test-Time Training(LaCT)。作者为Tianyuan Zhang、Sai Bi、Yicong Hong、Kai Zhang、Fujun Luan、Songlin Yang、Kalyan Sunkavalli、William T. Freeman及Hao Tan,署名单位是MIT与Adobe Research。论文于2025年5月29日首次公开,编号arXiv:2505.23884,DOI为10.48550/arXiv.2505.23884。另已核实ICLR 2026收录信息,但本文机制、图表和数据统一依据32页的arXiv v1。原图署名Zhang等,按CC BY 4.0使用。
快速权重是当前上下文的临时记忆
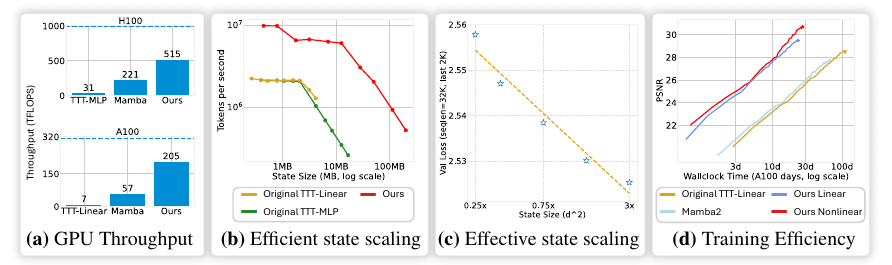
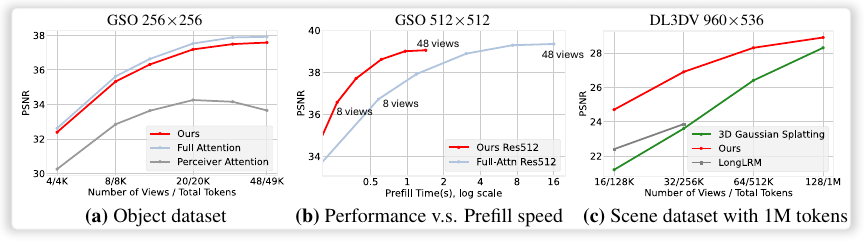
普通注意力通过查询读取已保存的键和值;TTT把键值关系写入小型网络的可更新权重W,再用查询读取。快速权重随当前输入改变,基础模型的慢速权重在推理时固定,并非使用人工提供的新标签重新训练整个模型。逐令牌或每16~64个令牌更新,会反复搬运权重,使GPU计算单元难以充分利用。LaCT针对不同任务,将2K至约1M令牌作为一次更新单位。图1中的吞吐量、状态规模、损失和视点合成训练时间属于不同指标,不能合并为通用服务加速倍数。
局部注意力与非线性记忆相互补充
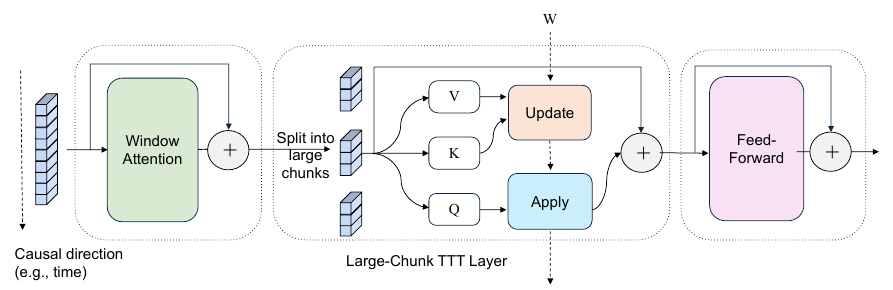
窗口注意力负责局部顺序和空间关系;大分块更新把令牌视为集合,因此需要补充局部结构。默认记忆是包含三个矩阵的SwiGLU MLP,以键输入的网络输出与值的负内积为损失,结合逐令牌学习率汇总分块梯度,再由查询读取快速权重。固定大小并不意味着容量无限。研究比较梯度下降、动量和Muon,后者用Newton–Schulz迭代变换矩阵梯度,更新后还对快速权重进行L2归一化。减少更新次数有助于采用更大的状态和更复杂的规则。
更新顺序必须遵守信息可见范围
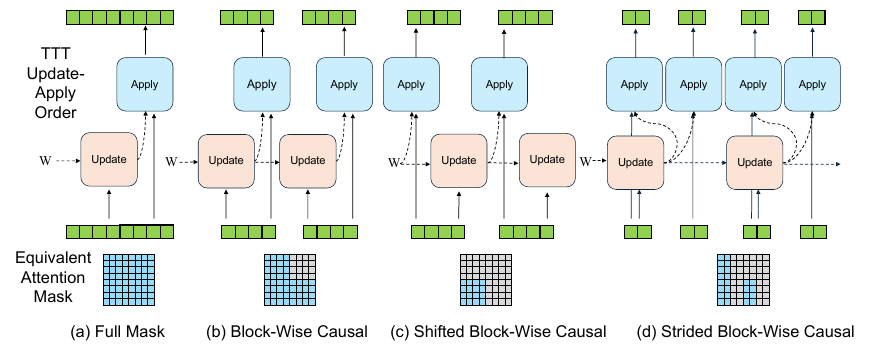
输入生成Q、K、V及学习率,局部注意力与记忆输出相结合,再经过前馈层。语言与视频配置还可共享Q、K、V并相加输出。语言模型先把仅包含先前分块的记忆应用于当前分块,再以当前信息更新下一分块的记忆;块内因果关系由因果滑动窗口注意力处理,否则会泄露未来令牌。相机姿态已知的图像集合可以先更新记忆,再读取目标视点。视频只用干净帧块更新,带噪块读取此前积累的信息。
视点合成的测量条件
物体实验用Objaverse训练、Google Scanned Objects评估,场景实验采用DL3DV。PSNR衡量重建质量,此处越高越好。表2条件为A100、48张512×512图像、约196K输入令牌和4K解码令牌。全注意力的输入处理为16.1秒、渲染2.3 FPS;Perceiver为16.8秒、34.4 FPS;LaCT为1.4秒、38.7 FPS。模型规模分别为284M、287M、312M。约11.5倍的输入时延差只适用于该设置,并非语言模型响应速度承诺。画质接近全注意力但不在所有点领先。最大场景设置为128张960×536图像、约百万视觉令牌,不能解读为百万令牌语言文档的同等验证。
语言模型的质量与吞吐量
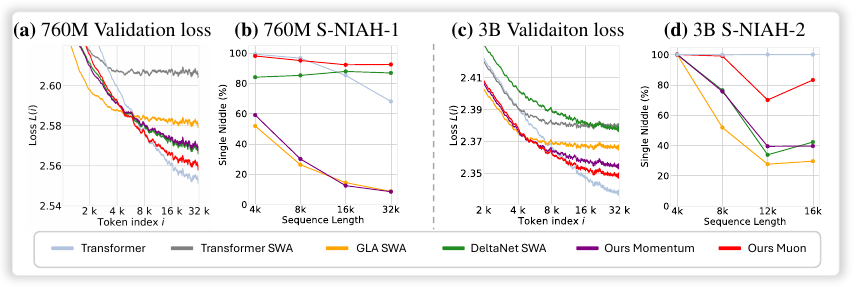
训练序列为32,768令牌;760M模型用40B训练令牌和2,048窗口,3B模型用60B及4,096窗口。GLA和DeltaNet也搭配相同滑动窗口。位置损失与S-NIAH检索显示,Muon配置优于这些循环状态基线,但全注意力仍有更好的测量点。表3在A100-40GB、3B、32K条件下报告训练吞吐量:Transformer 4.1K tokens/s、仅窗口6.4K、GLA 5.0K、DeltaNet 5.1K、LaCT梯度下降5.0K、动量4.9K、Muon 4.3K。Muon的质量收益伴随更新成本,并非吞吐量最高的配置。
提升不能全部归因于分块大小
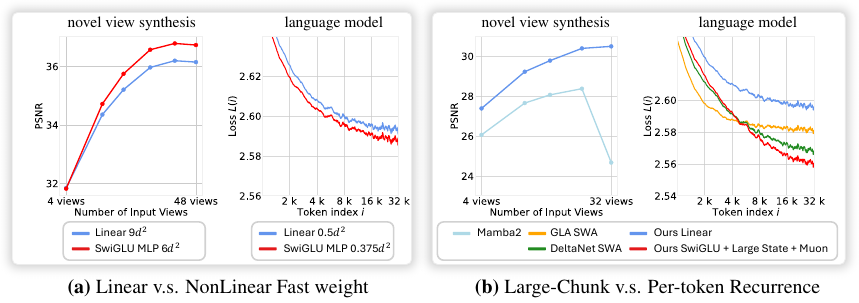
图8区分了记忆表示和更新粒度。较小的非线性SwiGLU状态可以优于更大的线性状态;相同状态大小的线性分块更新并未超过GLA,较大的非线性状态与Muon组合才取得改善。最大设置中快速权重约占模型参数40%,这不是全部LaCT模型的固定比例。容量收益应与内存占用和更新开销一起分析。
视频实验和分布式计算
研究将预训练Wan 2.1改为1.3B及14B自回归视频扩散模型。14B设置的8.8秒片段包含56,160视觉令牌;训练中交错的干净块与带噪块约107K令牌,是另一统计量。训练5,000轮后,在2,000个视频、五个噪声时点测量去噪损失。这不等于直接评估人类偏好或长视频观感,非公开训练视频也限制复现。把分块分配给不同设备并合并更新梯度可进行上下文并行;1~3%的开销仅来自特定视点合成训练环境,不能推广到全部网络和设备数量。
尚未解决的验证问题
SwiGLU与线性快速权重不具有部分注意力机制中Q、K共同旋转的不变性,其实际影响尚未充分研究。视点合成依赖已知相机姿态,未验证未知姿态重建、复杂语言推理及更大语言模型。固定状态压缩信息后,对精确细节保留、并发请求、生成时延和内存消耗应按应用另行测量。这些属于本文的实施评估建议,并非论文新增实验结论。
从专利分析角度理解技术贡献
技术问题在于频繁更新和内存搬运妨碍GPU并行利用。解决方案结合大分块梯度计算、非线性快速权重、归一化更新规则和窗口注意力,并按任务调整读写顺序、采用上下文并行。注意力与循环状态的结合已有先行研究,重点在于大并行更新单位如何支持更丰富的状态与优化规则。技术效果应保留视点合成、760M或3B语言模型等条件,同时说明质量与吞吐量的权衡。论文机制分析并不直接等于专利新颖性或创造性的结论。