
Задача исследования
Работа Gated Bidirectional Linear Attention for Generative Retrieval Artem Matveev, Vladislav Tytskiy, Sergei Makeev и Sergei Liamaev из Yandex посвящена эффективному использованию длинной истории взаимодействий. Анализ основан на версии 2 arXiv от 8 июня 2026 года работы, принятой на SIGIR 2026. Генеративный поиск выдаёт семантические идентификаторы кандидатов, а не обычный текстовый ответ.
Двунаправленная история и авторегрессионный выход
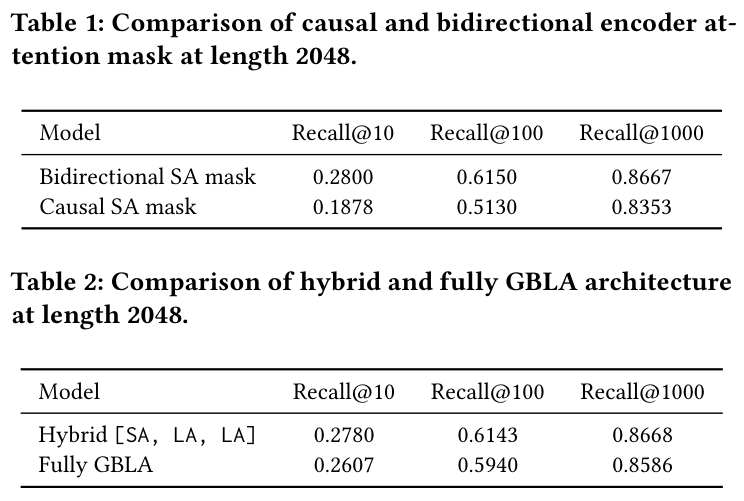
Кодировщик сопоставляет обе стороны уже наблюдённой к моменту прогноза истории, тогда как декодировщик авторегрессионно генерирует токены идентификатора. Это не означает доступа к будущим целевым меткам. В промышленном эксперименте при длине 2 048 Recall@1000 составляла 0,8667 для двунаправленного самовнимания и 0,8353 для причинной маски: разница 3,14 процентного пункта.
Линейное вычисление и три дополнения
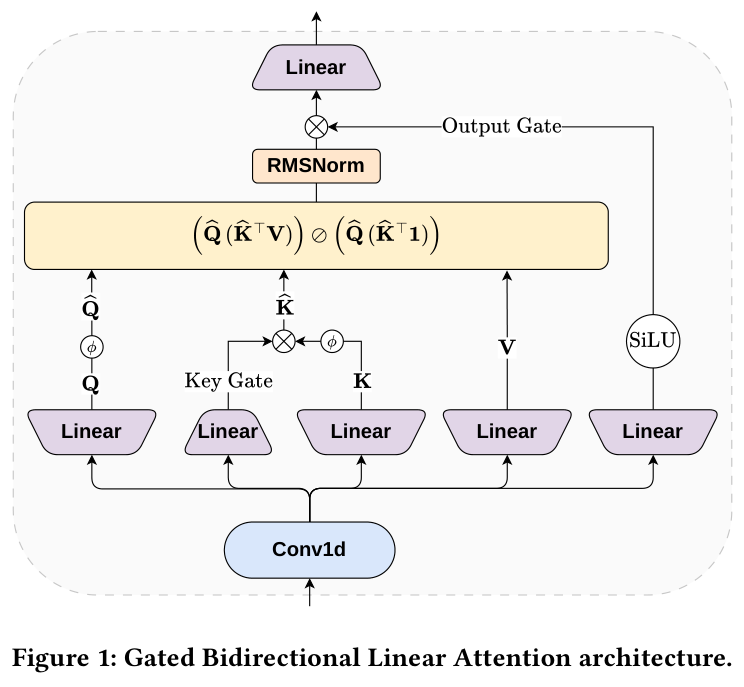
Стоимость обычного внимания пропорциональна L²dh. Ядерное двунаправленное линейное внимание переставляет операции в φ(Q)(φ(K)ᵀV) с нормировкой на φ(Q)(φ(K)ᵀ1), используя положительное отображение, например ELU+1. Основное вычисление имеет порядок Ldh² и линейно по длине L при фиксированной ширине dh.
GBLA добавляет локальное причинное смешивание Conv1D перед проекциями Q/K/V, скалярный гейт ключей с нормировкой по позициям и выходной гейт с RMSNorm и SiLU. Вес ключа действует и на агрегат признаков, и на знаменатель. Это мягкое взвешивание важности, а не двоичное удаление или рекуррентное забывание. Размер ядра свёртки в эксперименте равен четырём.
Зачем нужен гибридный кодировщик
Многохешевые эмбеддинги объединяются и проецируются в кодировщик, далее используется декодировщик с перекрёстным вниманием. Девять слоёв повторяют [самовнимание, GBLA, GBLA]: три слоя самовнимания сохраняются, шесть заменяются. Поэтому весь гибрид не является полностью линейным. При длине 2 048 Recall@1000 равнялась 0,8668 для гибрида и 0,8586 для всех слоёв GBLA, разница — 0,82 пункта.
Промышленные результаты и абляции
На закрытых данных Yandex использовались семь дней и около 400 млн обучающих примеров с оценкой на следующем дне. Кодировщик имел девять слоёв, ширину 1 024 и 16 голов, причинный декодировщик — один слой. Эффективный размер батча совпадал, но максимальные скорости обучения различались: 7×10⁻⁴ и 5×10⁻⁴. Recall@1000 оценивает охват кандидатов для последующего ранжирования, а не клики или выручку.
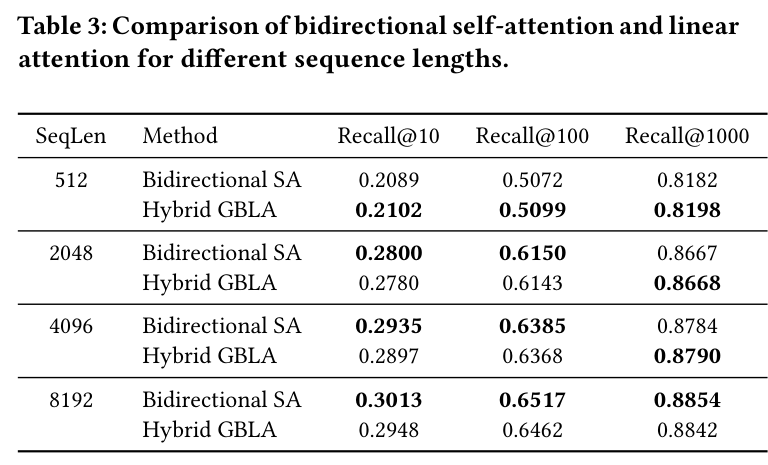
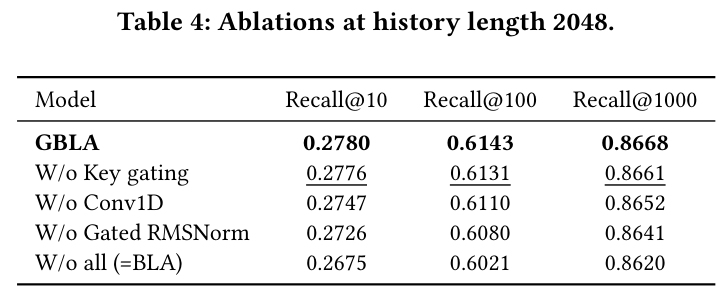
Самовнимание/гибрид дали Recall@1000 0,8667/0,8668 при 2 048; 0,8784/0,8790 при 4 096; 0,8854/0,8842 при 8 192. В последнем случае Recall@10 составила 0,3013/0,2948: улучшения не были всеобщими. При 2 048 удаление гейта ключей, свёртки или RMSNorm с гейтом снижало Recall@1000 с 0,8668 до 0,8661, 0,8652 или 0,8641. Простое линейное внимание давало 0,8620 и Recall@10 0,2675 против 0,2780 у GBLA. Эти точечные оценки сами по себе не доказывают статистическую значимость.
Ускорение слоя и всего обучения
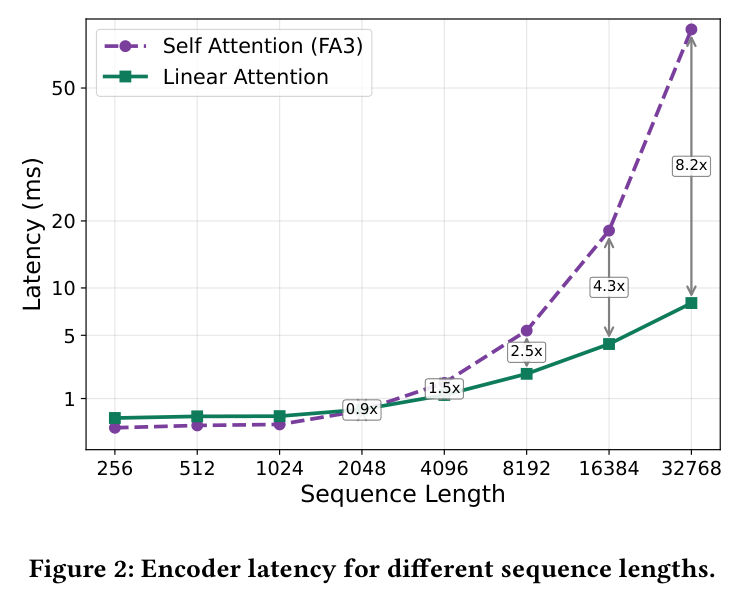
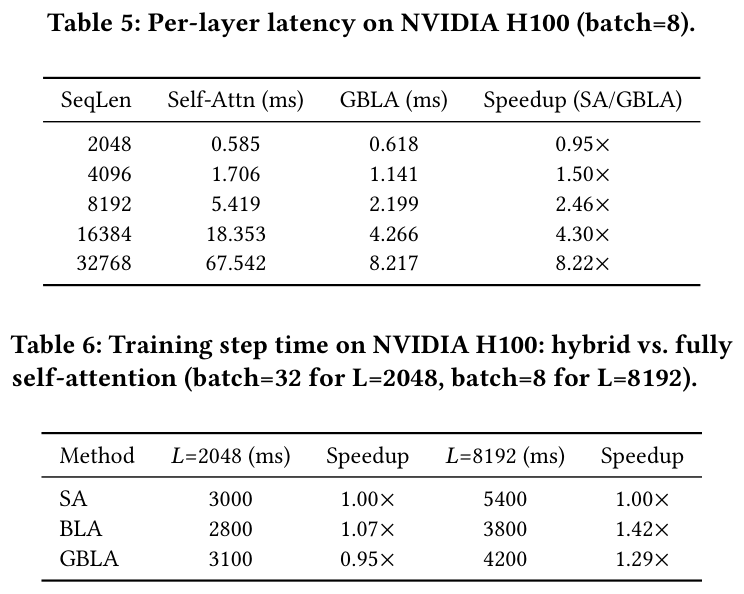
Тест одного слоя на H100 использовал батч восемь, среднее десяти запусков и FlashAttention-v3 как базу. При длине 2 048 GBLA занимала 0,618 мс против 0,585 мс, то есть была медленнее. Ускорение составляло 1,50× при 4 096, 2,46× при 8 192 и 8,22× при 32 768: 8,217 против 67,542 мс. Показатель 8,2× относится к этому слою, а не ко всему сервису.
Полный шаг обучения при 8 192 и батче восемь сократился с 5 400 до 4 200 мс, около 1,29×. При 2 048 и батче 32 гибрид занимал 3 100 против 3 000 мс. Простое линейное внимание при 8 192 было быстрее — 3 800 мс, но с указанным компромиссом по качеству. Разные батчи не позволяют объяснять различия строк только длиной истории.
Открытые тесты и ограничения
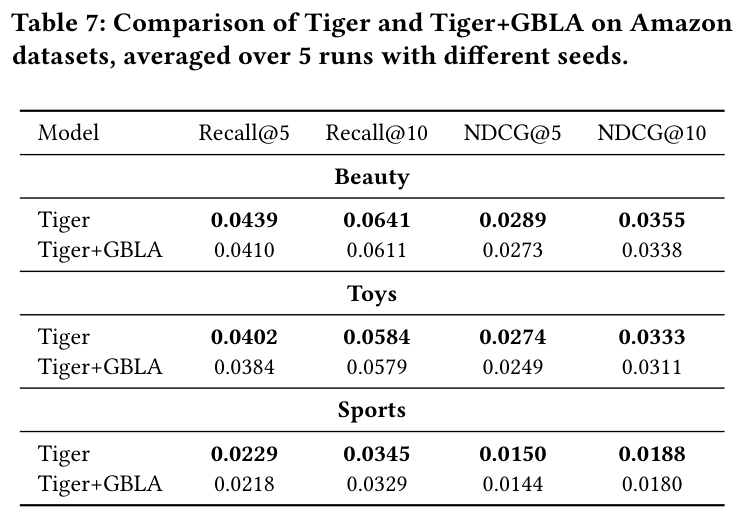
Для Amazon Beauty, Toys и Sports использовался протокол GRID/Tiger: фильтрация 5-core, последнее взаимодействие для теста, предпоследнее для валидации, эмбеддинги Flan-T5 и семантические ID RK-Means. Истории ограничены 128 элементами, результаты усреднены по пяти инициализациям. Recall@10 Tiger/GBLA: 0,0641/0,0611, 0,0584/0,0579 и 0,0345/0,0329 соответственно.
Опубликованные Recall и NDCG у GBLA были немного ниже. Близость чисел не доказывает эквивалентность; эффективность на коротких историях не измерялась. Промышленные данные закрыты, а выводы ограничены указанными аппаратными, архитектурными и экспериментальными условиями.
Патентный взгляд на сочетание средств
Важно связать задачу длинной истории с конкретным сочетанием локального смешивания, весов ключей, выходных гейтов и сохранённого самовнимания. Анализ должен различать отдельные элементы и их комбинацию, определять необходимые признаки формулы и сопоставлять заявленные эффекты с экспериментами.
Публикация не доказывает новизну или патентоспособность возможной формулы. Уровень техники, объём охраны и достаточность раскрытия требуют отдельной оценки. При внедрении следует совместно измерять поиск кандидатов, последующее ранжирование, память и общую задержку. Исходные рисунки и таблицы сохранены с русскими пояснениями; ниже приведены работа и атрибуция CC BY 4.0.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Связанная практика: патенты в области ИИ
Работа и иллюстрации: Matveev и соавторы, GBLA v2, 2026 (CC BY 4.0) · CC BY 4.0