인공지능 특허 전문 변리사의 논문 분석
작성자: 김용덕 변리사
안녕하세요. 아이피렉스 특허법률사무소, 김용덕 변리사입니다.
음악 추천 서비스는 사용자가 들은 곡이 많아질수록 취향을 더 풍부하게 파악할 수 있습니다. 그러나 과거 기록을 길게 읽는 데 시간이 너무 오래 걸린다면, 많은 정보를 가진 장점이 실제 서비스의 속도로 이어지지 못합니다.
이번에 살펴볼 GBLA는 생성형 추천에서 긴 사용자 이력을 읽는 인코더를 효율화하는 논문입니다. 이미 관측한 이력 전체를 양방향으로 읽으면서, 기록끼리의 모든 관계를 큰 행렬로 펼치는 계산을 줄이는 것이 핵심입니다.
한 문장으로 정리하면, GBLA는 선형 어텐션에 가까운 기록의 패턴, 이력별 중요도, 출력 조절 기능을 더하고 기존 자기어텐션과 함께 배치해 긴 이력 처리의 비용과 추천 품질을 조율하는 방법입니다.
1. 논문 기본 정보
논문 제목: Gated Bidirectional Linear Attention for Generative Retrieval
논문 저자: Artem Matveev, Vladislav Tytskiy, Sergei Makeev, Sergei Liamaev. 논문에 표시된 소속은 네 명 모두 Yandex, Moscow, Russia입니다.
최초 공개일은 2026년 6월 5일이며, 이 글은 2026년 6월 8일 공개된 arXiv:2606.07317v2를 기준으로 분석합니다. arXiv에는 SIGIR 2026 채택 논문으로 표시되어 있고, 저자본에는 해당 학회 프로시딩 정보와 ACM DOI 10.1145/3805712.3808495가 기재되어 있습니다. arXiv DOI는 10.48550/arXiv.2606.07317입니다.
Matveev 외, 2026의 arXiv 공개본은 CC BY 4.0으로 제공됩니다. 아래 도표 번호는 해당 v2의 번호이며, 도표의 수치와 영문 표기를 유지했습니다.
2. 기술적 과제: 이력은 길어지는데 계산은 더 빠르게 늘어난다
일반적인 자기어텐션은 한 기록을 해석할 때 다른 기록들과의 관계를 계산합니다. 이력 길이를 L이라고 하면 관계의 수는 대략 L의 제곱에 따라 늘어납니다. 기록을 두 배로 늘렸을 때 핵심 어텐션 계산량이 약 네 배가 될 수 있는 이유입니다.
생성형 추천에서는 인코더가 사용자 이력을 읽고, 디코더가 다음 추천 후보의 의미 ID를 순서대로 생성합니다. 의미 ID는 아이템의 의미를 표현하도록 구성한 코드이며, 자연어 답변을 만드는 것과는 출력 대상이 다릅니다.
이 논문이 유지하려는 양방향성은 이미 입력된 과거 기록 사이에서 양쪽 정보를 함께 읽는 성질입니다. 정답이 되는 미래 행동을 입력으로 제공한다는 뜻은 아닙니다. 디코더는 여전히 앞서 생성한 토큰을 바탕으로 다음 토큰을 만드는 인과적 구조를 사용합니다.
3. 기초 개념: 거대한 관계표 대신 작은 요약을 먼저 만든다
기존 소프트맥스 어텐션을 모든 방문 기록 사이의 관계를 적은 큰 표에 비유할 수 있습니다. 양방향 선형 어텐션(BLA)은 키와 값의 정보를 먼저 모은 뒤, 각 질의가 이 요약을 읽도록 계산 순서를 바꿉니다.
이를 위해 지수함수 기반 유사도를 비음수 특징의 내적으로 바꿉니다. 논문은 특징 변환의 예로 ELU(x)+1을 제시합니다. 핵심 연산은 Q(KᵀV) 형태의 결합 순서이며, 분모에서도 키의 합을 이용해 출력을 정규화합니다. 실제 식에는 특징 변환된 Q와 K가 사용됩니다.
헤드 차원을 dₕ라고 할 때 어텐션 핵심 계산은 O(L²dₕ)에서 O(Ldₕ²)로 바뀝니다. dₕ가 고정되면 L에 선형으로 증가하지만, 이것만으로 전체 모델의 모든 연산이나 실제 지연 시간이 선형이라고 단정할 수는 없습니다.
4. GBLA의 핵심: 세 가지 보완 장치를 어디에 놓는가
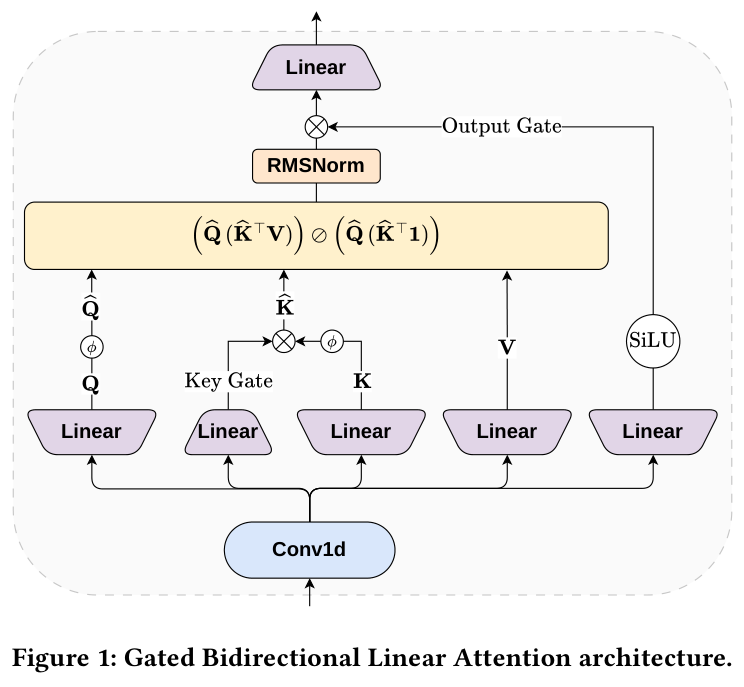
원문 Figure 1 · Matveev 외(2026), arXiv:2606.07317v2, CC BY 4.0. 입력의 국소 혼합, 키 게이트, 출력 게이트가 서로 다른 위치에서 작동합니다.
① Conv1D: 이웃한 기록의 패턴을 먼저 반영한다
연구진은 입력 임베딩에 1차원 합성곱을 적용한 뒤 Q·K·V를 만듭니다. 원문이 설명하는 국소 인과 혼합은 인접한 기록의 짧은 패턴을 반영하는 역할을 합니다. 실험의 합성곱 커널 크기는 4입니다. 음악 감상의 연속적인 흐름처럼 가까운 기록 사이에 있는 단서를 전역 요약에 앞서 처리하는 구성으로 이해할 수 있습니다.
② 키 게이트: 어떤 기록을 요약에 더 반영할지 조절한다
각 기록에 스칼라 게이트를 계산하고, 시퀀스 방향의 소프트맥스로 정규화합니다. 이 가중치를 키 특징에 곱한 뒤 키–값 요약과 분모를 구성합니다. 중요도가 낮은 기록의 기여를 완만하게 줄이는 방식입니다.
여기서 게이트는 기록을 무조건 삭제하는 이진 선택이 아닙니다. 또한 시간 순서대로 이전 기억에 감쇠율을 누적 곱하는 재귀적 망각과도 구분됩니다. 입력 이력 전체에서 각 기록이 요약에 기여하는 비중을 학습한다는 점이 이 식의 특징입니다.
③ 게이트가 결합된 RMSNorm: 읽어 낸 출력을 다시 조절한다
어텐션 출력에 RMSNorm을 적용한 뒤, 입력으로부터 별도로 계산한 SiLU 게이트를 원소별로 곱합니다. 앞의 키 게이트는 요약에 들어갈 기록의 기여를 조절하고, 이 출력 게이트는 요약에서 읽어 낸 표현을 조절합니다. 같은 게이트라는 이름이 붙어도 작용 대상과 위치가 다릅니다.
5. 실제 처리 흐름과 하이브리드 인코더
처리 순서는 다음과 같습니다. 먼저 아이템 ID를 여러 해시 임베딩으로 바꾸고 결합·투영합니다. 이어 GBLA 층에서 Conv1D로 주변 패턴을 반영하고, Q·K·V와 키 게이트를 계산합니다. 가중 키–값 요약을 질의가 읽은 뒤 정규화와 출력 게이트를 적용합니다. 마지막으로 디코더가 인코더 표현을 교차어텐션으로 참조하여 추천 후보의 의미 ID를 생성합니다.
연구진이 주로 평가한 구조는 GBLA로 모든 층을 바꾸는 형태가 아닙니다. 기존 자기어텐션(SA) 한 층 다음에 GBLA 두 층을 놓는 [SA, LA, LA] 패턴입니다. 산업 실험의 인코더 9개 층에서는 SA 3개와 GBLA 6개를 함께 사용합니다.
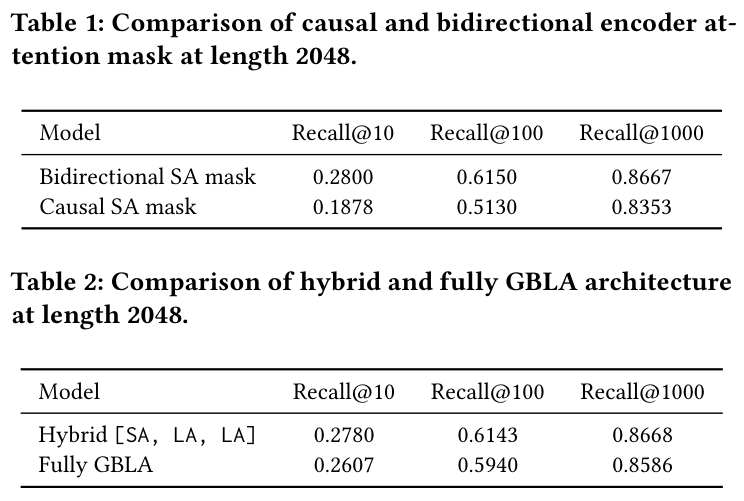
원문 Table 1·2 · Matveev 외(2026), CC BY 4.0. 동일한 이력 길이 2,048에서 양방향 마스크와 하이브리드 배치의 역할을 비교합니다.
Table 1의 Recall@1000은 양방향 SA에서 0.8667, 인과적 SA에서 0.8353입니다. 차이는 3.14%포인트입니다. 이 실험에서는 인코더의 양방향성을 보존하는 것이 추천 후보 회수에 유리했습니다.
Table 2에서는 하이브리드 구조가 0.8668, 전부 GBLA로 구성한 구조가 0.8586입니다. 기존 SA를 일부 남긴 배치가 0.82%포인트 높습니다. 따라서 이 논문의 실용적 설계는 효율적인 층과 세밀한 관계 계산을 담당하는 층의 조합에 있습니다. SA가 남아 있으므로 하이브리드 전체의 이론적 복잡도가 완전히 선형이 된다고 설명해서는 안 됩니다.
6. 실험 설계와 추천 품질
산업 실험은 Yandex Music의 비공개 데이터로 진행됐습니다. 연속 7일의 상호작용에서 4억 개 학습 샘플을 추출하고 시간순으로 학습했으며, 다음 날 데이터를 평가에 사용했습니다. 인코더는 9개 층, 은닉 차원 1,024, 어텐션 헤드 16개이고 디코더는 자기어텐션과 교차어텐션을 갖는 인과적 1개 층입니다.
평가 지표는 Recall@10·100·1000입니다. Recall@1000은 상위 1,000개 후보 안에서 정답 아이템을 얼마나 회수하는지 보는 지표입니다. 연구진의 파이프라인은 이 후보들을 다음 랭커에 전달하므로 Recall@1000을 특히 강조합니다. 이 값은 클릭률이나 매출 증가율과 같지 않습니다.
유효 배치 크기는 맞췄지만 최적의 최대 학습률은 SA 7×10⁻⁴, 하이브리드 5×10⁻⁴로 다르게 설정했습니다. 따라서 결과는 각 구조에 맞춘 학습 설정에서 비교한 것으로 읽어야 합니다.
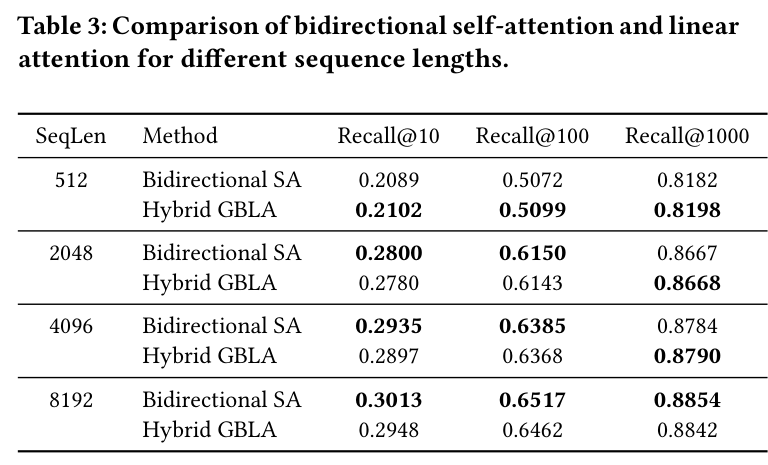
원문 Table 3 · Matveev 외(2026), CC BY 4.0. 이력 길이에 따른 Recall을 비교하며, 모든 지표에서 GBLA가 우세한 것은 아닙니다.
이력 2,048에서 Recall@1000은 SA 0.8667, 하이브리드 GBLA 0.8668로 비슷합니다. 이력 4,096에서는 0.8784와 0.8790입니다. 이력 8,192에서는 SA 0.8854, GBLA 0.8842로 GBLA가 0.12%포인트 낮습니다.
또한 이력 8,192의 Recall@10은 0.3013에서 0.2948로 내려갑니다. 후보를 넓게 회수하는 단계에서의 근접한 품질을, 소수의 최상위 추천까지 모두 동등하다는 주장으로 확대하면 안 됩니다.
7. 세 가지 보완 장치는 실제로 도움이 되었는가
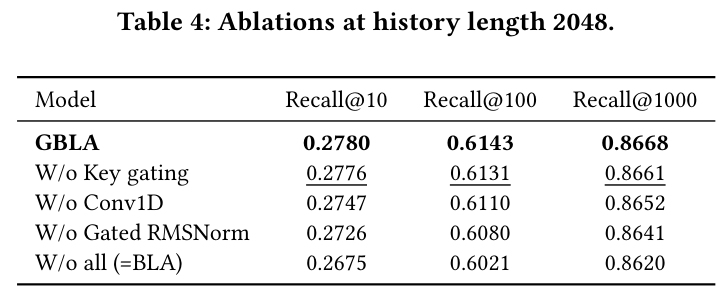
원문 Table 4 · Matveev 외(2026), CC BY 4.0. 이력 2,048에서 구성 요소를 하나씩 제거한 실험입니다.
전체 GBLA의 Recall@1000은 0.8668입니다. 키 게이트를 빼면 0.8661, Conv1D를 빼면 0.8652, 게이트 RMSNorm을 빼면 0.8641이며, 세 요소를 모두 뺀 BLA는 0.8620입니다. 모두 제거했을 때와의 차이는 0.48%포인트입니다.
Recall@10에서도 GBLA 0.2780에 비해 BLA는 0.2675입니다. 이 결과는 각 보완 요소가 해당 실험에서 품질 유지에 기여했다는 근거입니다. 다만 표에는 신뢰구간이나 통계 검정 결과가 제시되어 있지 않으므로, 작은 차이를 보편적인 유의성으로 단정하지 않습니다.
8. 속도 효과: 단일 층과 전체 학습을 구분해야 한다
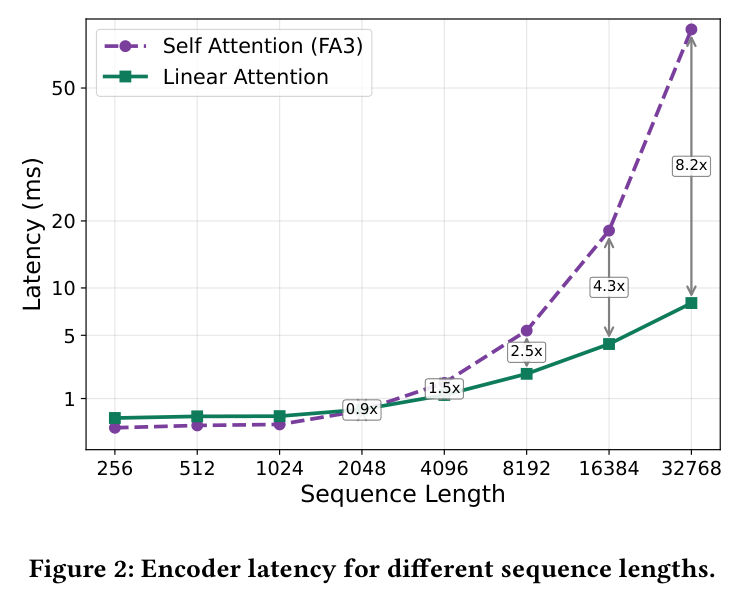
원문 Figure 2 · Matveev 외(2026), CC BY 4.0. 가로축은 시퀀스 길이, 세로축은 지연 시간입니다. 원문 3.4절의 단일 층 추론 비교로 해석해야 합니다.
추론 속도 실험은 NVIDIA H100, 배치 크기 8에서 단일 GBLA 층을 FlashAttention-v3와 비교하고 10회 평균을 보고합니다. 이력 4,096에서 1.50배, 8,192에서 2.46배, 32,768에서 8.22배의 속도비가 나타납니다.
그러나 이력 2,048에서는 SA 0.585ms, GBLA 0.618ms로 GBLA가 더 느립니다. 추가된 합성곱과 게이트 등의 비용을 줄어든 관계 계산 비용이 충분히 상쇄해야 이득이 생긴다는 의미입니다. 논문 제목과 함께 보이는 8.2배를 추천 서비스 전체의 응답 속도로 읽어서는 안 됩니다.
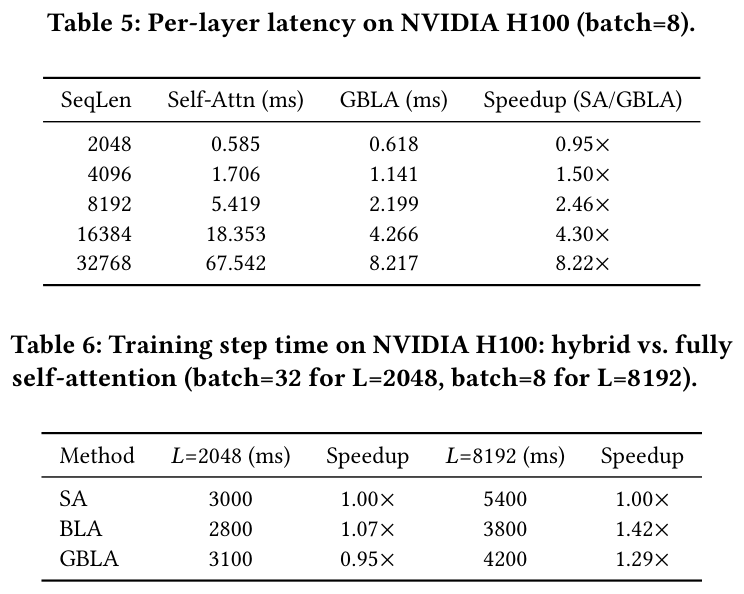
원문 Table 5·6 · Matveev 외(2026), CC BY 4.0. 위 표는 단일 층 추론, 아래 표는 전체 모델의 학습 스텝 시간입니다. 서로 다른 측정 범위입니다.
전체 하이브리드 모델의 학습에서는 이력 8,192·배치 8일 때 SA 5,400ms, GBLA 4,200ms로 1.29배 속도비를 보입니다. 이력 2,048·배치 32에서는 3,000ms와 3,100ms로 오히려 GBLA가 느립니다. 이력 길이별 배치 크기도 다르므로 두 열을 같은 배치의 길이 확장 실험처럼 비교할 수 없습니다.
보완 요소가 없는 BLA는 이력 8,192에서 3,800ms로 GBLA보다 빠릅니다. 대신 앞의 제거 실험에서 추천 품질은 낮았습니다. 이 논문은 가장 짧은 계산 시간 하나만 추구하기보다 품질을 보완하는 비용을 어디까지 감수할지 보여 줍니다.
9. 공개 데이터에서의 결과와 적용 한계
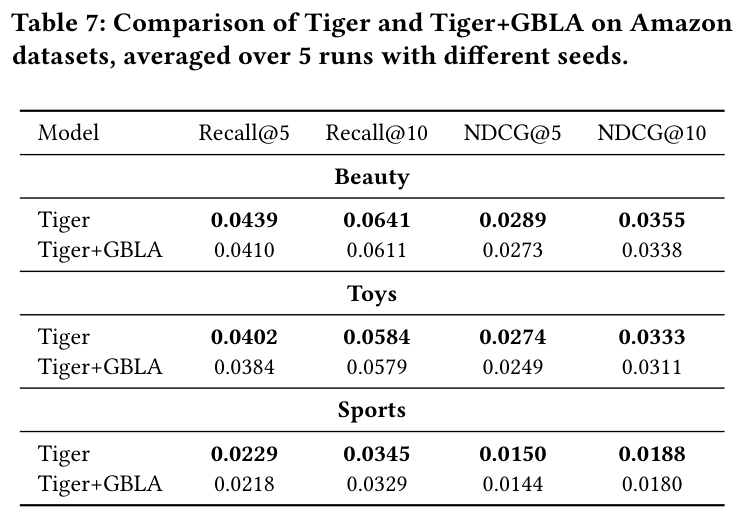
원문 Table 7 · Matveev 외(2026), CC BY 4.0. Amazon Beauty·Toys·Sports에서 5회 평균을 비교한 결과입니다.
공개 실험은 5-core 필터링을 적용한 Amazon Beauty·Toys·Sports 데이터와 GRID의 Tiger 생성형 추천 구성을 사용합니다. 각 사용자 시퀀스의 마지막 아이템은 테스트, 뒤에서 두 번째는 검증에 사용합니다. 아이템 텍스트에서 Flan-T5 표현을 만들고 RK-Means 기반 의미 ID를 구성하는 설정을 따릅니다.
Table 7의 Recall@10은 Beauty에서 Tiger 0.0641, Tiger+GBLA 0.0611, Toys에서 0.0584와 0.0579, Sports에서 0.0345와 0.0329입니다. 표에 제시된 Recall·NDCG 수치는 모두 GBLA 쪽이 조금 낮습니다. 연구진은 결과가 비슷하다고 해석하지만, 이 표만으로 통계적 동등성이 입증됐다고 할 수는 없습니다.
공개 데이터의 이력은 최대 128개로 짧아 연구진은 해당 설정의 속도를 측정하지 않았습니다. 긴 이력에서의 속도 이득을 이 공개 실험에서 직접 재현한 결과는 아니라는 점을 구분해야 합니다.
적용을 검토할 때에는 실제 이력 길이, GPU와 구현 방식, 회수할 후보 수, 남겨 둘 SA 층의 비율을 함께 살펴야 합니다. 산업 데이터가 비공개이고 온라인 서비스의 클릭률·체류시간·매출 변화는 제시되지 않았으므로, 오프라인 Recall과 연산 지연을 넘어선 효과는 이 논문만으로 확정할 수 없습니다.
10. 변리사 관점에서 본 기술적 과제·해결 수단·차별성·효과
기술적 과제
핵심 과제는 생성형 추천 인코더가 긴 이력의 양방향 정보를 활용하면서도, 모든 기록 쌍을 계산하는 비용 증가를 완화하는 것입니다. 단순히 기록을 짧게 잘라 버리면 추천에 필요한 장기 단서를 잃을 수 있고, 단순한 선형 어텐션 대체만으로는 품질이 낮아질 수 있습니다.
해결 수단과 결합 관계
GBLA는 입력 단계의 Conv1D, 요약 구성 단계의 키 게이트, 요약을 읽은 뒤의 게이트 RMSNorm을 순서에 맞게 연결합니다. 그 바깥에서는 SA와 GBLA를 1:2 비율로 배치합니다. 국소 패턴 처리, 전역 요약의 가중치 조절, 출력 표현 조절, 기존 관계 계산의 일부 유지가 서로 다른 역할을 나눠 맡는 구조입니다.
기존 접근과 구별되는 내용
기술 분석상 주목할 부분은 선형 어텐션이라는 이름 자체보다 양방향 생성형 추천 인코더에 이 장치들을 어떻게 배치했는가입니다. 특히 키의 기여를 조절하는 게이트와 출력을 조절하는 게이트를 분리하고, 전부 교체하는 구조보다 일부 SA를 남긴 혼합 구조를 택했다는 점이 구체적인 설계 차이입니다. 이는 논문에 나타난 구성의 차이를 설명한 것입니다.
입증된 효과와 해석의 범위
실험으로 뒷받침되는 효과는 긴 이력에서의 단일 층 지연 감소, 특정 조건에서의 전체 학습 스텝 단축, 그리고 산업 데이터의 Recall@1000을 근접하게 유지한 결과입니다. 짧은 이력의 속도 저하와 일부 추천 지표 하락도 함께 나타납니다. 따라서 기술적 효과는 입력 길이·하드웨어·모델 배치·평가 지표라는 조건과 연결해서 설명하는 것이 정확합니다.
11. 마무리
GBLA가 보여 주는 설계 방향은 긴 사용자 이력을 작은 요약으로 읽되, 그 과정에서 잃기 쉬운 정보를 서로 다른 위치의 보완 장치로 다루는 것입니다. 양방향성을 유지하는 인코더, 기록별 기여를 조절하는 키 게이트, 출력 조절, 일부 SA의 보존이 함께 작동합니다.
이 논문을 읽을 때에는 8.2배라는 단일 수치보다 어떤 계산을 바꾸었고, 어떤 길이와 지표에서 이득을 얻었는지 보는 것이 유용합니다. 추천 후보의 품질과 계산 비용 사이의 균형을 구체적인 구성과 측정 조건으로 설명한다는 데 GBLA의 기술적 의미가 있습니다.
논문·도표: Matveev 외, GBLA v2, 2026 (CC BY 4.0) · CC BY 4.0