
El problema de investigación
Gated Bidirectional Linear Attention for Generative Retrieval, de Artem Matveev, Vladislav Tytskiy, Sergei Makeev y Sergei Liamaev, de Yandex, estudia el aprovechamiento eficiente de historiales extensos. Este análisis sigue la versión 2 de arXiv, de 8 de junio de 2026, del trabajo aceptado en SIGIR 2026. La recuperación generativa produce identificadores semánticos de elementos candidatos, no una respuesta textual convencional.
Historial bidireccional y salida autorregresiva
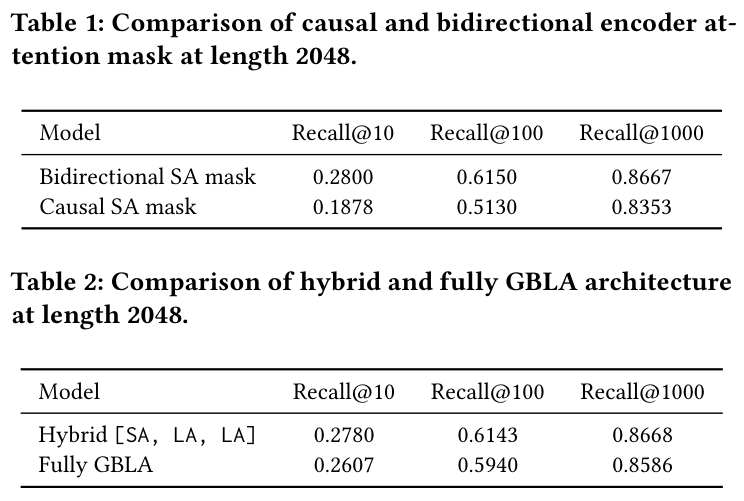
El codificador puede relacionar ambas direcciones del historial ya observado al predecir; el decodificador genera autorregresivamente los tokens del identificador. Eso no implica acceso a etiquetas futuras. En el ensayo industrial con longitud 2.048, Recall@1000 fue 0,8667 con autoatención bidireccional y 0,8353 con máscara causal: 3,14 puntos porcentuales de diferencia.
La operación lineal y tres mecanismos adicionales
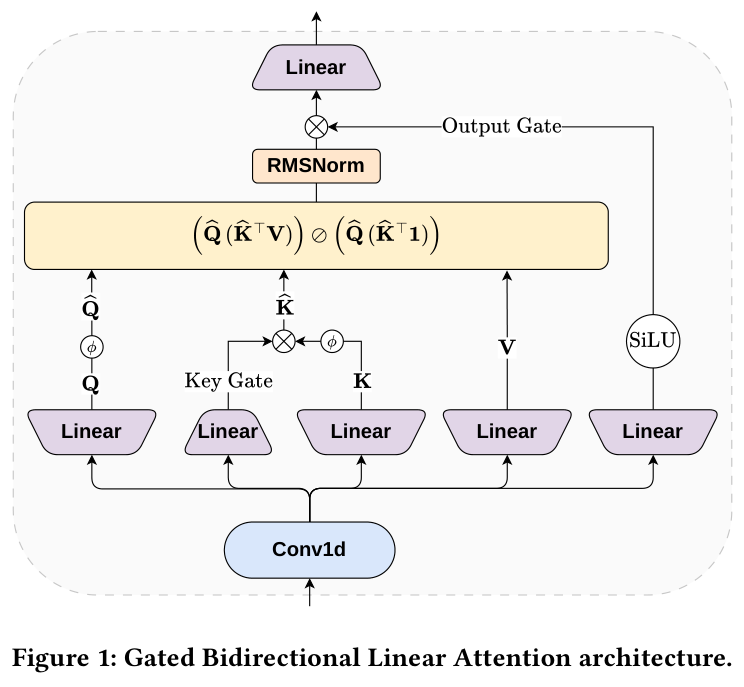
La atención ordinaria tiene un coste proporcional a L²dh. La atención lineal bidireccional basada en núcleos reorganiza el cálculo como φ(Q)(φ(K)ᵀV), normalizado por φ(Q)(φ(K)ᵀ1), con una transformación positiva como ELU+1. El núcleo computacional escala como Ldh²: es lineal en L sólo manteniendo fija la anchura dh.
GBLA añade mezcla local mediante Conv1D causal antes de las proyecciones Q/K/V, una compuerta escalar de claves normalizada entre posiciones y una compuerta de salida que combina RMSNorm y SiLU. El peso de las claves interviene tanto en el agregado como en su denominador; es ponderación suave, no eliminación binaria ni olvido recurrente. El núcleo de convolución utilizado tiene tamaño cuatro.
Por qué conservar una arquitectura híbrida
Se concatenan y proyectan representaciones multi-hash hacia el codificador, conectado a un decodificador con atención cruzada. Las nueve capas repiten [autoatención, GBLA, GBLA]: se conservan tres capas de autoatención y se sustituyen seis. El conjunto, por tanto, no es completamente lineal. Con longitud 2.048, Recall@1000 fue 0,8668 para el híbrido y 0,8586 para un codificador íntegramente GBLA, una diferencia de 0,82 puntos.
Resultados industriales y ablaciones
El experimento privado de Yandex empleó siete días y unos 400 millones de ejemplos de entrenamiento, con evaluación al día siguiente. El codificador tenía nueve capas, anchura 1.024 y 16 cabezas; el decodificador causal, una capa. Se igualó el tamaño efectivo de lote, pero las tasas máximas de aprendizaje fueron distintas: 7×10⁻⁴ y 5×10⁻⁴. Recall@1000 mide cobertura de candidatos para un clasificador posterior, no clics ni ingresos.
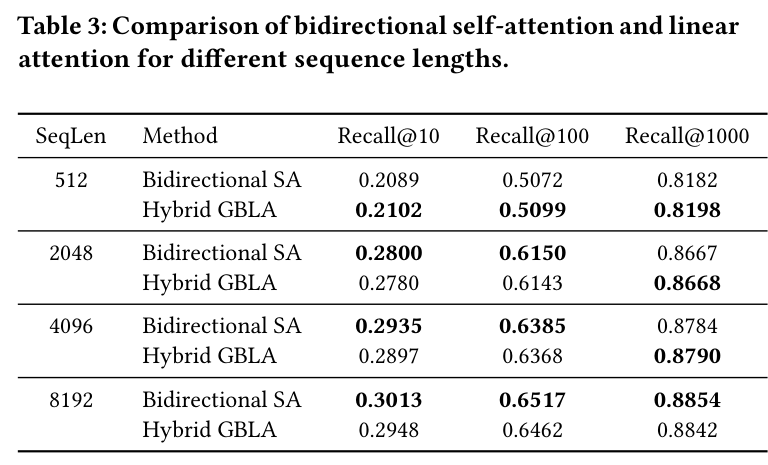
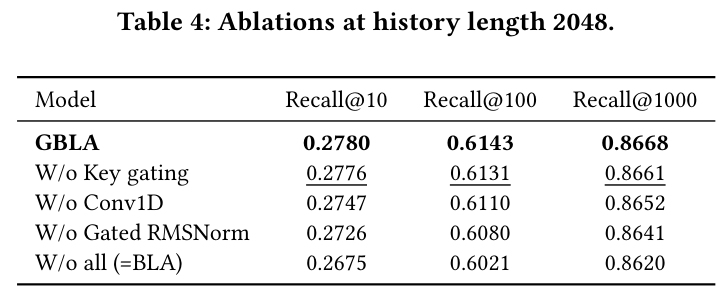
Autoatención/híbrido obtuvo 0,8667/0,8668 con longitud 2.048; 0,8784/0,8790 con 4.096; y 0,8854/0,8842 con 8.192. En esta última, Recall@10 fue 0,3013/0,2948: no todas las métricas mejoraron. A 2.048, quitar la compuerta de claves, la convolución o RMSNorm con compuerta redujo Recall@1000 de 0,8668 a 0,8661, 0,8652 o 0,8641. La atención lineal simple llegó a 0,8620 y Recall@10 de 0,2675, frente a 0,2780 de GBLA. Estas estimaciones no prueban por sí solas significación estadística.
Velocidad por capa frente al entrenamiento completo
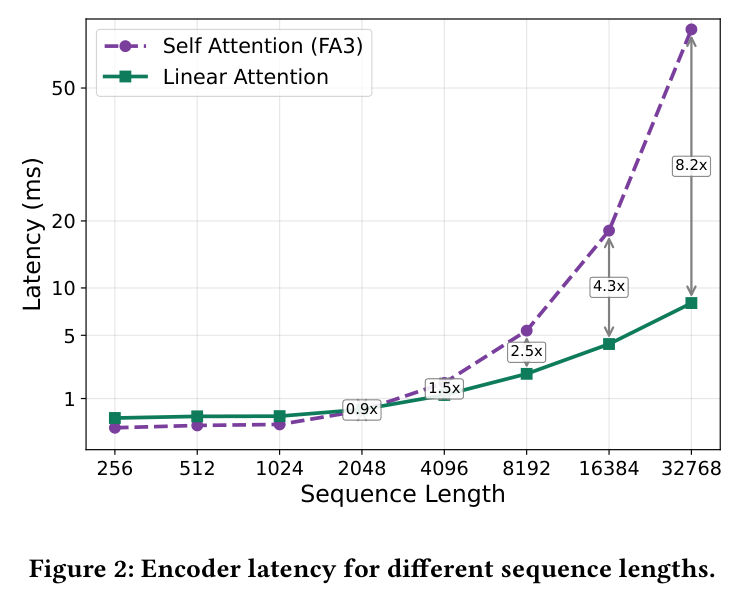
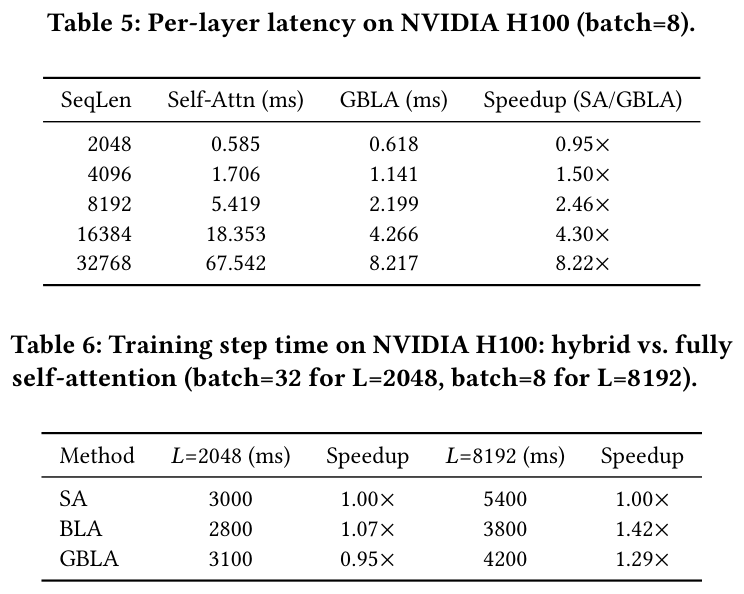
La comparación de una capa en H100 usó lote ocho, diez repeticiones y FlashAttention-v3 como referencia. A 2.048, GBLA tardó 0,618 ms frente a 0,585 ms: fue más lento. Las aceleraciones fueron 1,50× a 4.096, 2,46× a 8.192 y 8,22× a 32.768, con 8,217 frente a 67,542 ms. El titular de 8,2× corresponde a esa capa, no al servicio completo.
El entrenamiento completo a 8.192 y lote ocho pasó de 5.400 a 4.200 ms, aproximadamente 1,29×. A 2.048 y lote 32, el híbrido tardó 3.100 frente a 3.000 ms. La atención lineal simple fue aún más rápida a 8.192, con 3.800 ms, a costa de la calidad indicada. Los lotes cambian entre longitudes, por lo que las filas no aíslan únicamente el efecto de L.
Pruebas públicas y límites
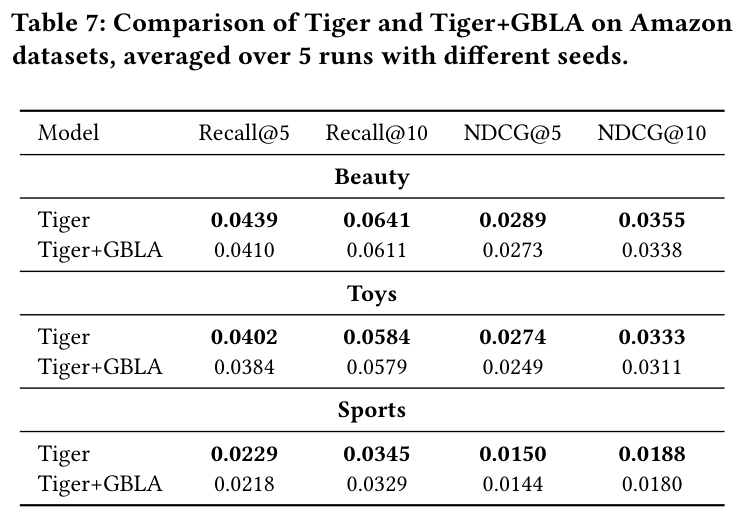
En Amazon Beauty, Toys y Sports se siguió GRID/Tiger con filtrado 5-core, última interacción para prueba y penúltima para validación, representaciones Flan-T5 e identificadores RK-Means. Los historiales tenían como máximo 128 elementos y se promediaron cinco semillas. Recall@10 de Tiger/GBLA fue 0,0641/0,0611, 0,0584/0,0579 y 0,0345/0,0329.
Los valores publicados de Recall y NDCG fueron ligeramente inferiores con GBLA. Proximidad numérica no demuestra equivalencia y no se midió eficiencia en estos historiales cortos. Los datos industriales son privados; las conclusiones dependen del hardware, la arquitectura y las condiciones declaradas.
Lectura desde la práctica de patentes
Interesa relacionar el problema de historiales extensos con la disposición concreta de mezcla local, ponderación de claves, compuertas de salida y autoatención conservada. El análisis debe separar componentes y combinación, precisar las características exigidas por las reivindicaciones y vincular los efectos con experimentos que los respalden.
El artículo no acredita novedad ni patentabilidad de una posible reivindicación. Antecedentes, alcance y suficiencia de la descripción requieren valoración propia. Para implementar, conviene medir recuperación de candidatos, clasificación posterior, memoria y latencia total. Se conservan las figuras y tablas originales con explicaciones en español; la publicación y la atribución CC BY 4.0 se enlazan a continuación.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Servicio relacionado: patentes de IA
Artículo y figuras: Matveev y colaboradores, GBLA v2, 2026 (CC BY 4.0) · CC BY 4.0