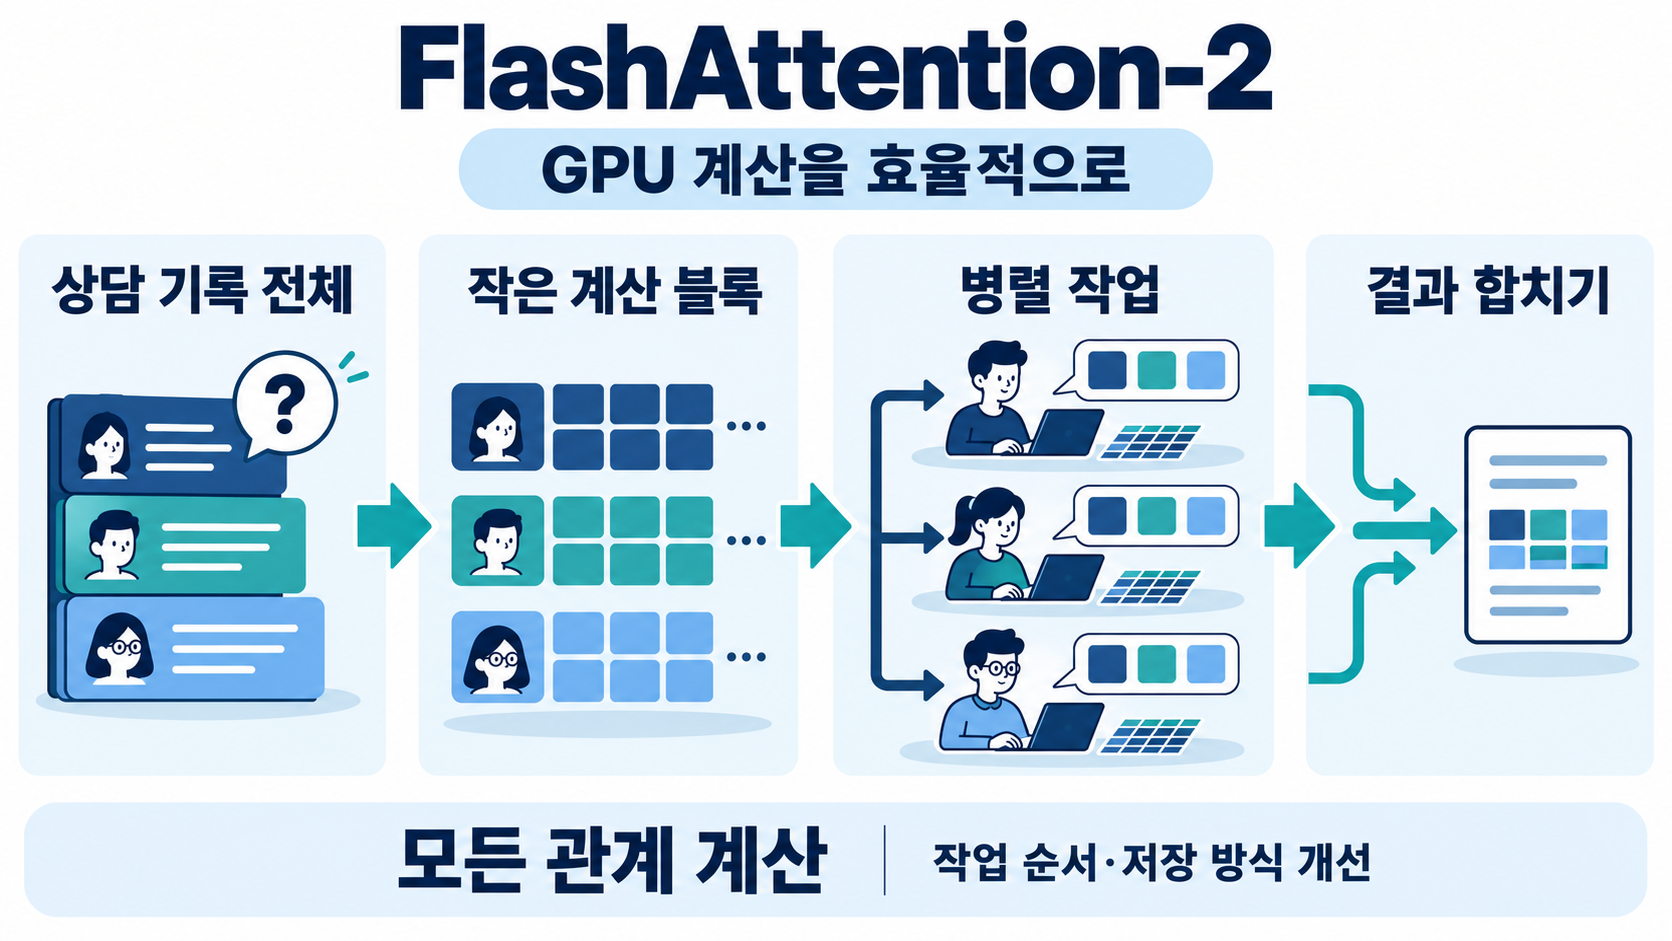
FlashAttention-2의 계산과 작업 분배를 설명하기 위한 자체 제작 개념 이미지
FlashAttention-2는 AI가 글 속 정보의 관계를 계산하는 어텐션을 GPU에서 더 효율적으로 실행하는 방법입니다. 큰 중간표를 메모리에 저장하는 부담을 줄이고, 여러 계산 작업을 나누는 방식을 개선합니다. 긴 고객상담 기록을 처리하는 가상 예시로 원리와 실험 결과, 개발 현장에서 살펴볼 차이를 정리해 드립니다.
분석 대상: Tri Dao의 FlashAttention-2 · 2023년 7월 17일 제출된 arXiv v1
1. 긴 글을 처리할 때 무엇이 부담일까요?
토큰은 AI가 글을 처리하기 위해 나눈 작은 단위입니다. 어텐션은 토큰 사이의 관계를 계산하고, 그 결과로 정보의 반영 비율을 정하는 과정입니다. 앞부분의 주문 정보와 뒤에 나온 변경 요청을 함께 이해하는 데 이런 계산이 쓰입니다.
일반적인 구현에서는 토큰 사이의 비교 점수와 반영 비율을 큰 표로 만들어 GPU 메모리에 저장합니다. 글이 길어지면 표도 빠르게 커지고, 계산 장치와 메모리 사이에서 값을 옮기는 부담이 늘어납니다. GPU는 많은 계산을 동시에 할 수 있지만, 필요한 값을 기다리는 시간이 길면 그 능력을 충분히 쓰기 어렵습니다.
2. 고객상담 메모로 이해해 보세요
“출고한 주문의 배송지를 바꿀 수 있나요?”라는 질문과 긴 상담 기록을 처리하는 상황을 가정해 보겠습니다. 담당자가 모든 메모 사이의 비교표를 큰 종이에 작성하기보다, 작은 작업 공간에서 메모 묶음별 계산을 하고 필요한 중간 요약값을 이어 갱신하는 모습을 떠올리시면 됩니다.
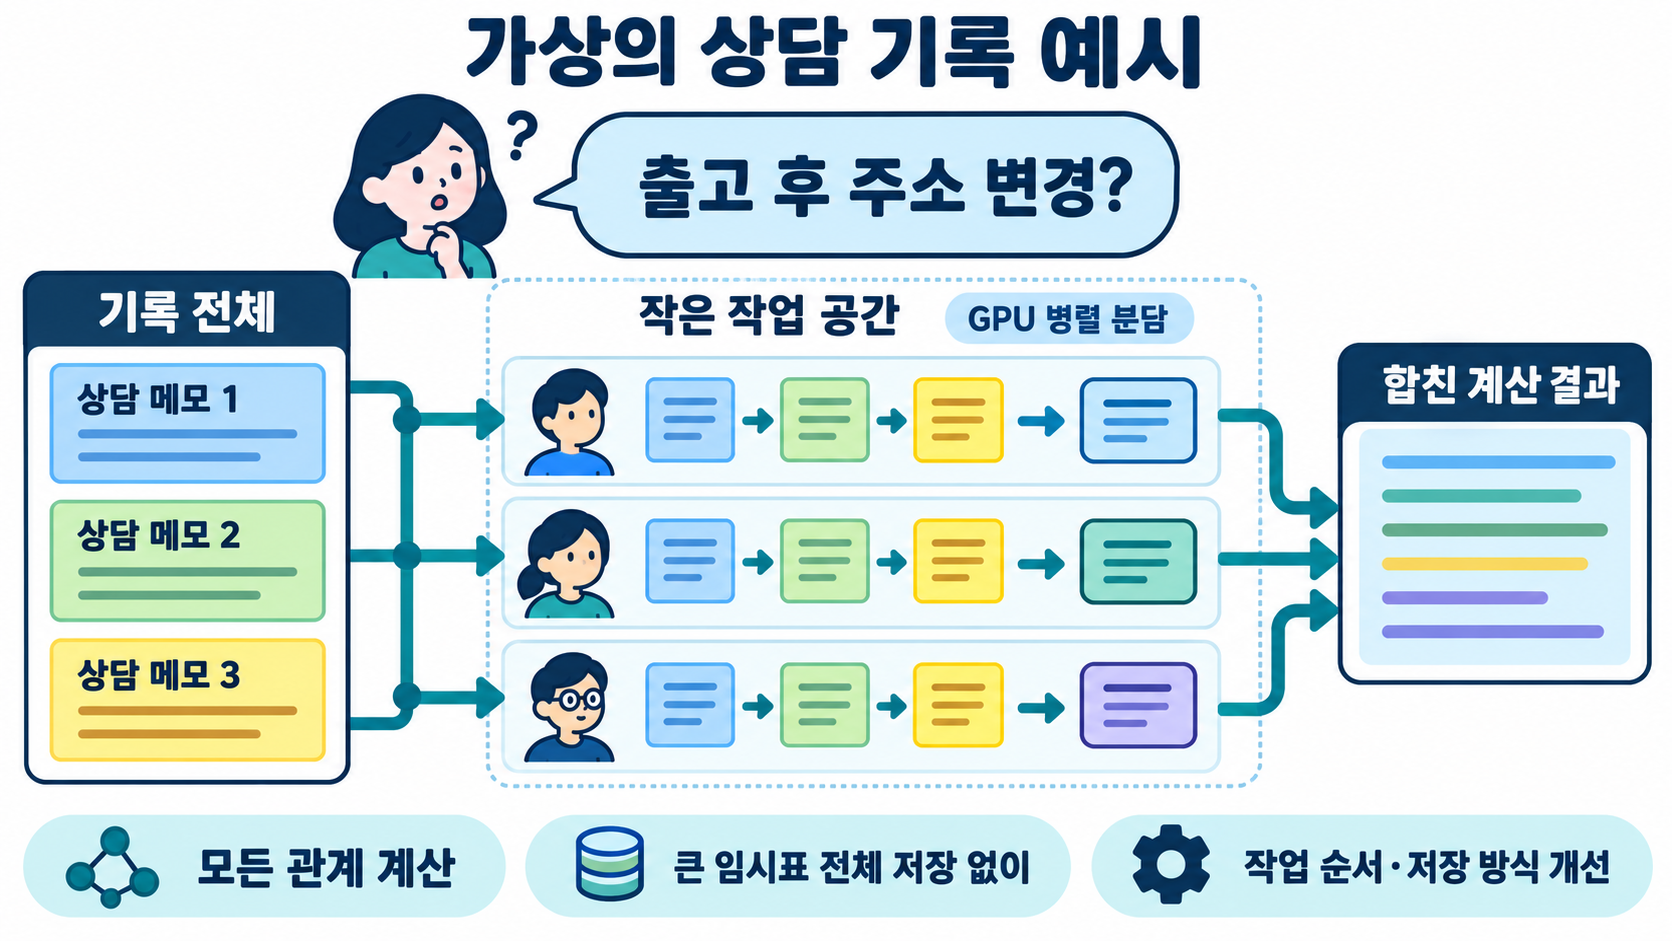
이해를 돕기 위한 가상 고객상담 예시입니다. 메모를 작은 계산 블록으로 나누고 중간 요약값을 갱신하는 모습을 나타냅니다. 실제 모델은 메모 문장에 표시한 사람의 판단 대신 숫자로 표현된 토큰을 계산합니다.
이런 블록 계산은 기존 FlashAttention에서 이어받은 원리입니다. 빠른 작업 공간에 입력의 일부를 가져와 계산하고, 큰 중간표 전체를 메모리에 남기지 않습니다. 블록마다 따로 얻은 비율을 그대로 더하면 전체 계산과 달라지므로, 앞선 요약값과 새 값을 함께 보정합니다. 이때 사용하는 소프트맥스는 점수를 전체 합이 1인 반영 비율로 바꾸는 계산입니다.
계산에 필요한 토큰 관계를 유지하면서 저장 방법과 처리 순서를 바꿉니다. 다만 컴퓨터의 숫자 표현과 연산 순서에 따른 작은 오차까지 없어진다는 뜻은 아닙니다. 공식 구현도 수치 허용오차 안에서 출력과 학습에 쓰는 기울기를 비교합니다.
3. FlashAttention-2가 개선한 세 가지
① 행렬곱 이외의 반복 계산을 줄입니다
행렬곱은 여러 숫자의 관계를 한꺼번에 계산하는 연산입니다. GPU에는 이를 빠르게 처리하는 전용 장치가 있습니다. FlashAttention-2는 비율을 보정하고 조건을 확인하는 등의 연산을 줄여, 행렬곱의 장점을 더 살립니다.
② 긴 입력도 여러 작업 단위로 나눕니다
여러 입력이나 여러 어텐션 헤드를 나누는 데 더해, 하나의 긴 입력도 토큰 위치 방향으로 나눠 병렬 처리합니다. 헤드는 서로 다른 관점의 관계 계산 단위라고 이해하시면 됩니다. 긴 입력 때문에 한 번에 처리할 입력 수가 적어져도 GPU의 여러 작업 단위가 함께 계산하도록 만드는 방식입니다.
③ 작업 그룹 사이의 중간값 교환을 줄입니다
순전파에서는 관계를 묻는 숫자 표현인 Q를 작업 그룹별로 나눕니다. 비교 대상인 K와 반영할 정보인 V는 함께 사용합니다. 각 그룹이 맡은 출력 부분을 계산하므로 중간값을 서로 모아 합치는 부담이 줄어듭니다. 자세한 설명은 저자가 작성한 Stanford CRFM 해설에서 보실 수 있습니다.
4. 약 2배라는 결과를 어떻게 읽을까요?
저자는 A100 80GB SXM4 GPU의 어텐션 연산 실험에서 기존 FlashAttention 대비 약 2배의 속도 개선을 보고했습니다. 입력 길이 512~약 1만 6천 토큰, 헤드 크기 64·128, 현재 토큰과 앞선 토큰만 보게 하는 인과 마스크 유무를 바꿔 비교했습니다. 전체 토큰 수는 논문 표기의 16k로 맞췄습니다.
한편 A100 80GB SXM4 8장으로 GPT 계열 모델을 학습한 별도 실험에서는 전체 학습 속도가 기존 FlashAttention 대비 최고 약 1.3배였습니다. 모델 크기 13억·27억 매개변수와 문맥 길이 약 2천·8천 토큰을 비교한 결과입니다. 어텐션만 빨라져도 모델의 다른 계산과 통신 시간은 함께 남기 때문입니다. 조건별 값은 논문 4절과 표 1에 나와 있습니다.
이 결과를 모든 GPU나 고객상담 서비스의 응답 속도로 그대로 옮기기는 어렵습니다. 또한 긴 입력의 관계 계산량 자체는 여전히 입력 길이의 제곱에 비례해 늘어납니다. 메모리를 효율적으로 쓴다는 사실만으로 더 긴 내용을 항상 정확하게 이해한다고 판단해서도 안 됩니다.
5. 개발 현장에서 정리할 기술적 차이
이 논문에서 배울 점은 모델 구조와 GPU 실행 방식을 함께 살펴보는 것입니다. 기업용 상담 AI를 개선한다면 동일한 모델·입력에서 GPU 종류, 입력 길이, 한 번에 처리하는 요청 수, 메모리 사용량, 실제 처리 시간을 함께 기록해 보세요. 긴 기록을 처음 읽는 단계와 답변을 한 토큰씩 이어 쓰는 단계도 나눠 측정해야 병목을 찾기 쉽습니다.
기술 자료에는 큰 중간표를 저장하던 방식이 어떻게 바뀌었는지, 작업을 어디에서 나눴는지, 중간값 교환이 얼마나 줄었는지를 흐름도와 비교 실험으로 정리하시면 좋습니다. 아이피렉스는 이런 구체적인 구성과 효과를 바탕으로 AI 기술의 차이를 검토합니다.