
Qué información debe conservar el modelo
Una conversación larga exige memoria, pero no todas las características merecen conservarse con igual intensidad. FiX modula la contribución de cada componente de un token anterior a la salida actual. Este artículo analiza una investigación; no presenta una patente concedida a IPLEX ni a sus clientes.
FiX: Introducing Fine-grained Forget Gate into Softmax Attention, de Runzhong Li, Renjie Liu, Qing Li y Bo Tang, figura en las actas de ICML 2026, PMLR 306, páginas 68619–68640, identificador pmlr-v306-li26dl. El congreso se celebró del 6 al 11 de julio de 2026. Las afiliaciones son Southern University of Science and Technology y The Hong Kong Polytechnic University; también consta una estancia de Renjie Liu en AlayaDB. La ficha oficial no recoge DOI ni identificador arXiv. El artículo y sus figuras se atribuyen a sus autores bajo licencia CC BY 4.0.
El límite de una compuerta escalar
La atención compara consultas Q y claves K para obtener pesos y combina los valores V correspondientes en la salida O. Decidir dónde prestar atención y qué información conservar son operaciones distintas. FoX introduce un olvido dependiente del contexto, pero aplica una misma tasa escalar de decaimiento a todas las características de un token dentro de cada cabeza.
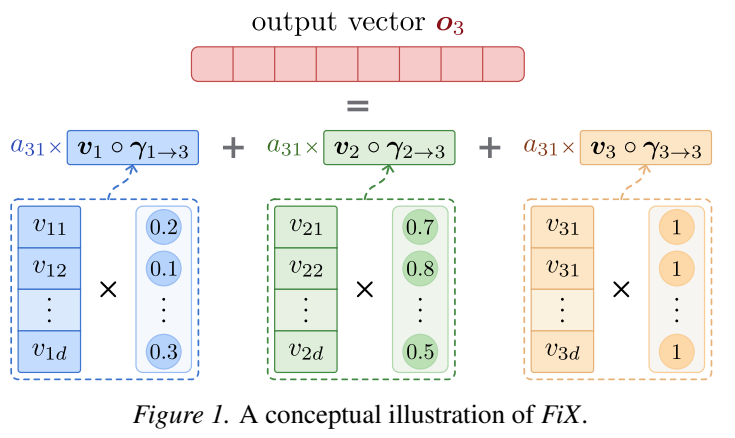
Una compuerta vectorial no puede sumarse directamente al producto escalar Q–K. FiX traslada el olvido a los valores: las compuertas acumuladas actúan componente a componente sobre V antes de combinar sus contribuciones. Así, unas características persisten y otras se atenúan. Los valores 0,2, 0,1 y 0,3 de la figura 1 son ilustrativos, no resultados de exactitud. Para el token actual, el producto acumulado vacío vale uno.
Funciones de RMSNorm y RoPE
La justificación matemática pasa por RMSNorm en la salida. En su forma ideal, un factor positivo común se cancela, permitiendo trasladar el olvido escalar desde las puntuaciones a la ruta valor–salida y después generalizarlo. La equivalencia es exacta con ε = 0; FiX utiliza ε = 10⁻³⁰ en esta normalización. Softmax sigue formando parte del cálculo: no se demuestra que cualquier transformador pueda prescindir de él.
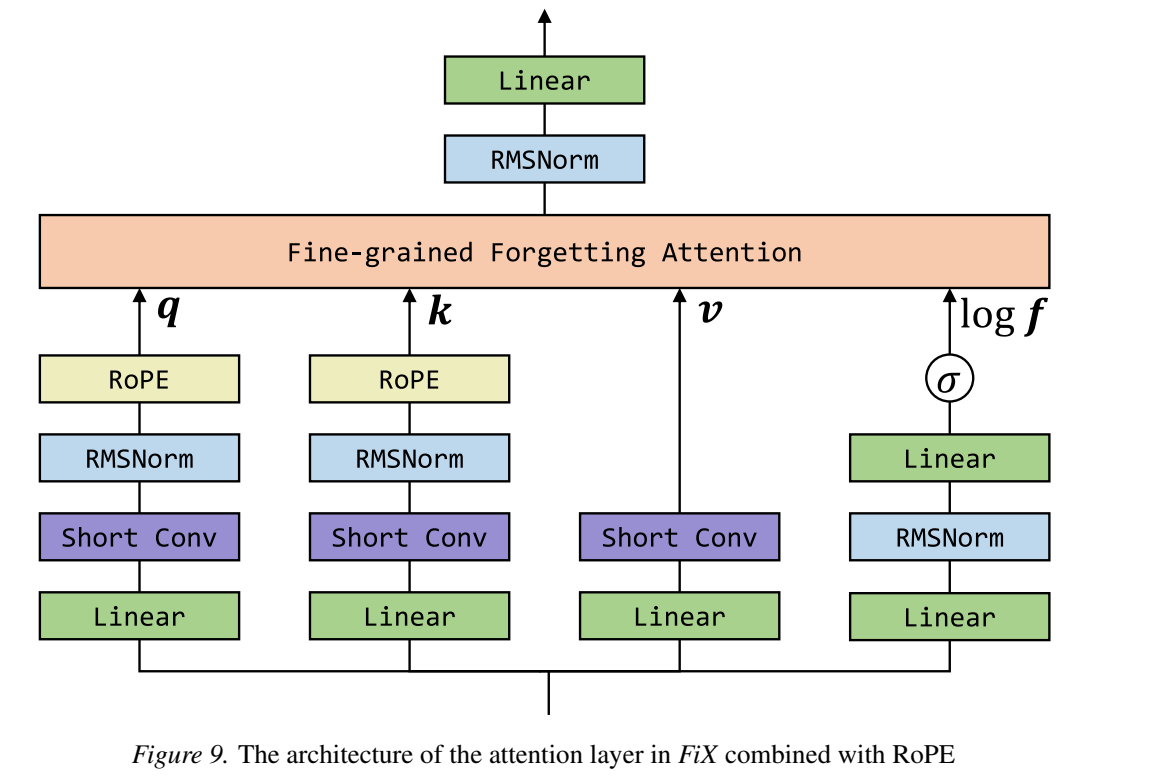
Cada capa obtiene Q, K, V y las compuertas de la entrada. La mayoría utiliza una proyección de bajo rango con dimensión intermedia 128 para contener los parámetros adicionales. RoPE, si se incorpora, actúa sobre Q y K; las compuertas acumuladas modulan V. Tras la combinación ponderada se aplican RMSNorm y una transformación lineal. FiX y RoPE pueden, por tanto, coexistir.
En la primera capa se emplean embeddings de compuerta aprendidos e indexados por el token, porque la proyección convencional generaba gradientes inestables. También se utiliza una activación de tipo Mamba. Sustituir el ε muy pequeño, esos embeddings o la activación elevó la pérdida de entrenamiento en las ablaciones.
Viabilidad numérica y computacional
Los productos de compuertas entre cero y uno pueden hacerse diminutos en secuencias largas. Dividir V directamente por ellos produce valores excesivos. Calcular cada posición por separado evita esa división, pero aprovecha peor la multiplicación matricial de la GPU.
Flash Fine-grained Attention combina reescalado respecto de puntos de referencia por bloques con la organización en bloques de FlashAttention. Los cocientes de compuertas acumuladas no superan uno; los bloques anteriores se procesan mayoritariamente mediante multiplicación matricial y los diagonales reciben tratamiento específico. Se fusionan además atención, RMSNorm y la capa lineal siguiente para mantener float32 en operaciones sensibles. Añadir una compuerta, por sí solo, no reproduce esta solución.
El equilibrio de memoria de Paged VF Cache
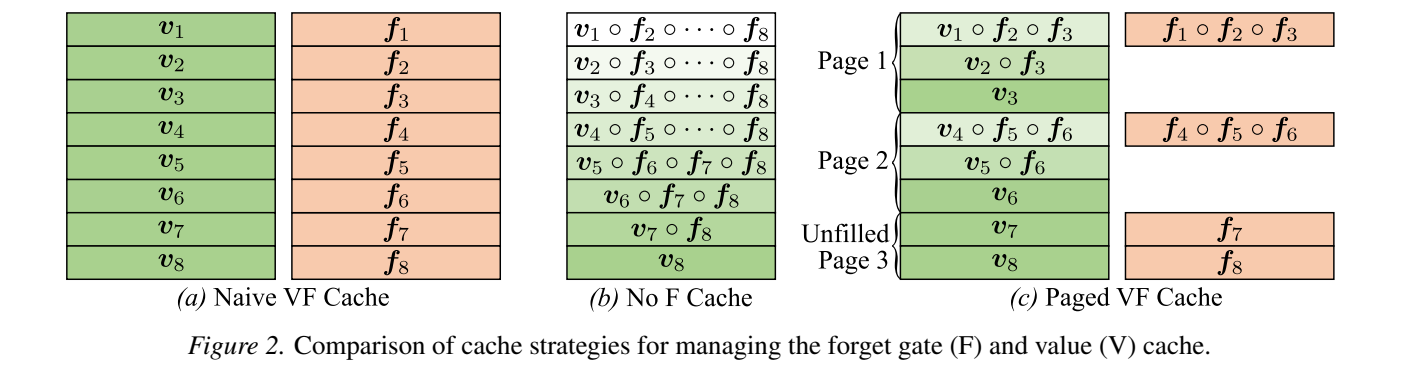
La atención autorregresiva habitual conserva K y V; FiX necesita también las compuertas F. Con las precisiones del artículo, guardar todas las F en float32 añade aproximadamente tanta memoria como la caché KV existente. Absorber F en V después de cada token evita almacenarlas aparte, pero obliga a releer y reescribir todos los valores anteriores, con coste de ancho de banda y errores de conversión acumulados.
Paged VF Cache agrupa los tokens en páginas. Al llenarse una, integra sus compuertas acumuladas en V, congela esos valores y conserva un producto representativo. En la página incompleta, valores y compuertas siguen separados. La figura 2 ilustra páginas de tres tokens; la configuración práctica comentada utiliza 16.
La memoria adicional de compuertas es aproximadamente 1/p de la caché KV estándar. Con p = 16, equivale a un 6,25% adicional respecto de KV; no supone reducir un 6,25% la memoria total de la GPU. La paginación evita asimismo actualizar todos los valores históricos en cada paso de decodificación.
Qué comparan los experimentos
Los modelos principales tienen unos 760 millones de parámetros y se entrenan con 48.000 millones de tokens de FineWeb-Edu. Las ablaciones emplean unos 340 millones de parámetros y 10.000 millones de tokens. Se comparan RoPE, FoX, FoX-RoPE, FiX y FiX-RoPE con una arquitectura común que incluye SwiGLU, QK-Norm, normalización de salida y Short-Conv.
Las proyecciones de compuerta añaden unos 8–10 millones de parámetros, además de los embeddings de la primera capa. FiX reduce la pérdida frente a RoPE, FoX y FoX-RoPE; FiX-RoPE la reduce aún más. Sin embargo, una pérdida de entrenamiento menor no determina el ganador de cada tarea posterior.
Mejoras moderadas y desiguales
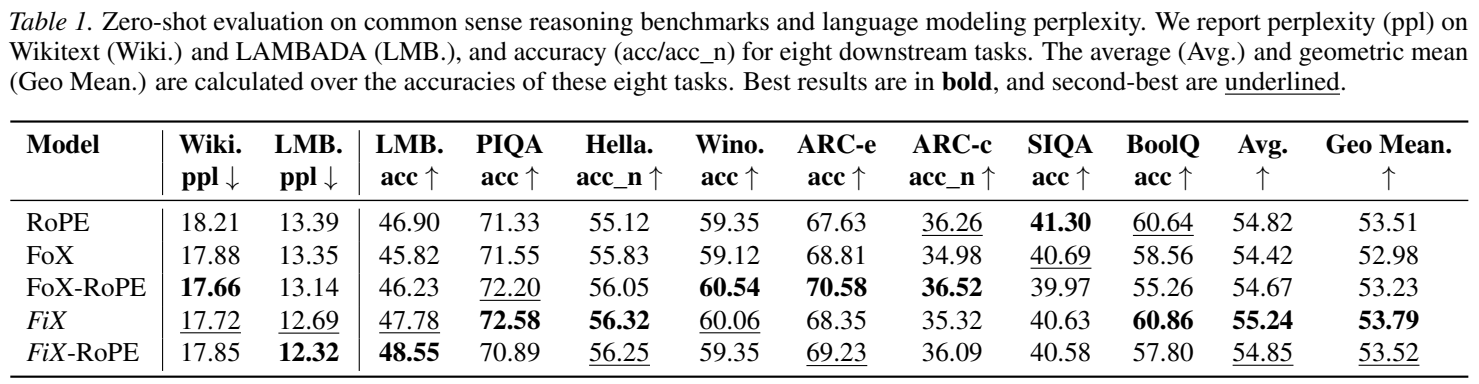
La media aritmética de ocho tareas de exactitud de la tabla 1 es 54,82% para RoPE, 54,42% para FoX, 54,67% para FoX-RoPE, 55,24% para FiX y 54,85% para FiX-RoPE. FiX supera a RoPE en 0,42 puntos porcentuales. Las dos métricas de perplejidad no integran esa media ni la media geométrica de exactitud.
FiX destaca en PIQA (72,58%), HellaSwag (56,32%) y BoolQ (60,86%). FoX-RoPE resulta mejor en ARC-easy, ARC-challenge y perplejidad de Wikitext. FiX-RoPE mejora LAMBADA, pero no la exactitud media. Son avances acotados a las condiciones ensayadas, no un salto general en todas las tareas.
Contextos largos y razonamiento no son lo mismo
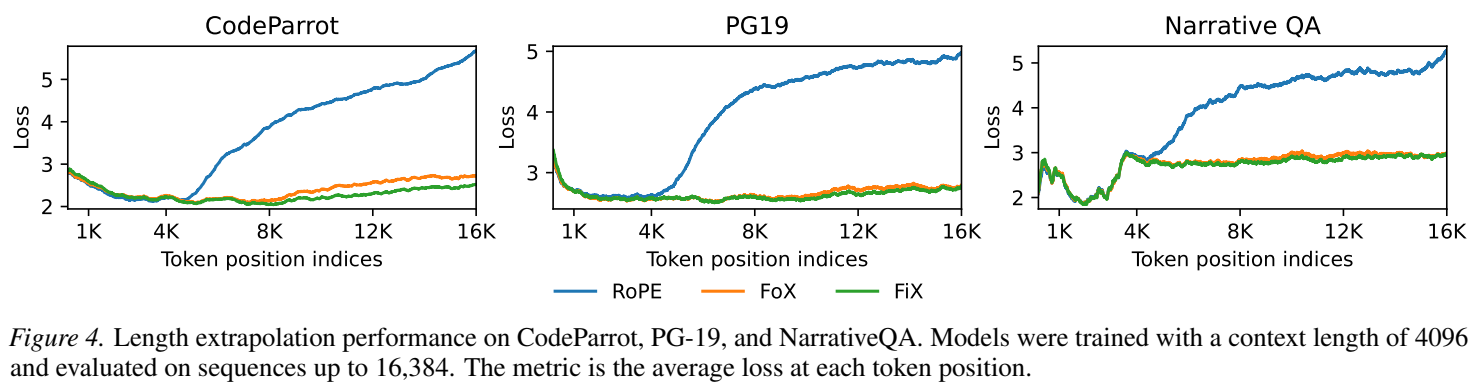
Tras entrenar con 4.096 tokens, se evalúa hasta 16.384, sin ajuste adicional, en CodeParrot, PG-19 y NarrativeQA. La pérdida predictiva del RoPE de referencia aumenta fuera de la longitud de entrenamiento; FoX y FiX son más estables, con cierta ventaja de FiX. No se comparan aquí las variantes combinadas con RoPE. El resultado no permite descalificar todos los modelos RoPE ni otras técnicas de ampliación de contexto.
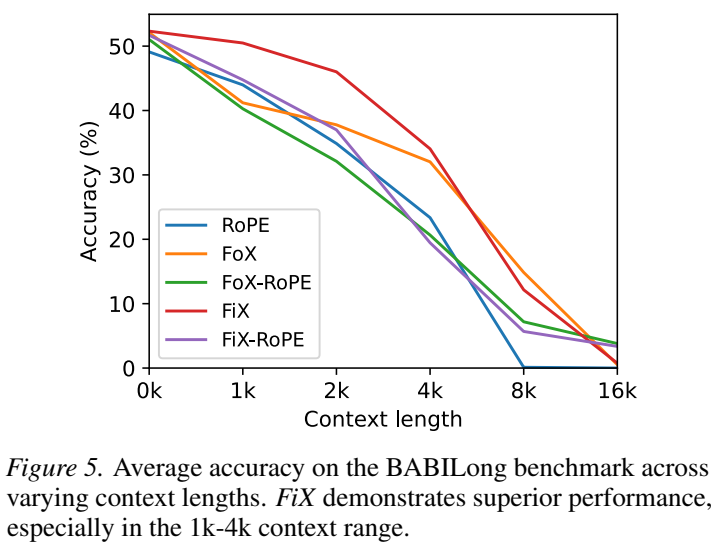
BABILong evalúa respuestas basadas en hechos dispersos por documentos largos. En cinco tareas, FiX es especialmente competitivo entre 1k y 4k tokens, pero también pierde mucha exactitud con 8k y 16k. Una predicción estable del siguiente token no equivale a razonar correctamente sobre documentos extensos.
Alcance, costes y análisis de patentes
FiX modifica la arquitectura y requiere entrenamiento; no se presenta como una opción activable sin más en un modelo ya desplegado. La atención sigue interactuando con tokens anteriores. Los bloques no convierten esas interacciones en tiempo lineal ni eliminan la caché KV. El cálculo de compuertas y la gestión de precisión tienen sus propios costes.
La evidencia principal procede de unos 760 millones de parámetros. Faltan comprobaciones específicas a mayor escala, con otros datos y sobre rendimiento o latencia en producción. Las pequeñas diferencias de la tabla principal no se acompañan de barras de error de repeticiones ni intervalos de confianza; no establecen una clasificación universal.
Desde la práctica de patentes interesa la combinación: compuertas acumuladas por característica en V–O, normalización con ε muy pequeño, embeddings iniciales, reescalado por bloques, fusión de operaciones sensibles y almacenamiento paginado. Importan la ubicación y granularidad de la compuerta y su relación con normalización y memoria, no su mera presencia. Los efectos medidos apoyan el análisis técnico, pero no determinan por sí solos novedad, actividad inventiva o patentabilidad.
La aportación de FiX
FiX concreta una retención selectiva por características sin abandonar la atención softmax. Su reformulación matemática se acompaña de una implementación y una caché que abordan los problemas que introduce. Los resultados prometedores a escala moderada deben valorarse junto con las limitaciones de contexto largo y la necesidad de verificar prestaciones y costes en modelos mayores.
Se conservan las indicaciones y formas originales; su contenido se explica en el texto.
Recursos relacionados: patentes de IA