
Какую информацию следует сохранять модели
Для длительного диалога необходима память, однако разные признаки не обязательно сохранять с одинаковой интенсивностью. FiX регулирует вклад отдельных компонентов прошлого токена в текущий выход. Это анализ исследования, а не сообщение о выдаче патента IPLEX или её клиентам.
Статья FiX: Introducing Fine-grained Forget Gate into Softmax Attention подготовлена Runzhong Li, Renjie Liu, Qing Li и Bo Tang и опубликована в трудах ICML 2026: PMLR, том 306, с. 68619–68640, идентификатор pmlr-v306-li26dl. Конференция прошла 6–11 июля 2026 года. Указаны Southern University of Science and Technology и The Hong Kong Polytechnic University, а также стажировка Renjie Liu в AlayaDB. В официальной записи нет DOI или номера arXiv. Статья и исследовательские иллюстрации принадлежат их авторам и используются на условиях CC BY 4.0.
Ограничение скалярного затвора
Механизм внимания сопоставляет запрос Q с ключами K, определяет веса и объединяет значения V в выход O. Выбор области внимания и выбор сохраняемой информации — разные операции. FoX вводит зависимое от контекста забывание, однако внутри одной головы все компоненты прошлого токена затухают с общей скалярной скоростью.
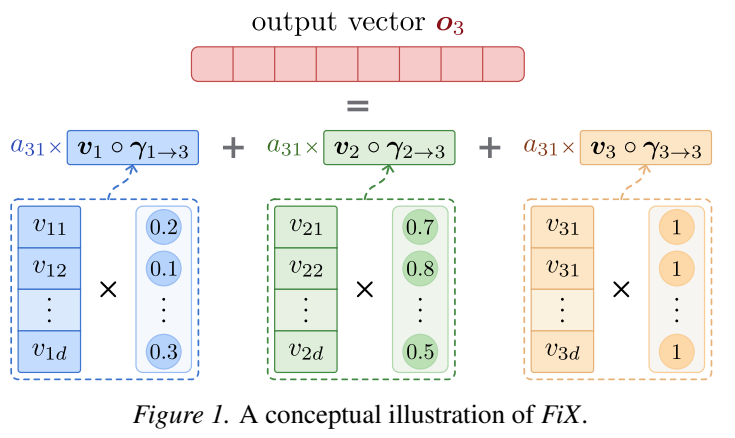
Векторный затвор нельзя непосредственно прибавить к скалярному произведению Q–K. Поэтому FiX переносит забывание на значения: накопленные затворы поэлементно изменяют V до объединения вкладов. Одни признаки токена могут сохраняться дольше других. Значения 0,2, 0,1 и 0,3 на рисунке 1 служат пояснением, а не показателями точности. Для текущего токена пустое накопленное произведение равно единице.
Роль RMSNorm и RoPE
Математическое обоснование опирается на выходную RMSNorm. В идеальном случае общий положительный масштабный множитель сокращается, позволяя перенести скалярное забывание из пути оценок в путь значения–выхода и затем перейти к отдельным признакам. Равенство строго при ε = 0; FiX использует ε = 10⁻³⁰. Softmax сохраняется в вычислениях: речь не идёт о возможности убрать его из любого трансформера.
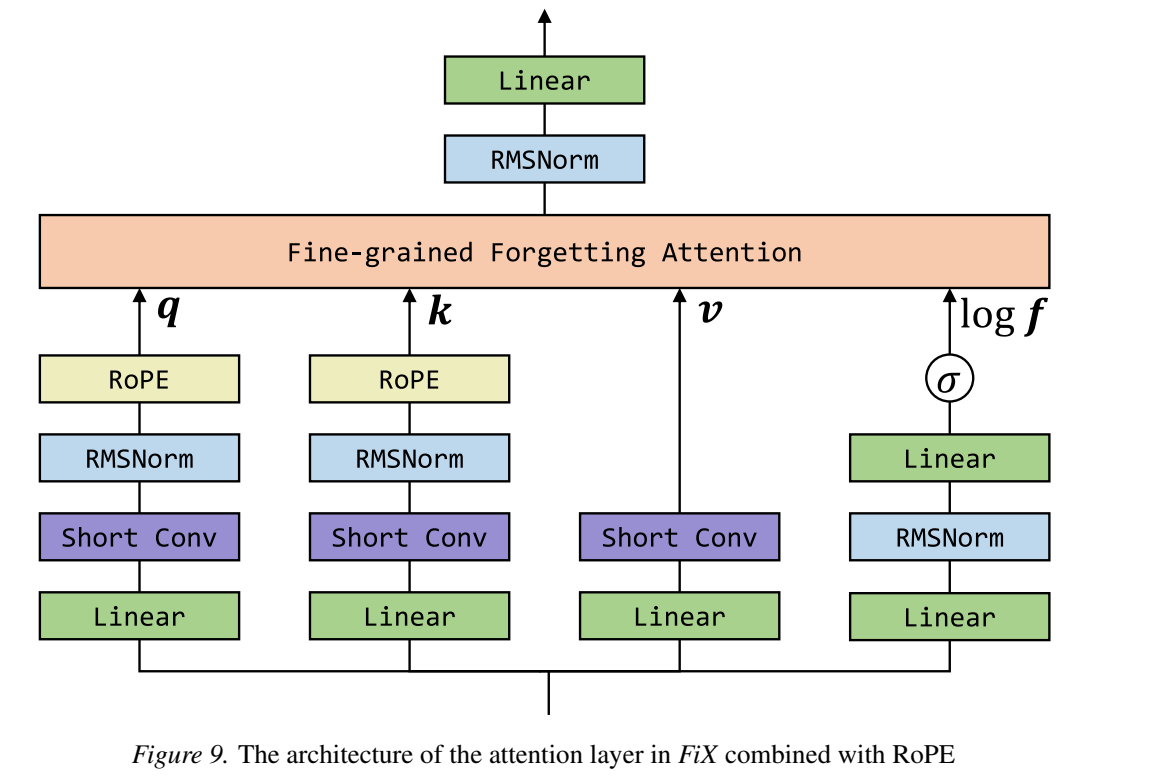
Слой формирует Q, K, V и затворы из входа. В большинстве слоёв используется проекция низкого ранга с промежуточной размерностью 128, ограничивающая прирост параметров. RoPE, если он включён, действует на Q и K, а накопленные затворы — на V. За взвешенным объединением следуют RMSNorm и линейное преобразование. Это позволяет сочетать FiX и RoPE.
В первом слое применяются обучаемые эмбеддинги затворов, выбираемые по идентификатору токена: обычная проекция давала неустойчивые градиенты. Авторы также используют активацию типа Mamba. Замена малого ε, первых эмбеддингов или этой активации в абляциях повышала потери относительно полной конструкции.
Устойчивость и эффективность вычислений
Произведения затворов между нулём и единицей на длинных последовательностях становятся очень малыми. Прямое деление V на них может давать чрезмерные значения. Расчёт каждой позиции отдельно устраняет такое деление, но хуже использует матричные операции GPU.
Flash Fine-grained Attention сочетает перемасштабирование относительно опорных точек блоков с блочной организацией FlashAttention. Отношения накопленных затворов не превышают единицу; большинство предыдущих блоков обрабатывается матрично, диагональные — отдельно. Внимание, RMSNorm и последующий линейный слой также объединяются, чтобы чувствительные операции сохраняли точность float32. Одно лишь добавление затвора не воспроизводит эту систему мер.
Компромисс памяти в Paged VF Cache
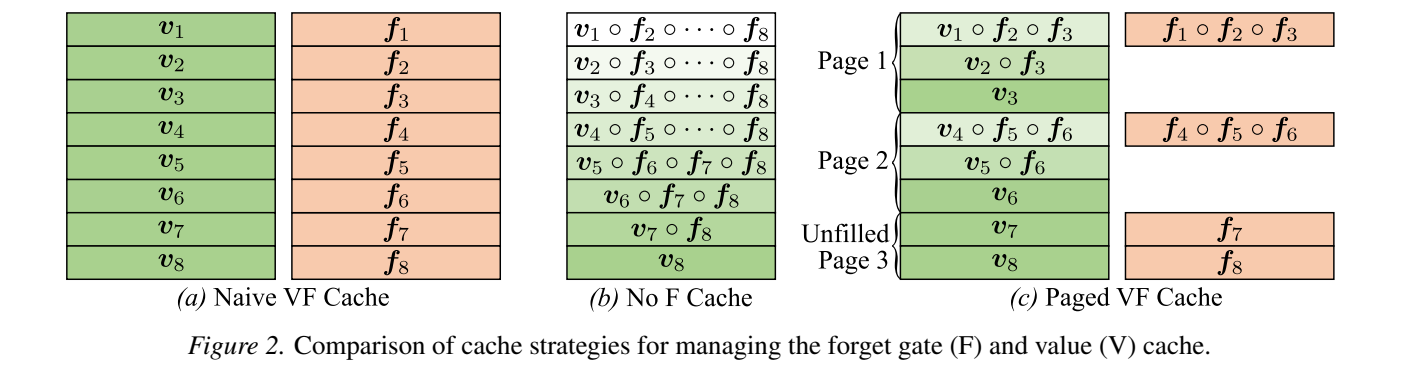
Обычное авторегрессионное внимание хранит прошлые K и V; FiX требуются ещё затворы F. При принятых в статье точностях хранение всех F в float32 добавляет примерно объём существующего KV-кэша. Поглощение F значениями V после каждого токена исключает отдельный кэш F, но заставляет постоянно читать и перезаписывать всю историю V, расходуя пропускную способность и накапливая ошибки преобразования.
Paged VF Cache объединяет токены в страницы. После заполнения страницы накопленные затворы включаются в V, значения фиксируются и сохраняется лишь представительное произведение затворов. В неполной странице V и F остаются раздельными. На рисунке 2 показаны страницы по три токена, а обсуждаемая практическая настройка — 16.
Дополнительная память затворов составляет примерно 1/p стандартного KV-кэша. При p = 16 это около 6,25% сверх объёма KV, а не сокращение общей памяти GPU на 6,25%. Страничная организация также избавляет от обновления всех прошлых значений на каждом шаге декодирования.
Условия экспериментального сравнения
Основные модели содержат около 760 млн параметров и обучены на 48 млрд токенов FineWeb-Edu. Для абляций используются около 340 млн параметров и 10 млрд токенов. Сравниваются RoPE, FoX, FoX-RoPE, FiX и FiX-RoPE на общей архитектурной основе: SwiGLU, QK-Norm, нормализация выхода и Short-Conv.
Низкоранговые проекции добавляют примерно 8–10 млн параметров сверх эмбеддингов первого слоя. FiX показывает меньшие потери обучения, чем RoPE, FoX и FoX-RoPE; FiX-RoPE снижает их ещё сильнее. Но минимум потерь обучения не определяет победителя в каждой прикладной задаче.
Улучшение точности невелико и неоднородно
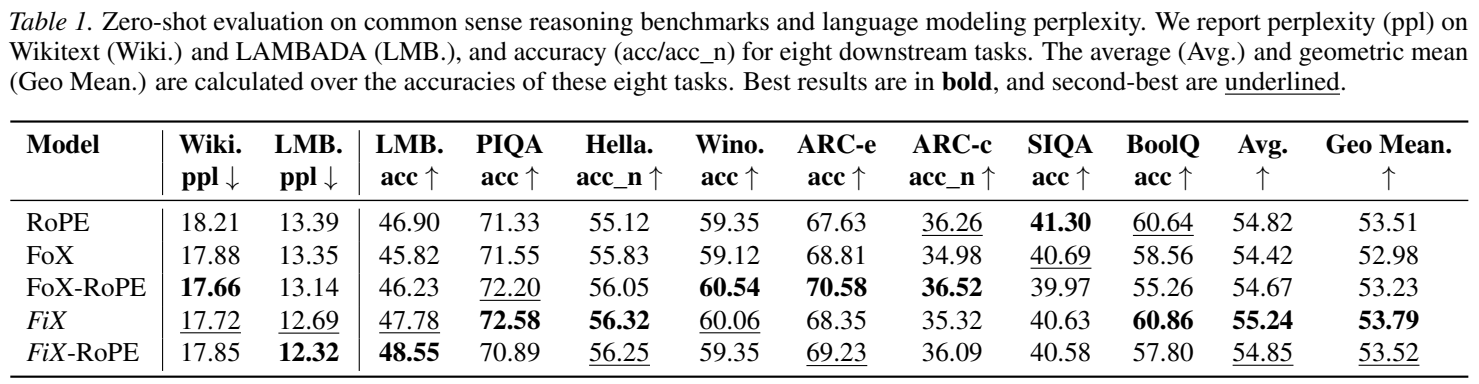
Средняя арифметическая точность по восьми задачам в таблице 1 составляет 54,82% для RoPE, 54,42% для FoX, 54,67% для FoX-RoPE, 55,24% для FiX и 54,85% для FiX-RoPE. Превышение FiX над RoPE — 0,42 процентного пункта. Два результата по перплексии не входят ни в это среднее, ни в геометрическое среднее точности.
FiX лидирует в PIQA (72,58%), HellaSwag (56,32%) и BoolQ (60,86%). FoX-RoPE лучше в ARC-easy, ARC-challenge и по перплексии Wikitext. FiX-RoPE выигрывает в LAMBADA, но не по средней точности. Это умеренное улучшение в заданных условиях, а не качественный скачок во всех задачах.
Длинный контекст не решает автоматически задачи рассуждения
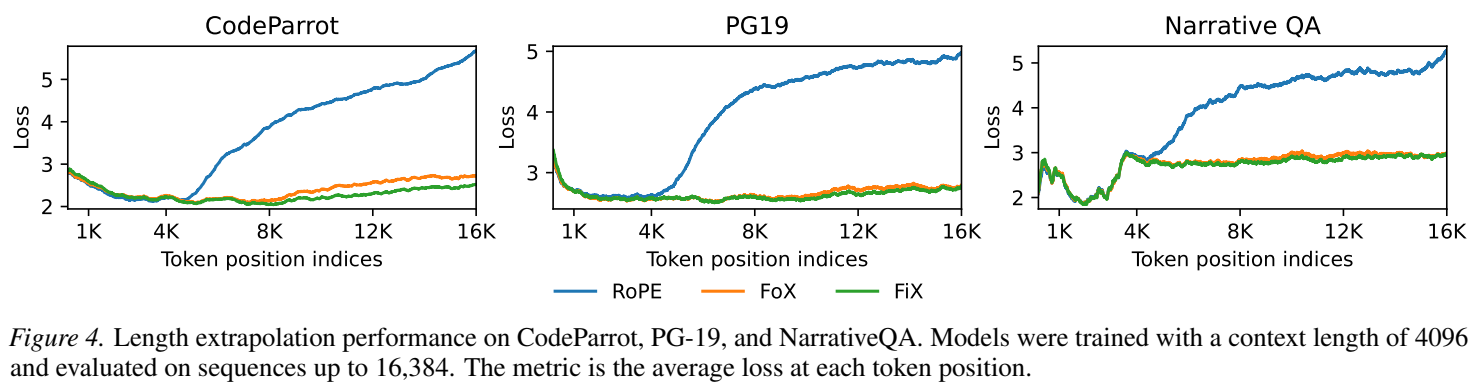
После обучения на длине 4096 токенов модели без дополнительной настройки проверялись до 16384 токенов на CodeParrot, PG-19 и NarrativeQA. За пределами обучающей длины потери эталонного RoPE росли; FoX и FiX были устойчивее, с некоторым преимуществом FiX. Сочетания с RoPE в этом эксперименте не сравнивались. Вывод нельзя распространять на все модели RoPE или другие методы расширения контекста.
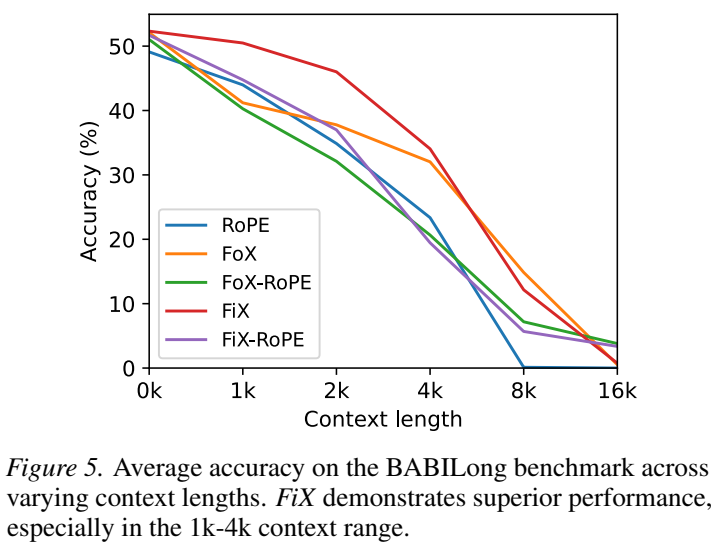
BABILong проверяет ответы на вопросы по фактам, распределённым в длинных документах. На пяти задачах FiX особенно конкурентоспособен при 1k–4k токенов, но его точность также заметно падает при 8k и 16k. Устойчивое предсказание следующего токена и успешное рассуждение по длинному документу — не одно и то же.
Границы применения, затраты и патентный анализ
FiX меняет архитектуру и требует обучения. Это не описывается как настройка, которую можно просто включить в готовой модели. Внимание продолжает взаимодействовать с историей токенов; блоки не делают сложность линейной и не отменяют KV-кэш. Затворы и управление точностью тоже требуют ресурсов.
Основные данные получены при масштабе около 760 млн параметров. Более крупные модели, другие данные, производительность и задержка в эксплуатации нуждаются в отдельной проверке. Небольшие различия основной таблицы не сопровождаются интервалами доверия или погрешностями повторных запусков и не задают универсальный рейтинг.
Для патентного анализа важна совокупность: накопленные затворы по признакам в V–O, нормализация с очень малым ε, начальные эмбеддинги, блочное перемасштабирование, объединение чувствительных операций и страничное хранение. Существенны положение и детализация затвора, его связь с нормализацией и памятью, а не само наличие. Экспериментальные эффекты помогают техническому анализу, но сами по себе не устанавливают новизну, изобретательский уровень или патентоспособность.
Что даёт FiX
FiX предлагает конкретный механизм избирательного сохранения признаков при сохранении softmax-внимания. Математическая переработка сопровождается реализацией и кэшем, учитывающими возникающие проблемы. Обнадёживающие результаты умеренного масштаба следует оценивать вместе с ограничениями длинного контекста и необходимостью проверить эффективность и затраты на более крупных моделях.
Сохранены исходные обозначения и формы иллюстраций; их содержание поясняется в тексте.
Связанные материалы: патенты на ИИ