
El trabajo y su objetivo
Se analiza DFlare: Scaling Up Draft Capacity for Block Diffusion Speculative Decoding, de Jiebin Zhang y colaboradores, arXiv:2606.02091v2, de 2 de junio de 2026, cuya primera versión es del 1 de junio. El preprint del equipo de la Universidad de Pekín y Tencent se distribuye bajo CC BY 4.0. Estudia la aceleración de inferencia, sin afirmar que ampliar el borrador mejore automáticamente la calidad de las respuestas.
Proponer en paralelo y aceptar con el modelo objetivo
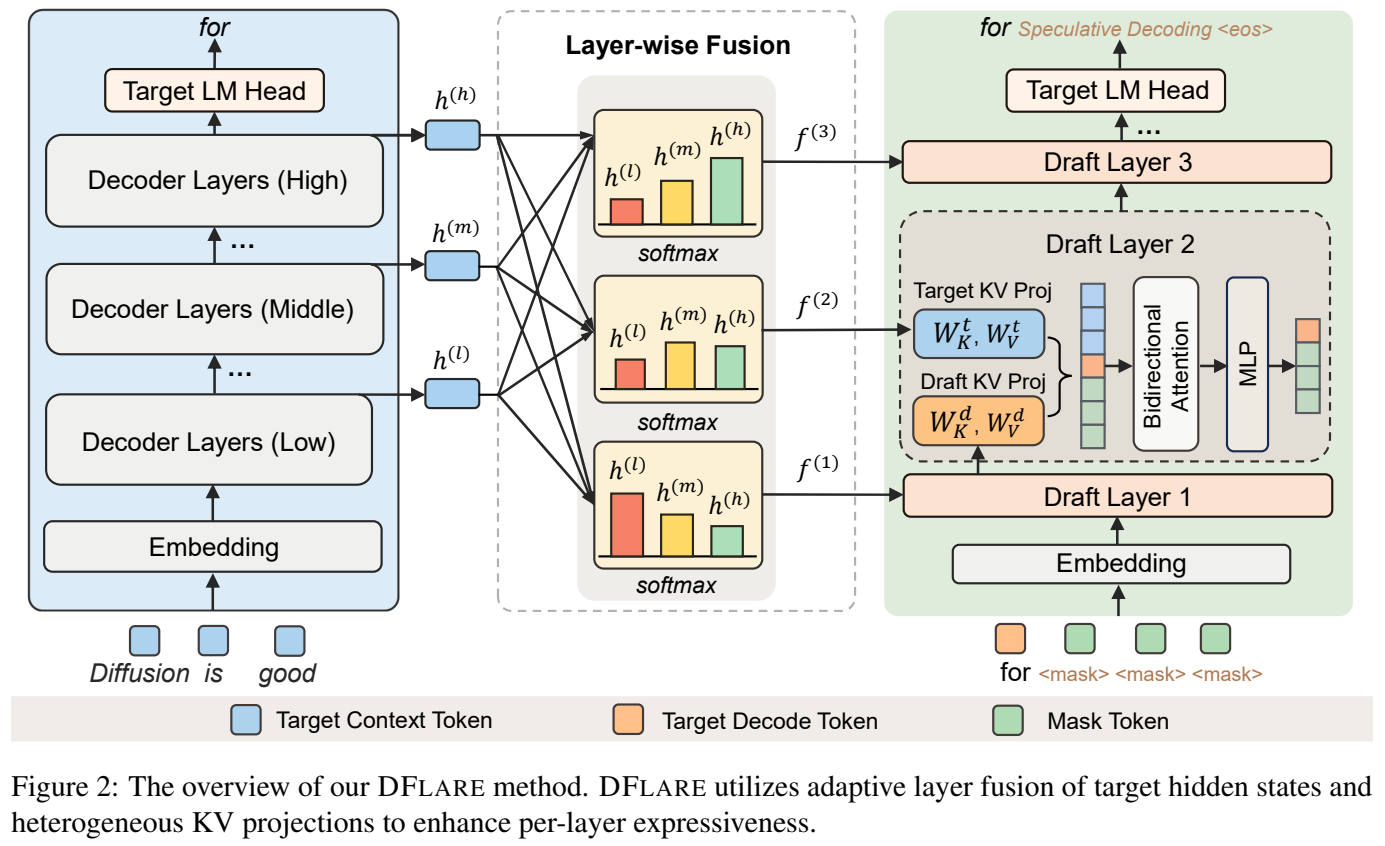
El borrador de difusión por bloques predice posiciones enmascaradas en una sola pasada, con atención bidireccional dentro del bloque. El modelo objetivo comprueba la propuesta. En decodificación voraz acepta el prefijo hasta la primera discrepancia y aporta el siguiente token. El muestreo estocástico exige un procedimiento de aceptación adecuado para conservar la distribución objetivo. Un bloque largo o una respuesta verosímil no prueban por sí solos aceleración ni equivalencia.
Una mezcla distinta para cada capa
DFlash utiliza una representación común fusionada mediante una capa totalmente conectada. DFlare permite que cada capa del borrador aprenda una mezcla de estados ocultos de varias capas objetivo, normalizada con softmax y seguida de RMSNorm. Siete capas que consultan nueve capas objetivo requieren 63 coeficientes escalares de mezcla, no 63 parámetros adicionales en total. Guardar los coeficientes no elimina el cálculo de las representaciones ponderadas dependientes de la entrada.
Proyecciones según el origen
Las características del contexto objetivo y las del token inicial y las posiciones enmascaradas pertenecen a espacios de representación distintos. Se aplican proyecciones de claves y valores separadas a ambas fuentes; las consultas proceden del borrador. La aportación debe explicarse por la interacción entre selección de información por capa y transformación por origen, no solo por la profundidad.
Estabilizar el prefijo antes de reforzar la cola
El entrenamiento usa varias posiciones de anclaje y atención restringida, con embeddings y cabeza del modelo de lenguaje compartidos y congelados. La pérdida ponderada por posición prioriza inicialmente los primeros tokens, pues un rechazo temprano descarta los posteriores, y aumenta después el peso de posiciones lejanas. El apéndice fija γ inicial en 4,5 y lo incrementa en uno por época; GPT-OSS-20B mantiene γ=4 por su bloque de ocho. La descripción general del calendario debe distinguirse de estos ajustes de implementación.
Condiciones y volumen de datos
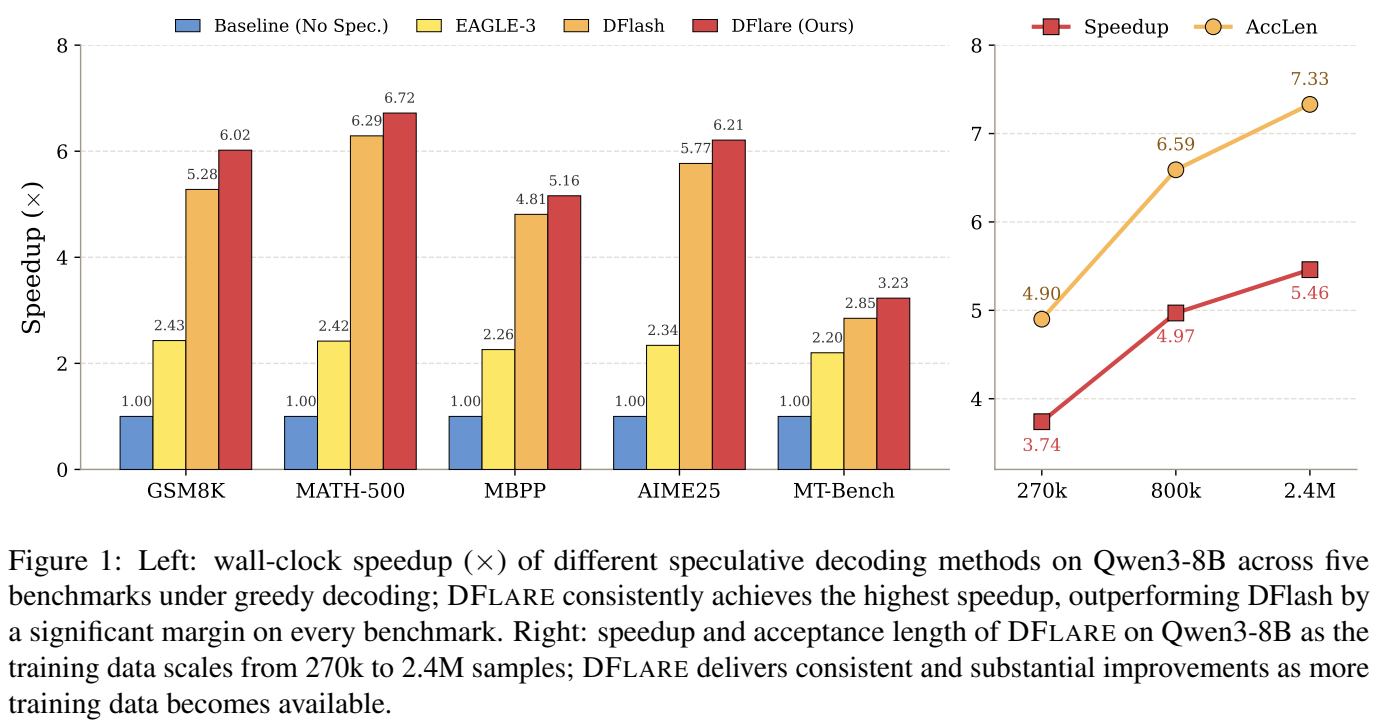
Se evaluaron Qwen3-4B, Qwen3-8B y GPT-OSS-20B, principalmente en NVIDIA H20, frente a decodificación autorregresiva, EAGLE3 y DFlash. Las seis tareas fueron GSM8K, MATH500, AIME25, HumanEval, MBPP y MT-Bench. Qwen utilizó siete capas de borrador, bloques de 16 y nueve capas objetivo; GPT-OSS, ocho, ocho y siete. Los 2,4 millones de ejemplos procedían de Nemotron Post-Training Dataset V2, CodeAlpaca y Step3.5-Flash-SFT, entre otros. Se conservaron las instrucciones y se regeneraron las respuestas con cada objetivo. Se entrenó durante seis épocas, con límite de 3.072 tokens, eliminando coincidencias de al menos 32-gramas con las pruebas. Para Qwen3-8B, 270.000, 800.000 y 2,4 millones de ejemplos dieron aceleraciones medias de 3,74, 4,97 y 5,46, y longitudes aceptadas de 4,90, 6,59 y 7,33. Los resultados principales combinan cambios de arquitectura y datos.
Medias y excepciones
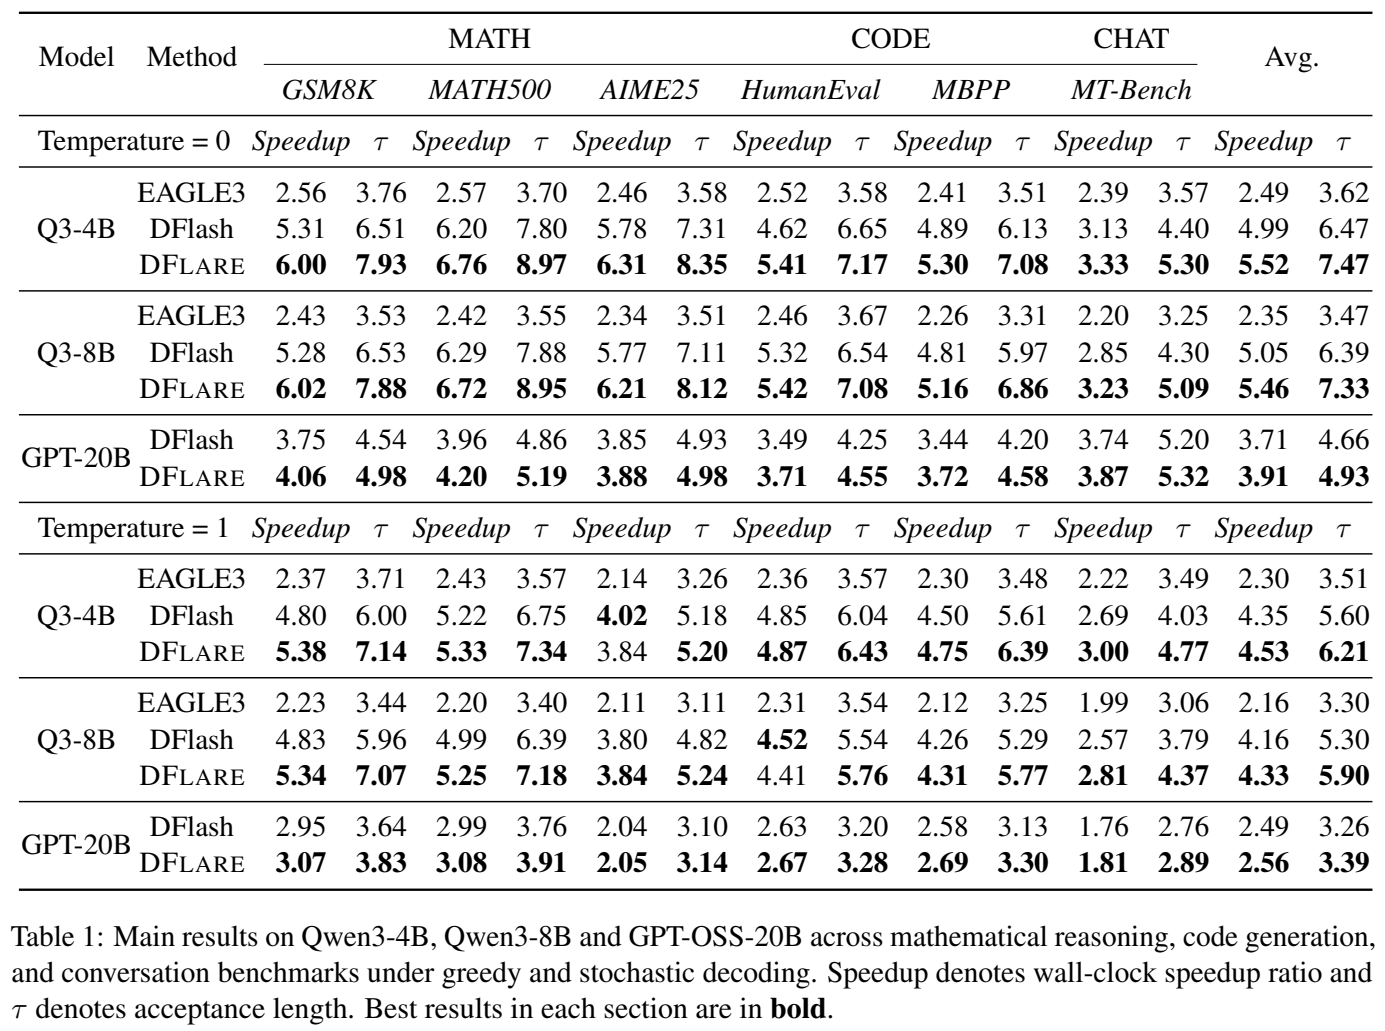
A temperatura cero, las aceleraciones medias DFlash→DFlare frente a la base autorregresiva fueron 4,99→5,52 en Qwen3-4B, 5,05→5,46 en 8B y 3,71→3,91 en GPT-OSS: mejoras relativas aproximadas del 10,6%, 8,1% y 5,4%. Las longitudes aceptadas pasaron de 6,47→7,47, 6,39→7,33 y 4,66→4,93. A temperatura uno mejoraron las medias, pero AIME25 en 4B descendió de 4,02 a 3,84 y HumanEval en 8B de 4,52 a 4,41. No existe superioridad uniforme.
Qué respaldan las ablaciones
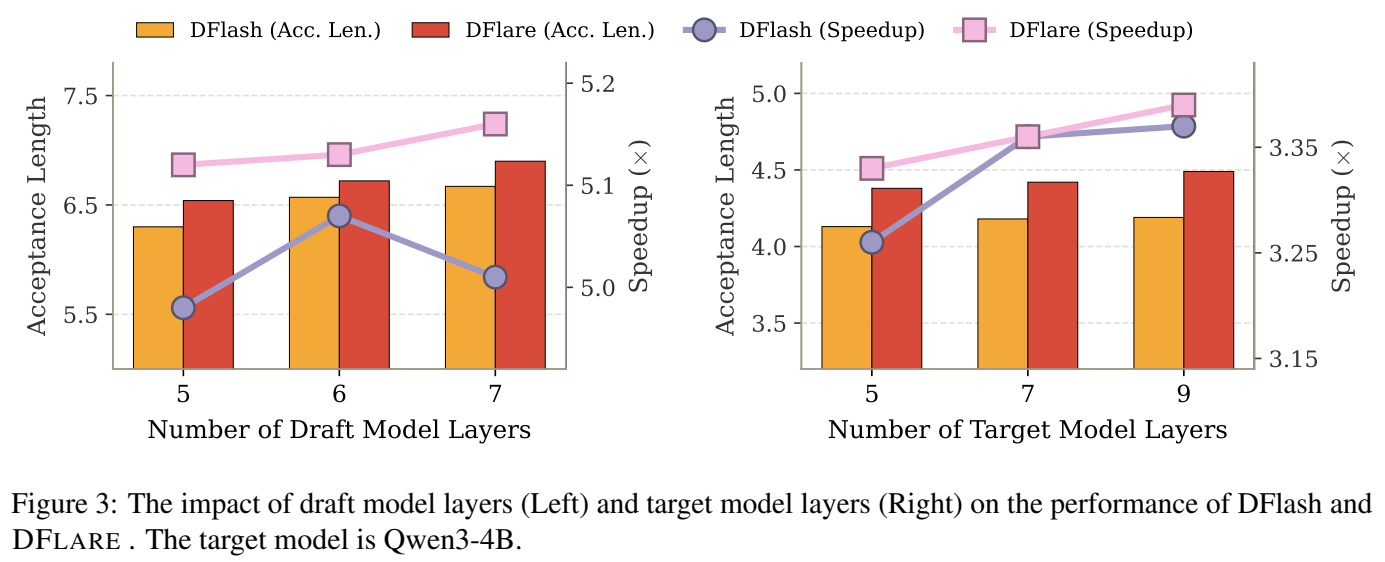
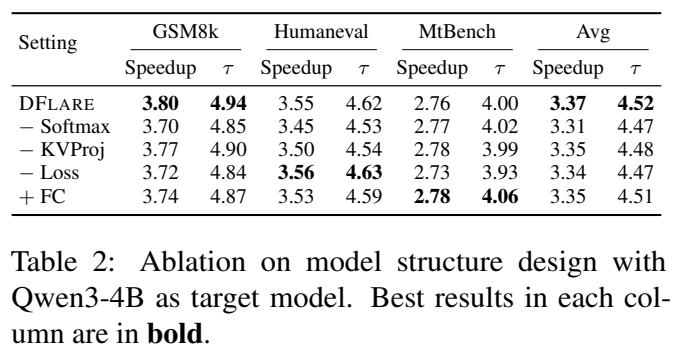
Con los mismos datos de DFlash, cinco, seis y siete capas de DFlare alcanzaron aceleraciones medias de 5,12, 5,13 y 5,16, frente a 4,98, 5,07 y 5,01 de DFlash; las longitudes aceptadas fueron 6,55, 6,72 y 6,90. El ensayo no prueba escalado ilimitado. Otra ablación de tres tareas obtuvo 3,37/4,52 en aceleración/aceptación para el modelo completo; sin softmax, separación KV o pérdida progresiva, 3,31/4,47, 3,35/4,48 y 3,34/4,47. Añadir una capa totalmente conectada dio aceptación 4,51. Son diferencias pequeñas, sin información de variabilidad que permita exagerar su alcance.
Servicio y coste de entrenamiento
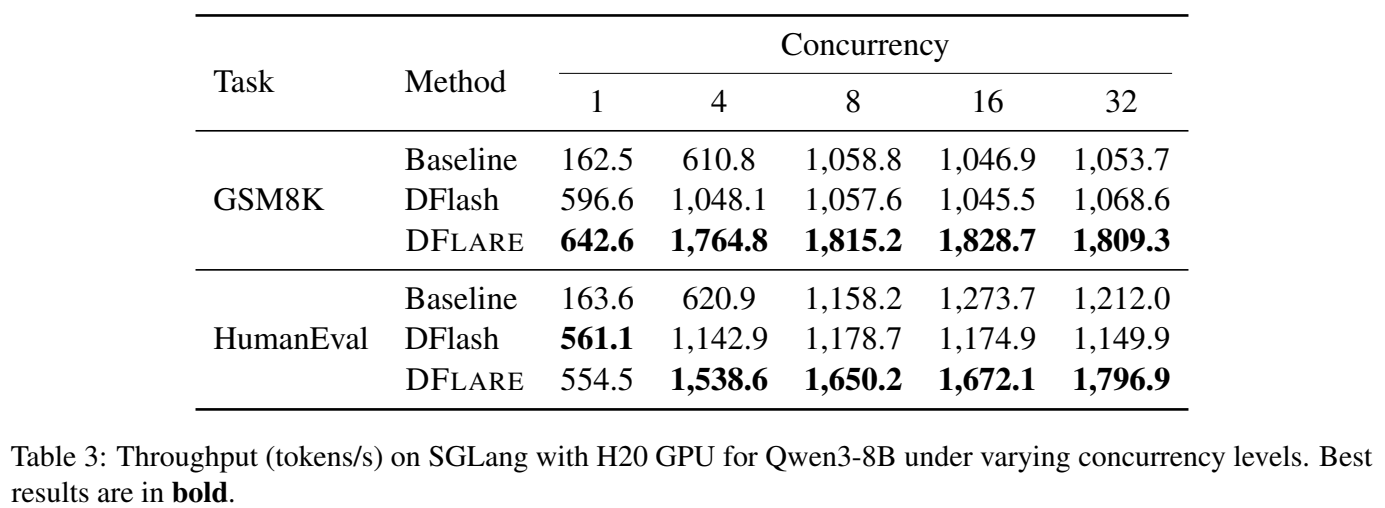
En SGLang, Qwen3-8B sobre H20 y concurrencia 32, GSM8K alcanzó 1.053,7 tokens/s con la base, 1.068,6 con DFlash y 1.809,3 con DFlare; HumanEval obtuvo 1.212,0, 1.149,9 y 1.796,9. Con concurrencia uno, HumanEval dio 554,5 para DFlare frente a 561,1 para DFlash. Entrenar 8B exigió unas 160 horas por dispositivo en 32 GPU: unas 5.120 horas-GPU, no 160 en total. El trabajo no calcula el punto de amortización y no ensaya escalas mayores de datos por sus restricciones de recursos.
Lectura desde la práctica de patentes
La divulgación técnica debe relacionar el cuello de botella con la mezcla, las proyecciones y la pérdida concretas, y con los efectos observados bajo condiciones explícitas. Se necesita acceso a estados ocultos internos; no cabe presumir compatibilidad con cualquier API cerrada. Conviene separar arquitectura, datos y configuración de servicio al explicar los resultados. Este análisis no determina novedad, actividad inventiva ni elegibilidad para patente.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Servicio relacionado: patentes de IA
Artículo y figuras: Zhang y colaboradores, DFlare v2, 2026 (CC BY 4.0) · CC BY 4.0