본 포스팅에서는 2018년도 CVPR Oral section에 게재되었던 StarGAN 논문(StarGAN: Unified Generative Adversarial Networks for Multi-Domain Image-to-Image Translation)을 분석 내용에 대해 설명하고자 한다.
본 논문에서는 다중 도메인 상황에서 translation이 가능하게 해주는 StarGAN 네트워크를 제안했다.
이미지를 클릭하면 논문 전문을 확인할 수 있다.
[내용 요약]
CycleGAN, IcGAN 등 StarGAN이 아닌 다른 네트워크는 특정 도메인에서 다른 도메인으로 도메인 translation을 수행하려면, 여러 네트워크를 중첩해서 사용해야 한다. 아래 예시를 보면 알 수 있듯이 성능이 좋지 않다.
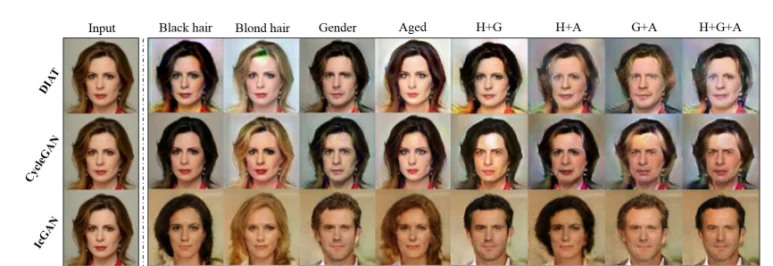
하지만 StarGAN은 오직 하나의 네트워크만 이용해서 한번에 여러 개의 attribute를 한꺼번에 바꾸도록 하여 다른 도메인으로 translation할 수 있다.
Input 이미지 (클래스가 1) 나이 어림, 2) 갈색 머리, 3) 여자로 분류되어 있음)를 StarGAN에 입력해서 다른 도메인 이미지로 translation 해준 결과를 보면 다른 네트워크보다 도메인 translation을 잘 수행하는 것을 확인할 수 있다.
좀더 쉽게 설명 하자면, StarGAN은 입력된 젊은 금발 여성 이미지(INPUT)를 늙은 흑발 남성 이미지로 잘 변환해주는 것을 볼 수 있다. (H+G+A)
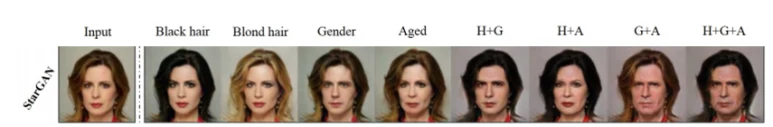
StarGAN 예시
[배경 기술 설명]
생성 모델(Generative Models)
생성 모델은 실존하지는 않지만 있을 법한 이미지를 생성하는 모델을 의미한다. 생성 모델이 만들 수 있는 데이터는 이미지 뿐만 아니라 다양한 데이터(ex. 텍스트 데이터 등)가 될 수 있다. 다만, 다른 데이터 보다 이미지 데이터를 생성하는 생성 모델에 대한 연구가 가장 활성화되고 있다.
Discriminative 모델과 Generative 모델을 분류하면 다음과 같다.
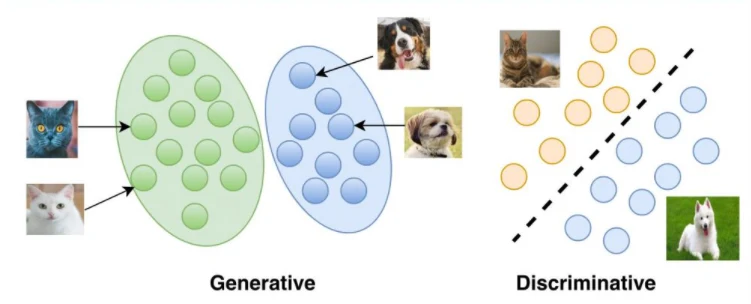
Generative Model과 Discriminative Model 분류
Discriminative model은 기존에 존재하는 데이터 사이의 decision boundary를 학습해서 하나의 데이터가 들어왔을 때 데이터가 어떤 클래스인지 분류하는 동작을 한다.
한편, Generative model은 기존에 존재하는 데이터로부터 distribution을 학습해서, 학습된 distribution을 따르는 즉, real data distribution 을 따르는 데이터(실제로 있을 법한 데이터)를 출력해주는 모델이다(Generative model은 joint probability distribution을 학습한다고 볼 수 있음).
예를 들어, 코의 크기와 관련된 피처와 눈의 크기와 관련된 피처가 존재한다고 가정해보자. 사람 이미지를 학습한다고 하면 일반적인 코의 크기와 일반적인 눈의 크기가 정해져 있을 것이다. 일반적인 코의 크기가 10cm라고 가정하면, 코의 크기가 10cm에 대한 확률 값이 가장 높게 나올 것이다. 일반적인 눈의 크기가 3cm라고 가정하면, 눈의 크기가 3cm에 대한 확률 값이 가장 높게 나올 것이다. 따라서, 각각의 피처에서 확률 값이 가장 큰 피처 값들(코의 크기 10cm, 눈의 크기 3cm)을 사용해서 이미지를 생성하면 진짜 사람을 촬영한 것 같은 이미지가 생성될 수 있다.
결과적으로, 생성 모델은 기존에 존재하는 학습 데이터들이 가지고 있는 real distribution 즉, 고유한 분포들을 학습하게 된다.
생성 모델을 학습시킬 때 가장 많이 사용되는 architecture는 Generative Adversarial Networks (GAN)이다.
GAN: Generative Adversarial Networks
GAN에 대해 이전 포스팅에서는 예시를 들어 쉽게 설명했었는데 이번에는 보다 상세하게 설명해보겠다. [GAN 포스팅 바로가기]
GAN은 Generator와 Discriminator 두 개의 네트워크를 활용한 것이다. GAN을 통해 Generator의 학습이 완료된 경우, Generator에 하나의 노이즈를 입력해서 있을 법한 이미지가 나오도록 만들 수 있다.
구체적으로, Generator는 하나의 임의의 노이즈 값(latent vector)이 입력되었을 때 하나의 데이터 인스턴스(fake data)를 만들 수 있도록 한다. Discriminator는 하나의 데이터 인스턴스가 들어왔을 때 이 데이터가 real distribution(train data가 갖고 있는 분포)을 따르는 것인지(real 인지 fake 인지) 나타내는 probability를 출력하도록 한다.
학습 과정에서 Generator는 Generator에서 생성된 데이터 인스턴스(fake image)가 discriminator에서 real distribution을 따르는 것(real image)이라고 판별될 수 있도록 학습을 수행한다.
반면에, 학습 과정에서 discriminator는, 1) generator에서 생성된 데이터 인스턴스(fake image)가 입력되면 real distribution을 따르지 않는다(fake image)라고 판별하도록 학습되는 것과 더불어 2) 실제 데이터(real image)가 입력되면 real distribution을 따른다(real image)라고 판별하도록 학습된다.
여기서, 중요한 것은 Generator가 출력하는 데이터 인스턴스가 real distribution을 따르도록 만든다는 것이다.
Conditional GAN(cGAN)
일반적으로 GAN을 만들었을 때 latent vector를 바꿔가면서 새로운 이미지를 만들어 낼 수 있다. 하지만, GAN을 이용하여 의도하는 이미지를 만드는 것이 latent vector만 변경하는 것으로는 어려울 수 있다.
따라서, GAN에 별도의 조건 정보를 함께 입력할 수 있도록 하는 것이 cGAN이다. 즉, cGAN은 조건이 주어진 조건부 GAN이라고 생각하면 된다.
cGAN 모델의 목적 함수를 보면 GAN과 동일한 목적 함수에 y 값이 새롭게 조건부 형태로 들어간 것을 확인할 수 있다.
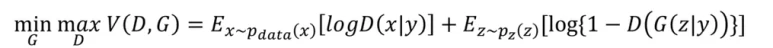
*****
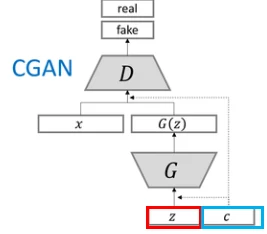
아래 그림을 확인하면 z(latent vector) 값이 c(conditional vector) 값과 같이 generator (G)에 입력되는 것을 확인할 수 있다. 여기서, c 값은, 어떤 클래스에 대한 데이터를 생성할 것인지에 대한 label 정보가 될 수 있다. Generator는 z와 c를 같이 입력받아 해당 class(c)에 해당하는 data를 만들 수 있도록 동작할 것이다.
*****
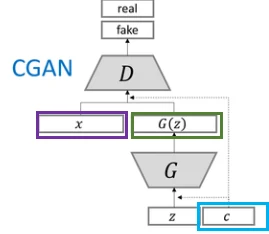
한편, Generator에서 만들어진 fake data(G(z))를 Discriminator (D)에 입력할 때 c 값과 c 값에 대응하는 label을 갖는 real data(x)를 같이 입력하게 된다. 이 구조를 갖는 네트워크를 학습시키면, cGAN은 특정 class에 적합한 데이터를 만들 수 있도록 학습된다.
Pix2pix
Image to Image translation은 주어진 이미지가 있을 때 주어진 이미지에서 특정 양상만 골라서 다른 특징으로 바꾸는 작업을 수행하는 것을 의미한다. 그리고, 대표적인 Image to Image translation 아키텍처로는 pix2pix가 있다.
Pix2pix는 학습 과정에서 이미지를 조건으로 입력하는 cGAN의 유형으로 보면 된다. cGAN에는 조건으로 label 값이 입력되었지만, pix2pix에는 조건으로 이미지가 입력되는 것이다. 즉, 가짜 이미지를 만들 때, 특정 조건을 따르는 이미지를 생성하는 것이다.
예를 들어, 윤곽만 존재하는 손으로 그린 그림(x)이 입력되었을 때 실제 있을법한 이미지(G(x))로 바꾸도록 만든다고 하면 여기서 윤곽만 존재하는 손으로 그린 그림(x)이 조건이라고 할 수 있다. 여기서, pix2pix는 손으로 그린 그림(x)을 넣었을 때 윤곽 내부를 채우는 형태로 학습을 진행하는 것이다.
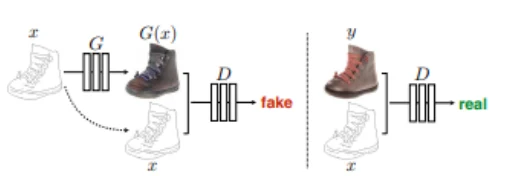
Pix2pix의 경우 서로 다른 두 도메인 X, Y의 데이터를 한 쌍으로 묶어 학습을 진행한다. 이 경우, 색상 있는 이미지(실존하는 이미지)와 이 이미지에서 색상을 빼서 만들어진 이미지를 한 쌍으로 묶어 training data set을 만든다. 그리고 이를 이용해서 학습을 진행할 수 있다.
다만, 한 쌍의 트레이닝 데이터를 만드는 작업은 어려운 경우가 많다. 예를 들어, 직접 풍경을 촬영한 이미지를 조건으로 입력하여 풍경화를 만들어내는 태스크를 위한 트레이닝 데이터 세트를 준비한다고 가정해보자. 직접 풍경을 촬영한 이미지와 그에 대응하는 풍경화를 하나씩 찾는 것도 어렵고 이것들을 쌍으로 묶는 작업도 쉽지 않다. 그리고 풍경이 촬영된 이미지를 이용해서 자동으로 풍경화를 만들어 내기도 어렵다. 이와 같이 트레이닝 데이터 셋을 만들기 어려운 경우가 많다(실제로 만들 수는 있지만 시간이 오래 걸리고 비용이 많이 발생함). 즉, 이러한 면에서 Pix2pix에 한계점이 존재한다.
cGAN의 한계
단순하게 cGAN을 이용해서 말을 얼룩말로 변경시키는 task 진행 시 특정 이미지를 이용해서 얼룩말 이미지를 만들어낼 수 있다.
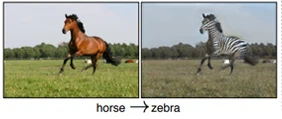
다만, 상술한 task를 진행할 수 있도록 cGAN이 학습된 경우, cGAN에 다른 말 이미지가 입력되어도 이전에 만들었던 얼룩말 이미지만 출력하게 되는 문제가 생길 수 있다.
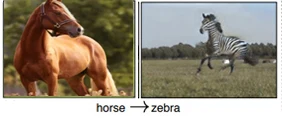
Discriminator 입장에서는 이전에 만들었던 얼룩말 이미지가 실제로 있을법하고, 특정 클래스로 분류가 되고 있기 때문에 그것만 출력하게 만들어 버리게 되는 것이다. 즉, 입력된 이미지의 identity를 따르지 않고, 특정 도메인에 해당하는 이미지를 만드는 식으로 generator가 동작할 수 있다.
CycleGAN
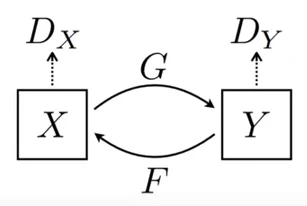
CycleGAN은 cGAN의 한계를 해결하기 위한 모델이다. CycleGAN은 Generator가 만든 fake 이미지를 다시 원본 이미지로 재구성시킬 수 있다.
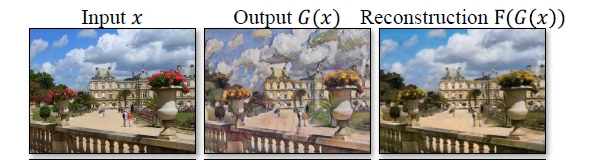
인풋 이미지(x)가 있다고 했을 때, fake image (G(x))를 만들고 다시 fake Image에서 inverse function을 하나 만든 다음에 원래 이미지로 돌아올 수 있도록 한다.
즉, 최초 인풋 이미지와 유사해지도록 하나의 인버스 매핑을 만들고 fake image가 원본 이미지로 돌아오는 형태로 loss를 구성해서 학습을 진행한다. 이를 통해 원본 이미지의 content에 대한 정보(identity)는 유지하면서 도메인(style)과 관련된 특징만 바꾸도록 학습될 수 있다. cycle과 같은 형태를 갖는다는 점에서 Cycle-consistency loss라고 불리는 로스를 사용한다.
이러한 작업들을 수행하기 위해서 실제로 2개의 translator를 사용하게 된다.
하나는 X에서 Y로 변환해 주는 작업을 수행하는 Generator이다. (G: X → Y)
그리고, 다른 하나는 Y에서 다시 X로 변환해 주는 작업을 수행하는 인버스 매핑을 수행하는 Function이다. (F:Y → X)
결과적으로, F(G(X))가 X와 유사해지도록 만들고, G(F(Y))가 Y와 유사해지도록 만드는 것을 목표로 cycleGAN이 학습을 수행하게 된다.
WGAN-GP
WGAN은 함수가 1-Lipshichtz 조건을 만족하도록 하여 안정적인 학습을 유도하도록 한다. 다만, WGAN은 제약 조건을 만족시키기 위해 weight clipping을 이용한다. 따라서, 다른 문제를 야기시킬 수 있다. WGAN-GP는 WGAN에 gradient penalty를 추가적으로 이용하여 WGAN의 성능을 개선하도록 만든 것이 특징이다.
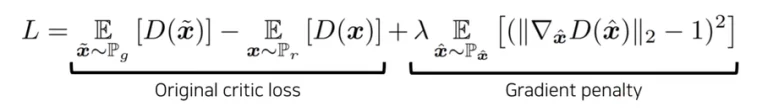
StarGAN
배경 기술로 설명드린 아키텍처들을 그대로 사용하는 경우 도메인을 다중 도메인 각각에 대한 이미지로 변환하기 위해서는 여러 개의 네트워크가 필요하다. 하지만, StarGAN은 다중 도메인 상황에서 하나의 모델을 이용해서 다중 도메인에 대한 이미지 변환을 수행해 준다. 이 경우, 여러 네트워크를 사용하지 않기 때문에 파라미터 측면에서 공간 효율적이라고 볼 수 있으며, 다수의 다양한 도메인에서 사용되는 데이터 셋을 함께 활용할 수 있기 때문에 공통된 feature를 더 잘 학습할 수 있어 성능이 더 좋아질 수 있다. 이런 아이디어를 이용한 것이 StarGAN이다.
*****
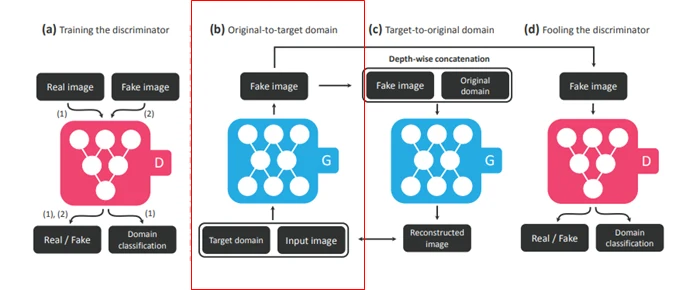
먼저, Generator는 인풋 이미지와 타깃 도메인의 벡터 값을 입력받아 인풋 이미지가 타깃 도메인으로 변경된 Fake image를 만들 수 있다.
*****
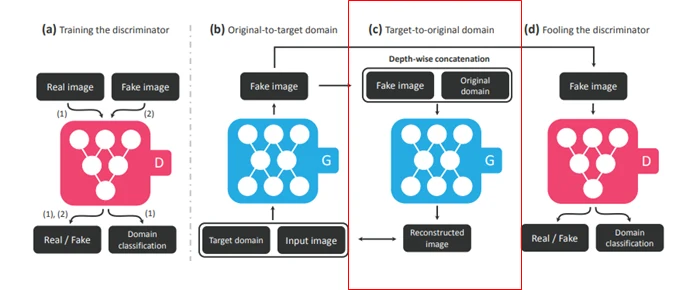
그리고, Fake image는 original domain과 묶여서 Generator에 입력되어 원본 이미지와 같은 형태로 이미지가 나올 수 있도록 만든다. 즉, Input 이미지와 유사한 reconstructed image가 나올 수 있도록 만들어 주는 것이다. 이렇게, cycle로 네트워크를 구성하여 인풋 이미지의 identity는 유지한 채 도메인 관련 정보만 바뀌도록 만들 수 있다.
*****
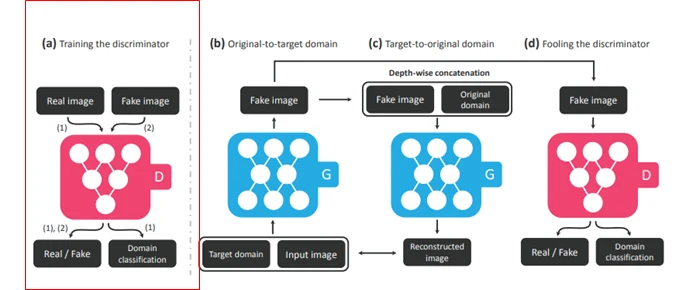
한편, Discriminator는 real image가 입력되면 real로 구분하도록 만들고, fake image가 입력되면 fake로 구분하도록 만든다. 뿐만 아니라, Disciminator는 real image가 입력되었을 때 domain class에 대한 정보 또한 출력할 수 있도록 만든다.
Generator 입장에서는 Fake 이미지로 Discriminator를 속일 수 있도록 만들어 Generator가 그럴싸한 이미지를 만들 수 있도록 만들어 주게 된다.
cGAN에 cycle-consistency loss를 추가하고, 멀티 도메인 상에서 동작할 수 있도록 Generator의 성능을 올려주는 것이 StarGAN이다.
StarGAN의 로스 값은 Adversarial loss, Domain classification loss 및 reconstruction loss를 더한 값이다.
*****
Adversarial loss는 다음과 같다.
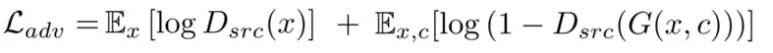
Adversarial loss에는 기본적인 GAN의 loss에 특정 도메인(c)으로 해당 이미지를 바꾼다는 개념이 추가되어 있다. 그리고, Adversarial loss의 경우 WGAN-GP의 아이디어를 이용하여 penalty가 주어진 형태로 loss 값을 구성해 줄 수 있다.
*****
Domain classification loss는 다음과 같다.
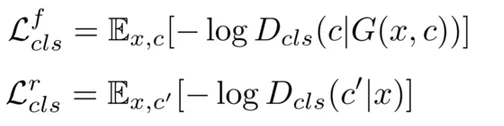
fake 이미지의 domain classification loss는 generator를 위해 사용되고, 특정 도메인으로 바뀐 이미지를 타깃 도메인으로 분류될 수 있도록 학습을 진행한다.
real 이미지의 domain classification loss는 discriminator를 위해 사용되고, real 이미지가 입력됐을 때 real 이미지에 대한 도메인 값(c')으로 분류할 수 있도록 학습을 진행한다.
*****
Reconstruction loss는 다음과 같다.
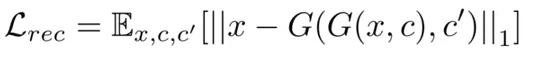
Reconstruction loss는 generator가 만든 이미지가 translate 진행 시 원본 이미지의 content가 유지될 수 있도록 cycle consistency loss를 이용한다. 그리고, 다시 원래 이미지로 복원시킬 때 실제 원본 데이터와 최종 변환된 데이터가 유사해질 수 있도록 reconstruction loss를 구성시킨다.
*****
최종 목적 함수는 다음과 같다.
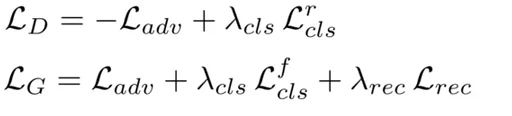
Discriminator의 목적 함수를 보면 adversarial loss에 마이너스를 붙여서 최소화를 하는데 이는 adversarial loss 자체를 최대화하겠다는 것을 의미한다. 여기에, real image에 대한 domain classification loss를 추가하여 분류 결과가 잘 나올 수 있도록 해준다.
Generator의 목적 함수를 보면 각자의 이미지가 실제 이미지로 분류될 수 있도록 adversarial loss 값을 최소화하는 형태로 학습을 진행한다. 여기에, fake image에 대한 domain classification loss와 reconstruction loss를 추가해 준다.
*****
한편 multiple dataset에서 학습을 진행하기 위해 Mask vector를 사용한다. Mask vector는 어떤 레이블을 쓸지를 마스크 하는 것이다.
머리 색과 관련된 label을 갖는 데이터 셋(양이 많음)과 감정과 관련된 label을 갖는 데이터 셋(양이 적음)이 존재하는 경우, 머리 색과 관련된 label, 감정과 관련된 label 및 mask vector를 concatenation 해주는 방식으로 이용된다.
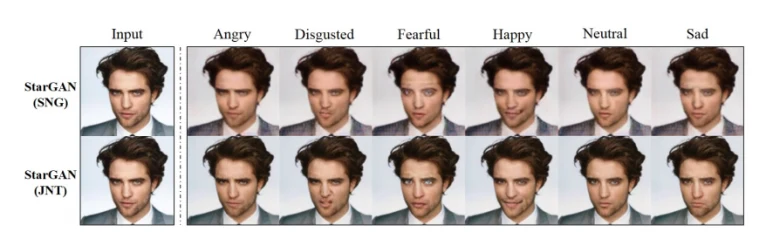
만약, 감정과 관련된 label을 갖는 데이터 셋(SNG)만 이용할 경우, dataset의 양이 적기 때문에 학습이 제대로 수행되지 못해 성능이 떨어지게 된다. (StarGAN (SNG))
하지만, multiple dataset(JNT)을 이용하면서 어떤 label을 사용할지 mask vector로 정해주는 경우, 감정과 관련된 label을 갖는 데이터 셋과 더불어 머리 색과 관련된 label을 갖는 데이터 셋도 활용하기 때문에(더욱 많은 사람 얼굴에 포함된 감정 정보를 학습에 사용하기 때문에) 성공적으로 학습을 수행할 수 있다. (StarGAN (JNT)) 즉, 학습에 사용되는 데이터의 수가 증대되는 data augmentation의 효과가 발생하게 되어 성능을 높이는 효과를 발생시킨다.
좀더 구체적인 내용을 후술해보자.
*****
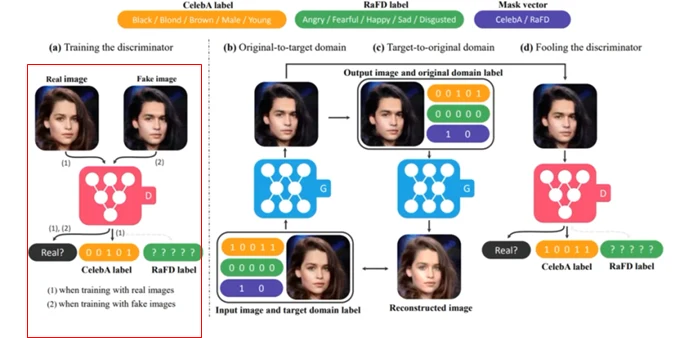
dataset이 여러 개인 경우 전체 architecture
discriminator는 real image가 들어갔을 때 real로 구분하도록 학습하면서 그에 대한 label이 무엇인지도 학습하게 된다. 한편, discriminator는 fake 이미지가 들어갔을 때 fake 이미지에 대해서는 fake라고 출력하고 label 값은 사용하지 않도록 학습하게 된다.
*****
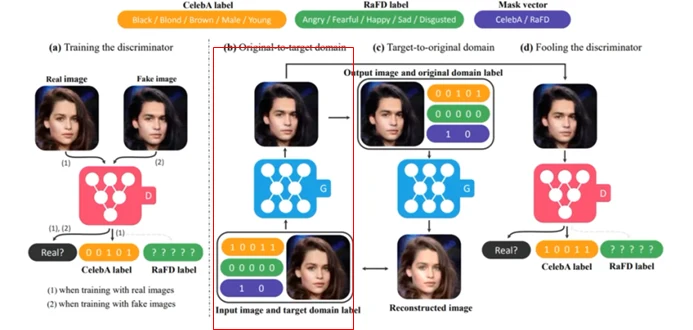
Generator는 celebA label 값인 (1 0 0 1 1), RaFD labe 값인 (0 0 0 0 0) 과 mask vector 값인 ( 1 0 )을 concatenation 해서 입력 이미지와 함께 입력 받는다. 여기서, mask vector 값 (1 0)은 첫 번째 label인 celebA label 값만 사용하겠다는 것을 의미하게 된다. celebA label (1 0 0 1 1)을 해석해보면 "검정 머리, 남성, 어림"을 의미할 수 있다. 따라서, 왼쪽 Generator의 출력으로 입력 이미지와 유사한 생김새를 갖는 검정 머리의 어린 남성 이미지가 출력된 것을 볼 수 있다.
*****
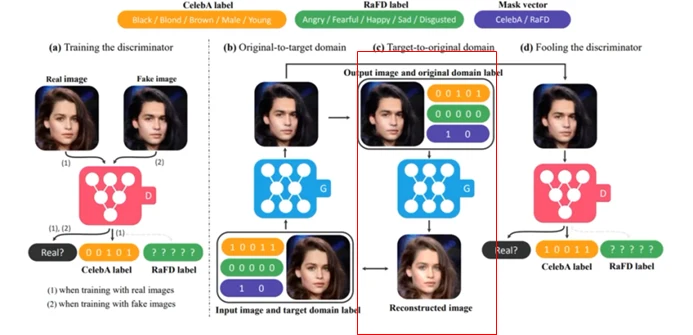
그리고, Fake 이미지가 생성된 후에는 원본 이미지에 대한 정보 즉, celebA label 값(0 0 1 0 1)과 RaFD labe 값인 (0 0 0 0 0) 과 mask vector 값인 ( 1 0 )을 concatenation 한 정보를 fake 이미지와 함께 오른쪽 generator에 입력해 준다. celebA label (0 0 1 0 1)을 해석해보면 "갈색 머리, 여성, 어림"을 의미할 수 있다. 따라서, 오른쪽 Generator의 출력으로 다시 원본 이미지와 유사한 이미지(reconstruction image)가 나올 수 있게 된다.
*****
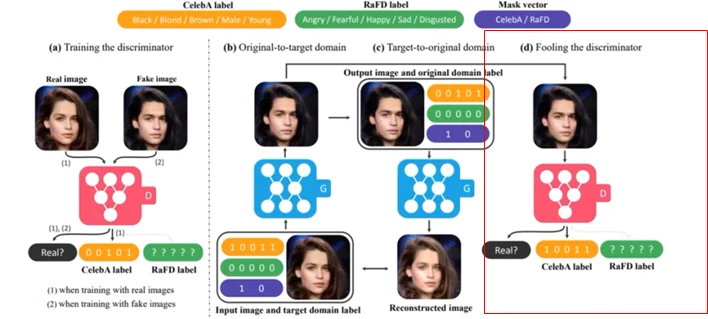
그리고, 최종적으로 Generator가 생성한 fake 이미지는 discriminator에 입력되었을 때 real로 구분되면서 의도했던 타깃 도메인으로 분류할 수 있도록 학습이 진행된다. 따라서, 얼굴이 갖는 content 즉, identity는 유지하면서 타깃 도메인에 맞는 translation이 진행된 output을 만들 수 있게 된다.
이 글은 표시된 게시일을 기준으로 작성된 자료입니다. 개별 사안에 대한 검토는 상담을 통해 안내합니다.