
StarGAN (Unified Generative Adversarial Networks for Multi-Domain Image-to-Image Translation).
Este artículo propone una red StarGAN que permite la traducción en situaciones de varios dominios.
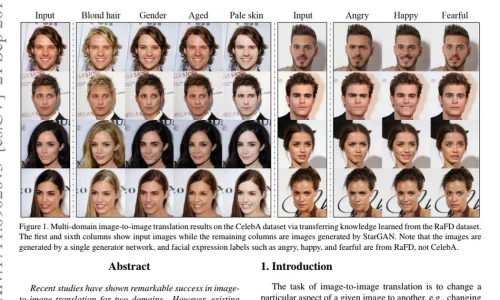
Si hace clic en la imagen, puede ver el texto completo.
[Sumario de contenido]
Para las redes no-StarGAN, como CycleGAN e IcGAN, para realizar la traducción de dominio de un dominio a otro, deben anidarse múltiples redes. Como se puede ver en el ejemplo a continuación, la habilidad no es buena.
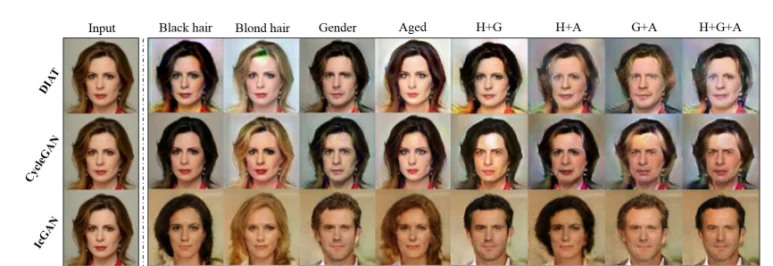
Pero... StarGAN puede traducir múltiples atributos a la vez utilizando sólo una red.
Las imágenes de entrada (clase 1) son mayores, 2) tienen pelo marrón, y 3) se clasifican como hembra) en StarGAN para traducir a otras imágenes de dominio, por lo que puede ver que realizan la traducción de dominio mejor que otras redes.
Para ponerlo más fácilmente, StarGAN es una joven imagen femenina rubia introducida.(ENTRADA)Puedes ver cómo se transforma en un viejo hombre de pelo negro. (H+G+A)
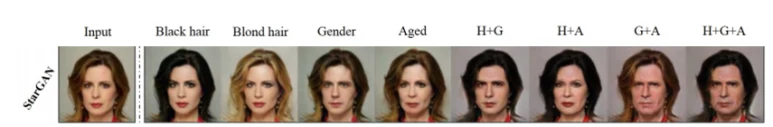
Ejemplos de StarGAN
[Tecnología de fondo explicada]
Modelización (Modelos generadores)
El modelo de creación se refiere a un modelo que no existe pero crea una imagen que puede existir. Los datos que el modelo de creación puede crear no sólo son imágenes, sino también varios datos (ex. Puede ser datos de Texas. Sin embargo, la investigación sobre el modelo de generación que genera datos de imagen es más activa que otros datos.
Los modelos de discriminación y generación son los siguientes.
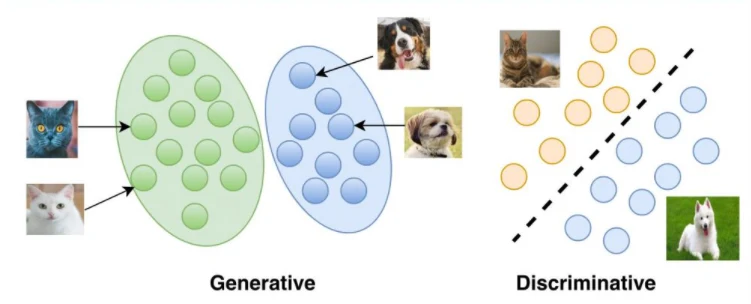
Modelo Generativo y Modelo Discriminativo
El modelo discriminativo aprende el límite de decisión entre los datos existentes y categoriza en qué clase se encuentran los datos cuando entra uno de ellos.Lo hago.
Mientras tanto, Los modelos generadores aprenden la distribución de los datos existentes y siguen la distribución aprendida, es decir, la distribución real de datos.(Datos reales)Modelo que imprime.Un modelo genérico se puede utilizar para aprender distribuciones de probabilidad conjunta.
Por ejemplo, supongamos que hay características relacionadas con el tamaño de la nariz y características relacionadas con el tamaño de los ojos. Si usted aprende la imagen de una persona, se determinará el tamaño de la nariz normal y el tamaño del ojo normal. Asumiendo un tamaño típico de la nariz de 10 cm, el valor de probabilidad para el tamaño de la nariz de 10 cm será más alto. Asumiendo un tamaño ocular normal de 3 cm, el valor de probabilidad para el tamaño ocular de 3 cm será el más alto. Así, la creación de una imagen usando los valores de características más probables (10 cm del tamaño de la nariz y 3 cm del tamaño de los ojos) en cada característica puede resultar en una imagen que se parece a una persona real.
Como resultado, El modelo de generación aprende la distribución real que los datos de aprendizaje existentes tienen, es decir, las distribuciones únicas.
La arquitectura más comúnmente utilizada para formar el modelo de creación es las Redes Adversariales Generativas (GAN).
GAN: Generative Adversarial Networks.
En mi post anterior, he escrito sobre GANs, pero esta vez los explicaré con más detalle. [Gan Post]
GAN utiliza dos redes: un generador y un discriminador.Lo es. Si el aprendizaje del generador se completa a través del GAN, puede ser posible crear una imagen que puede estar presente al introducir un ruido en el generador.
Específicamente, el generador permite crear una instancia de datos (datos falsos) cuando se introduce un vector latente. El Discriminador imprime una probabilidad indicando si estos datos siguen una distribución real (real o falsa) cuando entra una sola instancia de datos.Todo.
En el proceso de aprendizaje, el generador realiza el aprendizaje para que la instancia de datos (imagen falsa) generada por el generador pueda determinarse como una imagen real en el discriminador.
Por otro lado, en el proceso de aprendizaje, se enseña al discriminador a determinar que 1) la instancia de datos (imagen falsa) generada por el generador no sigue la distribución real, y 2) la imagen real (imagen real) se enseña a determinar la imagen real.
Aquí, lo importante es La instancia de datos que los productos del generador hacen que siga la distribución real.
GAN(cGAN) condicional
Normalmente, cuando creas un GAN, puedes cambiar el vector latente para crear una imagen nueva. Sin embargo, puede ser difícil crear una imagen destinada usando un GAN cambiando sólo el vector latente.
Por lo tanto, es cGAN que permite que una información de condición separada se integre en el GAN. En otras palabras, cGAN es un GAN condicionado.
Si usted mira la función del objeto del modelo cGAN, puede ver que el valor y ha introducido una nueva forma condicional en la misma función del objeto que el GAN.
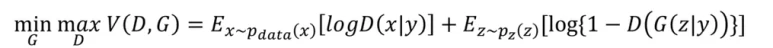
*****
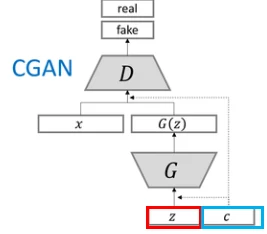
Revise la imagen de abajo. Z(el vector latente). Valor c( vector condicional) Se puede ver que el valor se introduce en el generador (G). Toma. El valor c es la información de la etiqueta para la cual clase para generar los datos.Puede ser. El generador entrará en z y c juntos para crear los datos correspondientes para esa clase(c).
*****
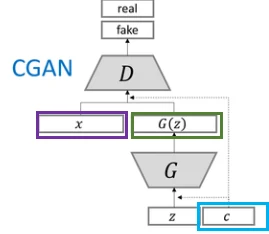
Creado por Generator. datos falsos (G(z))Ingrese al Discriminador (D) Valor Ccon la etiqueta correspondiente de c. datos reales(x)Vamos a juntarlo. Al aprender una red con esta estructura, se capacita a los cGAN para crear datos adecuados para una clase particular.
Pix2pix
La traducción de imagen a imagen es realizar la tarea de seleccionar un aspecto específico de una imagen dada y reemplazarla por otras características cuando una imagen dada está presente.En serio. Y... Imagen a Arquitectura de la traducción de imagenAhí tienes.
Pix2pix es un tipo de cGAN que introduce imágenes como condiciones en el proceso de aprendizaje. cGAN tiene un valor de etiqueta, pero pix2pix tiene una imagen. En otras palabras, cuando creas una imagen falsa, creas una imagen que sigue ciertas condiciones.
Por ejemplo, si tienes una imagen dibujada a mano (x) que sólo tiene un contorno, y quieres que se cambie a una imagen real (G(x)), entonces la imagen dibujada a mano (x), que sólo tiene un contorno es una condición aquí. Aquí, pix2pix es una forma de aprendizaje que llena el interior de los contornos cuando se inserta la figura dibujada a mano (x).
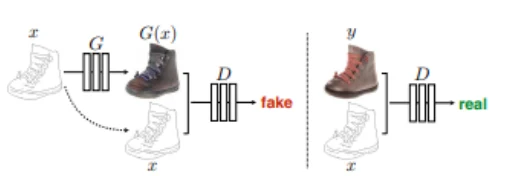
Para Pix2pix, aprende emparejando datos de dos dominios diferentes X y YSí. En este caso, un par de imágenes de colores (imágenes existentes) e imágenes creadas por colores subcontratados de esta imagen crean un conjunto de datos de entrenamiento. Y puedes usarlo para entrenar.
Pero... Crear un par de datos de entrenamiento es a menudo difícil. Por ejemplo, suponga que usted está preparando un conjunto de datos de entrenamiento para tareas que crean paisajes al introducir imágenes que se toman directamente. Es difícil encontrar la imagen que usted ha tomado y los paisajes correspondientes, y no es fácil emparejarlos. También es difícil crear un paisaje utilizando la imagen tomada. Esto a menudo hace difícil crear conjuntos de datos de entrenamiento (que en realidad se pueden hacer, pero consumen mucho tiempo y son costosos). En otras palabras, Hay un límite a Pix2pix en este sentido.
Limitaciones de cGAN
Simplemente puede utilizar cGAN para crear una imagen de cebra utilizando una imagen específica durante la tarea de cambiar el caballo en una cebra.
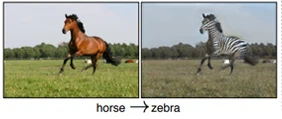
Pero... Si se aprende a cGAN a continuar con la tarea anterior, entonces cGAN puede tener problemas para producir sólo la imagen de cebra creada anteriormente, incluso si se introducen otras imágenes de discurso.
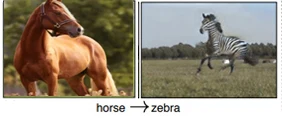
Para el Discriminador, la imagen de cebra creada anteriormente puede estar presente y se clasifica en una clase específica, por lo que sólo será la salida. Es decir, el generador puede funcionar creando una imagen correspondiente a un dominio particular, sin seguir la identidad de la imagen de entrada.
CycleGAN
CycleGAN es un modelo para resolver las limitaciones de cGAN.Lo es. CycleGAN puede reconstruir la imagen falsa creada por el generador de vuelta a la imagen original.
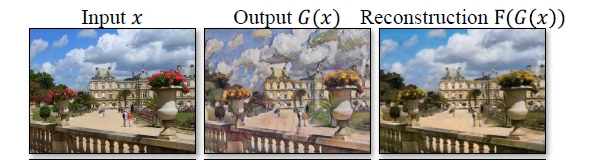
Si usted tiene una imagen de entrada (x), crear una imagen falsa (G(x)) y luego crear una función inversa en la imagen falsa y luego volver a la imagen original.
En otras palabras, se crea una cartografía inversa para parecerse a la imagen original de entrada, y la imagen falsa vuelve a la imagen original en forma de pérdida para aprender. Esto permite que la información sobre el contenido de la imagen original sea aprendida para cambiar sólo las características asociadas con el dominio (estilo). Se llama pérdida de consistencia en ciclo.
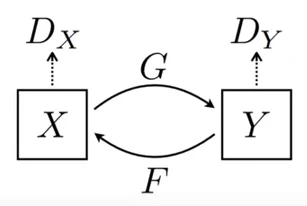
Dos traductores se utilizan para realizar estas tareas.
Uno es un generador que realiza la transformación de X a Y. (G: X → Y)
La otra es una función que realiza un mapeo inverso que convierte de nuevo de Y a X. (F:Y → X)
Como resultado, los CyGAN son entrenados para que F(G(X)) parezcan X, y G(F(Y) parezcan Y.
WGAN-GP
WGAN asegura que la función cumple con la condición de 1-Lipshichtz, lo que conduce al aprendizaje estable. Sin embargo, WGAN utiliza el recorte de peso para satisfacer las limitaciones. Por lo tanto, puede causar otros problemas. WGAN-GP se caracteriza por la adición de la pena gradiente a WGAN para mejorar el rendimiento de WGAN.
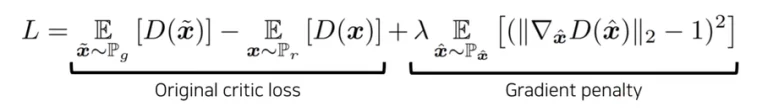
StarGAN
Al utilizar las arquitecturas descritas por la tecnología de fondo, se requieren múltiples redes para convertir un dominio en una imagen para cada uno de los múltiples dominios. Pero... StarGAN Un modeloÚsalo para realizar conversiones de imágenes para múltiples dominios. En este caso, se considera que el espacio es eficiente en términos de parámetros porque no utiliza múltiples redes, y porque puede utilizarse junto con conjuntos de datos utilizados en muchos dominios diferentes, puede ser mejor capaz de aprender características comunes, mejorando así el rendimiento. Esta idea fue utilizada por Stargan.
*****
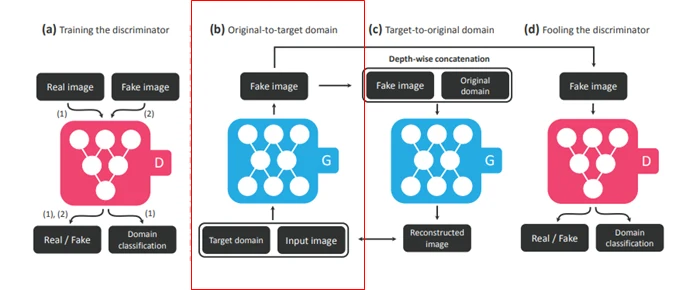
En primer lugar, un generador puede introducir un valor vectorial de la imagen de entrada y el dominio de destino para crear una imagen falsa cuya imagen de entrada ha sido cambiada al dominio de destino.
*****
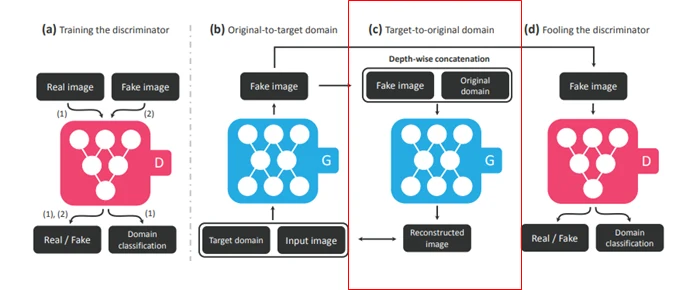
La imagen falsa está atada al dominio original y entra en el generador para que la imagen pueda aparecer en la misma forma que la imagen original. Esto le permite crear una imagen reconstruida. Así, mediante la configuración de la red con ciclo, se puede mantener la identidad de la imagen de entrada y sólo se puede cambiar la información relacionada con el dominio.
*****
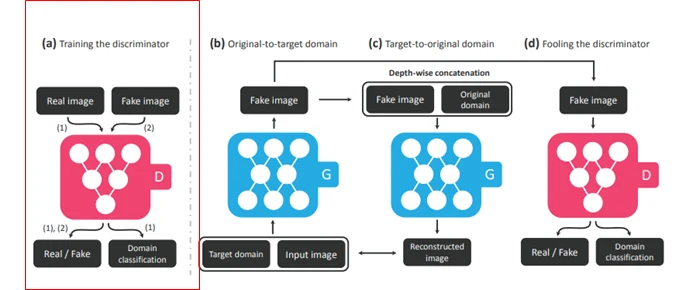
Por otro lado, el Discriminador hace que la imagen real se divida en real, y la imagen falsa se divida en falso. Además, el Disciminador permite la salida de información sobre la clase de dominio cuando se introduce la imagen real.
Para un generador, puede hacer un discriminador con una imagen falsa para que el generador pueda crear una imagen adecuada.
Es StarGAN que añade pérdida de consistencia en ciclos al cGAN y aumenta el rendimiento del generador para poder operar en múltiples dominios.
El valor ROS de StarGAN es el plus de pérdida adversarial, pérdida de clasificación de dominios y pérdida de reconstrucción.
*****
La pérdida adversarial es la misma.
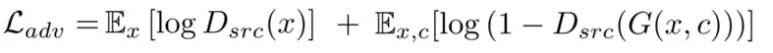
La pérdida adversarial añade el concepto de cambiar la pérdida por defecto de GAN a un dominio específico (c). En el caso de pérdida adversarial, la idea de WGAN-GP puede utilizarse para construir un valor de pérdida en la forma dada por la sanción.
*****
La pérdida de clasificación de dominios es la siguiente.
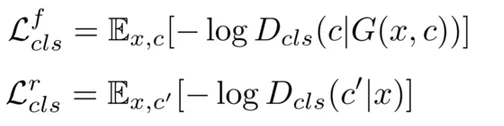
La pérdida de clasificación de dominio de una imagen falsa se utiliza para el generador, y el aprendizaje se lleva a cabo para que la imagen cambiada a un dominio específico pueda ser clasificada como un dominio objetivo.
La pérdida de la clasificación de dominio de la imagen real se utiliza para el discriminador, y el aprendizaje se hace para clasificar la imagen real como el valor de dominio (c') para la imagen real cuando se introduce.
*****
La pérdida de reconstrucción es la siguiente.
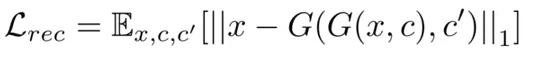
La pérdida de reconstrucción utiliza pérdida de consistencia del ciclo para que la imagen creada por el generador pueda conservar el contenido de la imagen original durante el proceso de traducción. Luego, al restaurar la imagen original, configura la pérdida de reconstrucción para que los datos originales reales y los datos convertidos finales puedan ser similares.
*****
El objetivo final es el siguiente.
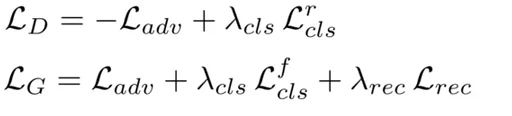
La función objetiva del discriminador es minimizar la pérdida adversaria añadiendo un menos, lo que significa maximizar la pérdida adversaria en sí misma. Esto se hace añadiendo una pérdida de clasificación de dominios para la imagen real.
Si usted mira la función del objeto del generador, usted aprenderá a minimizar el valor de pérdida adversarial para que cada imagen pueda ser clasificada como una imagen real. Añadir pérdida de clasificación de dominios y pérdida de reconstrucción para imágenes falsas.
*****
Hannibal Utilice un vector de máscara para avanzar su aprendizaje en múltiples conjuntos de datosSí. Un vector de máscara es una máscara para una etiqueta.
Si hay un conjunto de datos con una etiqueta asociada con el color del cabello (muchos positivos) y un conjunto de datos con una etiqueta relacionada con la emoción (menos positivo), se utiliza de una manera que concatena una etiqueta asociada con el color del pelo, una etiqueta asociada con la emoción, y un vector de máscara.
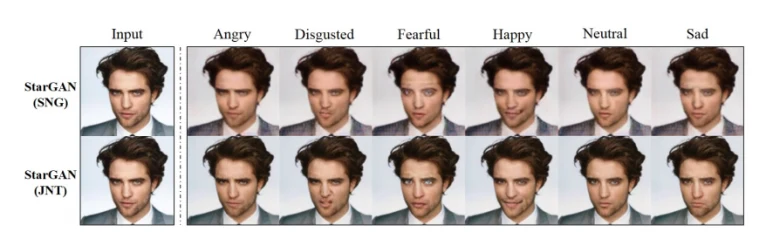
Si sólo se utiliza un conjunto de datos (SNG) con una etiqueta relacionada con las emociones, la cantidad de conjunto de datos es pequeña, por lo que el aprendizaje no se realiza correctamente y el rendimiento se reduce. (StarGAN)
Sin embargo, al utilizar múltiples conjuntos de datos (JNTs) para determinar qué etiqueta utilizar como vector de máscara, puede realizar el aprendizaje exitosamente porque utiliza conjuntos de datos con etiquetas relacionadas con la emoción, así como conjuntos de datos con el color del cabello (utilizando más información de emoción contenida en más caras de personas para aprender). (StarGAN (JNT)) Esto da lugar a un aumento del número de datos utilizados para el aprendizaje, lo que da lugar a un aumento del rendimiento.
Recaptemos algunos más específicos.
*****
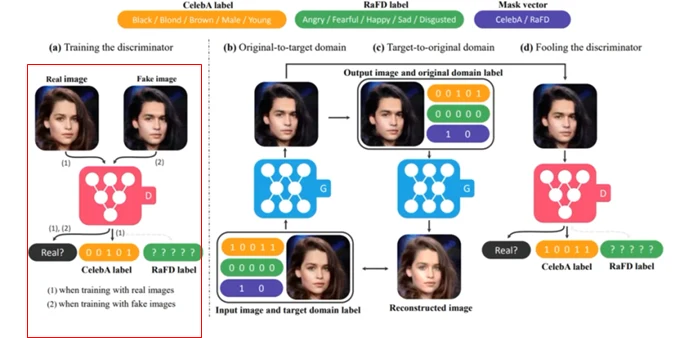
Todo el conjunto de datos.
El discriminador aprende de qué se trata la etiqueta cuando se introduce una imagen real. Por otro lado, cuando el discriminador entra en la imagen falsa, imprime falso para la imagen falsa y aprende a no utilizar el valor de la etiqueta.
*****
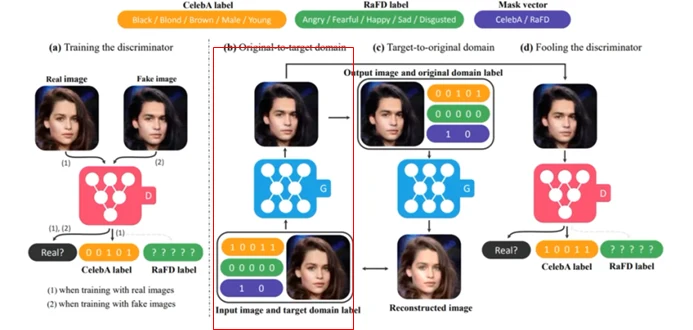
El generador concatena el valor de la etiqueta celebA (1 0 1 1), el valor de la etiqueta RaFD (0 0 0 0 0 ), y el valor vectorial de la máscara ( 1 0 ) con la imagen de entrada. Aquí, el valor vectorial de máscara (1 0) significa que sólo se utiliza la primera etiqueta, etiqueta celebA. Una interpretación de la etiqueta celebA (1 0 1 1) podría significar "pelo negro, macho, hembra." Así, la salida del generador izquierdo muestra la salida de una imagen masculina joven de la cabeza negra con una apariencia similar a la imagen de entrada.
*****
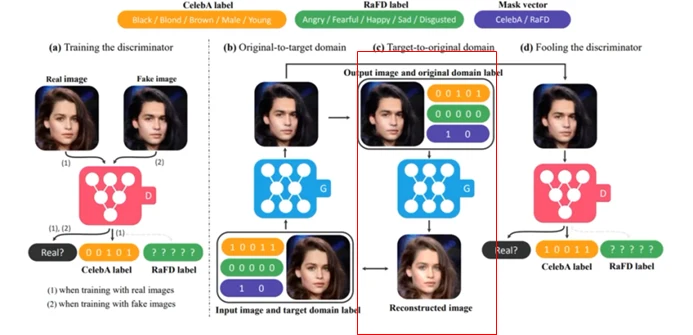
Luego, después de crear la imagen falsa, la información sobre la imagen original, es decir, el valor de la etiqueta celebA (0 0 1 0 1), el valor de la etiqueta RaFD (0 0 0 0) y el valor vectorial de máscara ( 1 0 ), se concatenan en el generador adecuado con la imagen falsa. Una interpretación de la etiqueta celebA (0 0 1 0 1) podría significar "pelo marrón, mujer, niño." Así, la salida del generador adecuado permite que una imagen de reconstrucción similar a la imagen original aparezca de nuevo.
*****
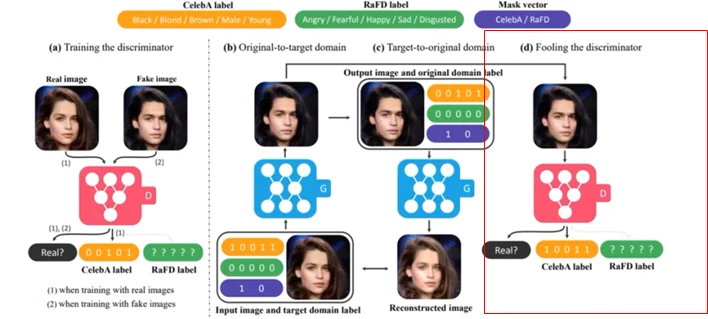
Finalmente, la imagen falsa generada por el generador se divide en real cuando se introduce en el discriminador, para que pueda clasificarse como el dominio objetivo previsto. Así, el contenido de la cara, es decir, la identidad, se puede mantener al crear una salida que se ha traducido al dominio objetivo.
Este artículo del archivo refleja la situación en su fecha de publicación. Contacte con el despacho para analizar su caso.