
StarGAN:用于多域图像转换的统一生成对抗网络
本文提出一个StarGAN网络,能够在多领域情况下进行翻译.
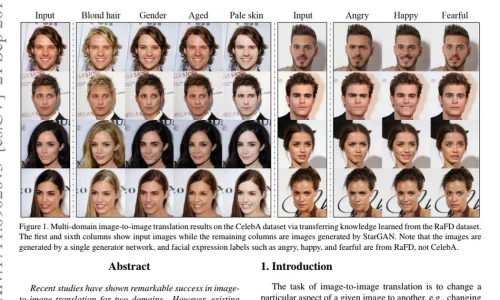
如果点击图像,可以看到全文。
[有关摘要]
对于CycleGAN和IcGAN等非StarGAN网络来说,要从一个域执行域名翻译到另一个域名,多个网络必须筑巢. 从下面的例子中可以看出,这种技能并不好。
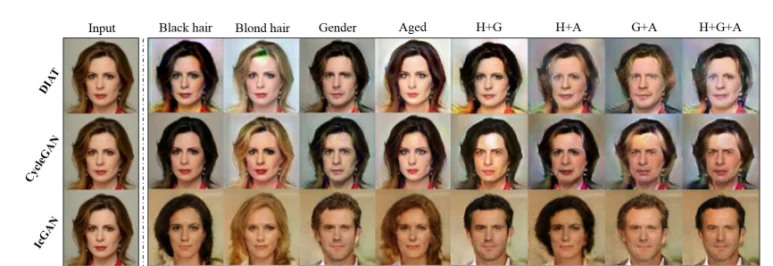
不过... StarGAN可以一次翻译多个属性,只使用一个网络.
输入图像(第1类)年龄较大,2)有棕色的毛发,3)被归类为雌性)进入StarGAN翻译到其他域图像,因此可以看到它们比其他网络更能执行域翻译.
更简单的说,StarGAN是一个年轻的金发女性形象输入.(输入)你可以看到它是如何变成一个黑发老男人的。 (H+G+A) (韩语).
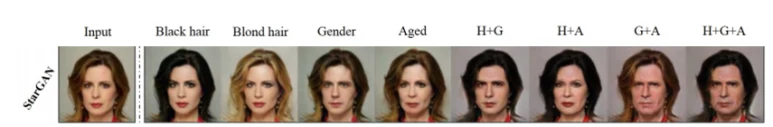
StarGAN 实例
[背景技术解释]
建模(通用模型)
创建模型是指不存在但创造了可能存在的图像的模型. 创建模型可以创建的数据不仅是图像,还有各种数据(ex. 可以是德克萨斯州的数据. 然而,对生成图像数据的生成模型的研究比其他数据最为活跃.
歧视模式和基因模式如下。
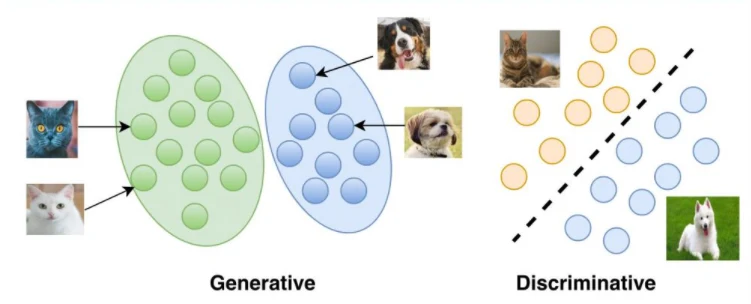
遗传模型和歧视模型
歧义模型学习了现有数据之间的决定边界,并对一个数据出现时数据是什么分类进行分类.我这样做。
同时, 生成模型从现有数据中学习分布,并遵循学到的分布,即真实的数据分布。(真实数据)指纹的模型。一个通用模型可以用来学习联合概率分布.
例如,假设有与鼻子大小相关的特征和与眼睛大小相关的特征. 如果你学会一个人的形象,正常鼻子的大小和正常眼睛的大小将会被确定. 假设典型的鼻子大小为10厘米,则鼻子大小为10厘米的概率值会最高. 假设正常眼大小为3cm,则眼大小为3cm的概率值将是最高的. 因此,利用每个特征中最可能的特征值(鼻子的大小为10厘米,眼睛的大小为3厘米)来创建图像,可以形成像真人一样的图像.
结果, 生成模型学习了现有学习数据具有的真实分布,即独特的分布.
最常用的用于培训创作模型的架构是Generative Aversarial Networks(GAN).
GAN: 基因辅助网络
此前的文章已经介绍过GAN,本次将作更详细的说明。 [甘帖].
全球网络利用两个网络:一个发电机和一个判别器。没错 如果生成器的学习是通过GAN完成的,可能通过将一个噪声输入到生成器中来生成一个可能存在的图像.
具体来说,当输入一个潜在矢量时,生成器允许创建一个数据实例(假数据). 判别器打印出一个概率,表明当一个数据实例出现时,这些数据是否遵循真实的分布(真实的还是假的).一切众生.
在学习过程中,生成者进行学习,这样可以确定生成者生成的数据实例(假图像)是判别器的真实图像。
另一方面,在学习过程中,判别器被教导确定1)生成者生成的数据实例(假图像)不遵循真实分布,2) 真实图像(真图像)被教导确定真实图像。
在这里,重要的是 生成器输出导致其跟踪实际分布的数据实例。
有条件的GAN( cGAN)
通常,当创建GAN时,可以改变潜在的矢量来创建新的图像. 然而,仅仅通过改变潜在的矢量,就很难使用GAN来创建预期的图像.
因此,CGAN允许在GAN中单独输入条件信息. 换句话说 cGAN是有条件的GAN.
如果查看cGAN模型的对象功能,可以看到y值在和GAN相同的对象功能中输入了新的条件形式.
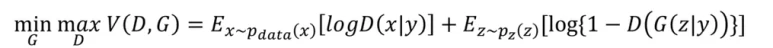
*****
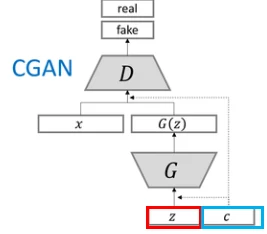
请参见下图。 z( 线性向量) 数值 c( 有条件的矢量) 您可以看到值是在生成器( G) 中输入的. 这里。 c值是用于生成数据的分类的标签信息.亦可说也. 生成器将一起输入z和c,以创建该类(c)的相应数据.
*****
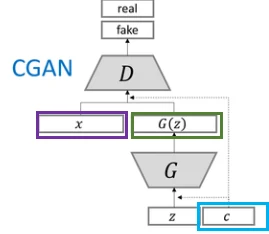
由发电机创建. 假数据(G(z))输入判别器( D) C 数值并带有c的相应标签. 真实数据( x)集诸众生. 在学习一个带有这种结构的网络时,cGANs会接受培训,以创建适合特定类的数据.
像素2pix
图像到图像翻译是执行从给定图像中选择特定方面的任务,并在给定图像出现时用其他特性来代替.我是认真的。 还有... 图像到图像翻译架构给你。
Pix2pix是一类作为学习过程中的条件输入图像的cGAN. cGAN有标签值,但pix2pix有图像. 换句话说,当你创造出一个假图像时,就会创造出一个符合某些条件的图像.
例如,如果手画的图片(x)只有轮廓,想要将其改为实际图像(G(x)),那么只画轮廓的手画图片(x)就是这里的一个条件. 在此,pix2pix是一种在插入手绘图(x)时填充轮廓内部的学习形式.
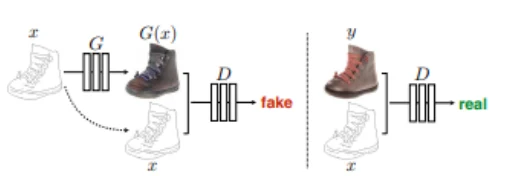
对于 Pix2pix,通过对两个不同域的数据进行配对来学习 X 和 Y没错。 在这种情况下,一对彩色图像(存在图像)和通过从此图像中减去颜色而创建的图像会创建一个训练数据集. 你可以用它来训练。
不过... 建立一对训练数据往往很困难。 例如,假设您正在为通过输入直接拍摄的图像来创建景观的任务准备一个训练数据集. 很难找到您所拍摄的图像和相应的景观,并且很难将它们配对. 通过使用所拍摄的图像来创造地貌也很困难. 这往往使得很难建立训练数据集(实际上可以制作,但耗费时间和费用)。 换句话说 在这方面,Pix2pix是有限度的.
cGAN的限制
你可以简单地使用cGAN来创建斑马图像,在任务期间使用特定的图像来将马变成斑马.
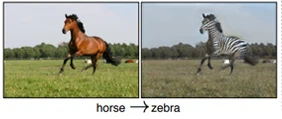
不过... 如果cGAN学会了继续完成上述任务,那么cGAN就可能存在只输出之前创建的斑马图像的问题,即使其他语音图像是输入的.
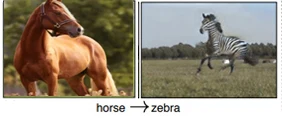
对歧义者来说,之前创建的斑马形象实际上可能存在,并被归类为特定的类,因此它只会是输出. 也就是说,生成器可以通过创建一个与特定域对应的图像来操作,而不跟随输入图像的身份.
循环GAN
CycleGAN是解决cGAN局限性的模型.没错 CycleGAN可以将发电机所创造的假图像重建回原图像.
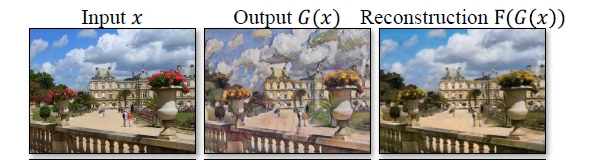
如果您有输入图像(x),则创建假图像(G(x)),然后在假图像中创建反向函数,然后返回原图像.
换句话说,一个反向映射是为了类似于原始输入图像而创建的,假图像以学习损失的形式返回原始图像. 这使得关于原始图像内容的信息能够被学习到,只改变与域相关的特性(样式). 这被称为周期一致性损失。
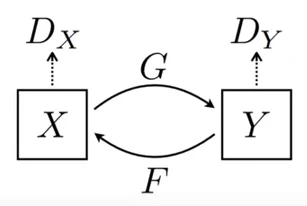
使用两名笔译员执行这些任务。
一个是完成从X到Y的转换的生成器. (G:X = Y) (中文(简体) ).
另一种是再次从Y到X转换的逆向映射函数. (女:Y ×××)
因此,循环GAN被训练成F(G(X))外形像X,G(F(Y)外形像Y.
WGAN-GP
WGAN确保功能满足1-Lipshichtz条件,从而实现稳定的学习. 然而,WGAN使用减重来满足限制. 因此,它可能造成其他问题。 WGAN-GP的特点是在WGAN中增加了梯度罚,以提高WGAN的性能.
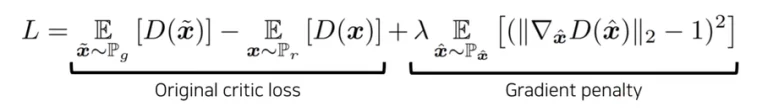
星关
在使用背景技术所描述的架构时,需要多个网络将一个域转换成多个域的每个域的图像. 不过... 星关 一个模式用于执行多个域的图像转换。 。 。 。 在这种情况下,它被认为在参数上具有空间效率,因为它不使用多个网络,并且因为它可以与许多不同领域使用的数据集一起使用,因此它可以更好地学习共同的特性,从而改进性能. 这个想法被斯塔根使用.
*****
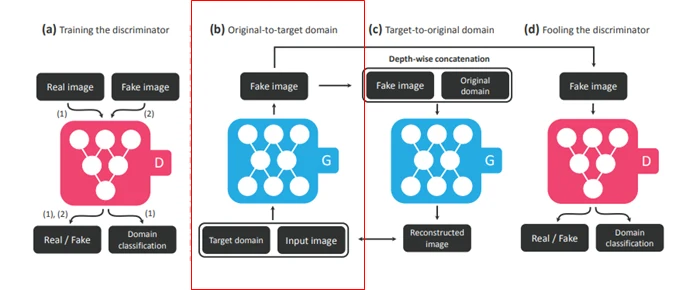
首先,一个生成器可以输入输入图像和目标域的矢量值,以创建一个其输入图像已被更改为目标域的假图像.
*****
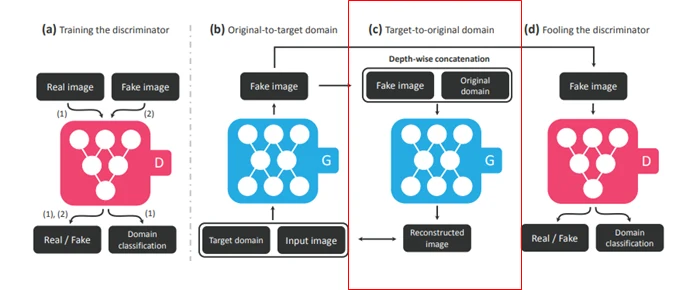
假图像随后被绑定在原域,并输入生成器中,以便图像能以与原图像相同的形式出现. 这使得您可以创建一个重建的图像 。 因此,通过将网络配置为循环,可以保持输入图像的特性,并且只能改变与域有关的信息.
*****
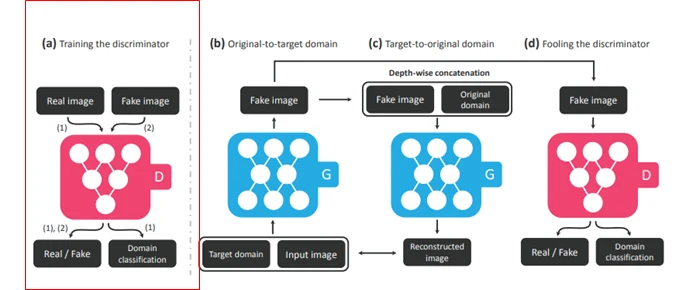
判别器(Discriminator)学习将真实图像判为真实、生成图像判为虚假;输入真实图像时,还输出其所属域类别的信息。
对于一个生成器,可以用假图像制作一个歧义者,这样生成器就可以生成一个合适的图像.
是StarGAN在cGAN中增加了循环一致性损失,提高了生成器的性能,以便能在多个域上运行.
StarGAN的ROS值是Aversarial lose,域分类损失,以及重建损失的加法.
*****
常损亦复如是.
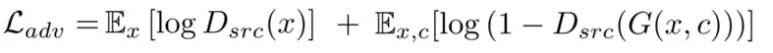
逆差损失增加了将默认的GAN损失改为特定域(c)的概念. 在横向损失的情况下,WGAN-GP的概念可以用来以罚则给出的形式构建损失值.
*****
域分类损失如下.
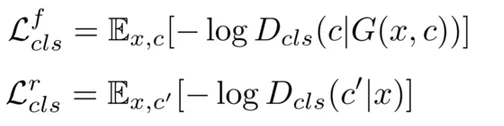
假图像的域分类损失用于生成器,并且进行学习,以便将图像更改为特定域可以归类为目标域.
真实图像的域分类损失用于判别器,学习时将真实图像分类为输入时真实图像的域值(c').
*****
接下来是重建损失。
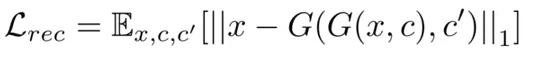
重建损失使用循环一致性损失,这样生成器生成的图像在翻译过程中可以保留原始图像的内容. 然后,在恢复原始图像时,配置重建损失,以便实际原始数据和最终转换的数据可以相似.
*****
最终目标如下。
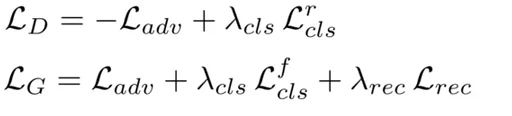
判别器的客观作用是通过加减来尽量减少对抗性损失,这意味着对抗性损失本身最大化。 这是通过为真实图像添加域分类损失来实现的。
如果查看生成器的对象功能,就会学会将对抗性损失值最小化,这样每个图像就可以被归类为真实的图像. 为假图像添加域分类损失和重建损失.
*****
汉尼拔 使用遮罩向量推进您在多个数据集中的学习没错。 口罩向量是标签的口罩.
如果有与毛色相关的标签(很多是正的)的数据集和与情感相关的标签(小是正的)的数据集,则其使用方式是将与毛色相关的标签,与情感相关的标签,以及遮罩矢量等混为一谈.
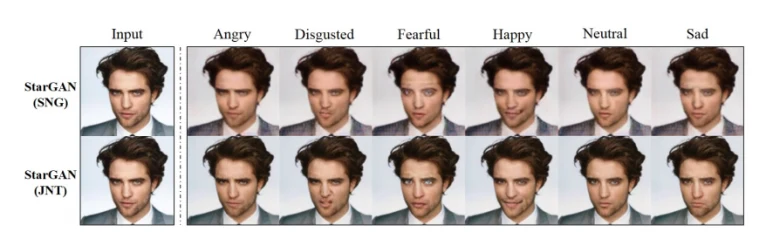
如果只使用带有情感相关标签的一组数据(SNG),数据集的数量就很小,因此学习表现不当,性能下降. (StarGAN(英语:SNG)).
然而,在使用多个数据集(JNTs)确定哪些标签作为遮罩矢量时,它能够成功进行学习,因为它使用带有情感相关标签的数据集以及带有发色的数据集(使用更多人脸中包含的情感信息进行学习). (StarGAN(JNT))),这导致用于学习的数据增量增加,导致性能提高.
让我们再总结一些细节。
*****
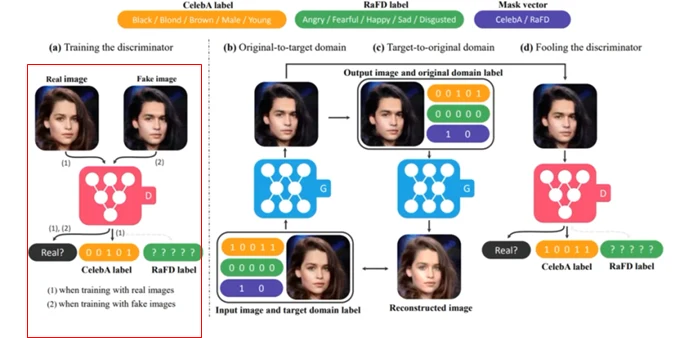
整个数据集。
歧义者在真实图像输入时,会了解标签的内容。另一方面,当判别器进入假象时,会为假象打印假象,学会不要使用标签值。
*****
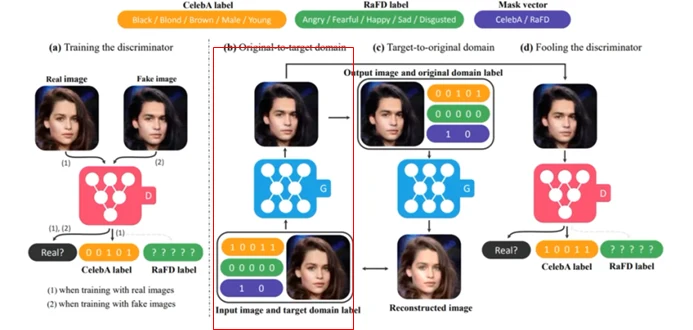
生成器将celebA标签值(1 0 0 1),RAFD标签值(0 0 0 0 ),以及带有输入图像的遮罩矢量值(1 0 )相容. 在这里,遮罩矢量值(1 0)意味着只使用第一个标签,celebA标签. 对celebA标签(0 0 1)的解释可以指: 黑发,雄性,雌性. 因此,左生成器的输出显示黑色头部的年轻男性图像的输出,其外观与输入图像相似.
*****
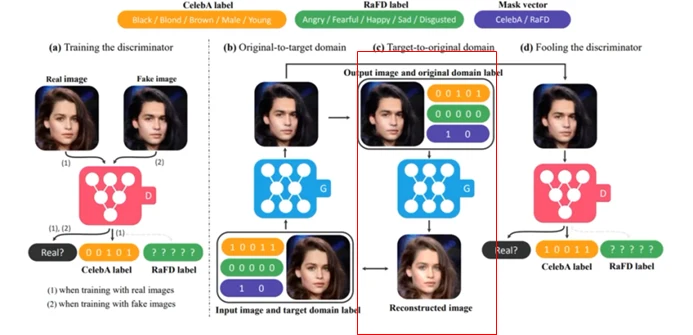
然后,在假图像创建后,原始图像的信息,即cebebA标签值(0 0 10 1),RAFD标签值(0 0 0 0)和面具矢量值(10 ),与假图像一起被缩合到右生成器中. 对celebA标签(0 0 1 0 1)的解释可以指"棕发,雌性,孩子",因此,右生成器的输出允许类似原图像的重建图像再次出现.
*****
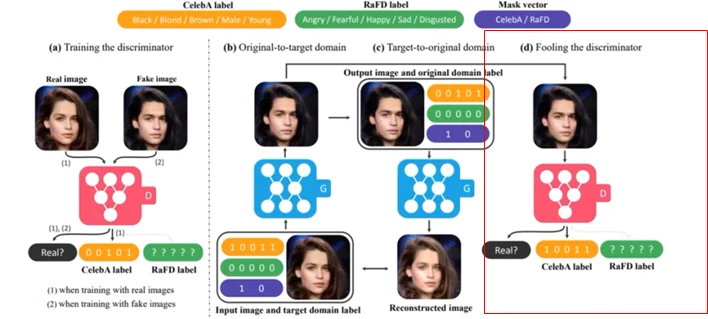
最后,生成者生成的假图像在输入判别器时被分为真实,这样就可以归类为预定的目标域。因此,面部的内容,即身份,可以在创建一个已经翻译到目标域的输出的同时得到维护。
本文基于发表时的情况撰写。如需就具体事项咨询,请联系IPLEX。