
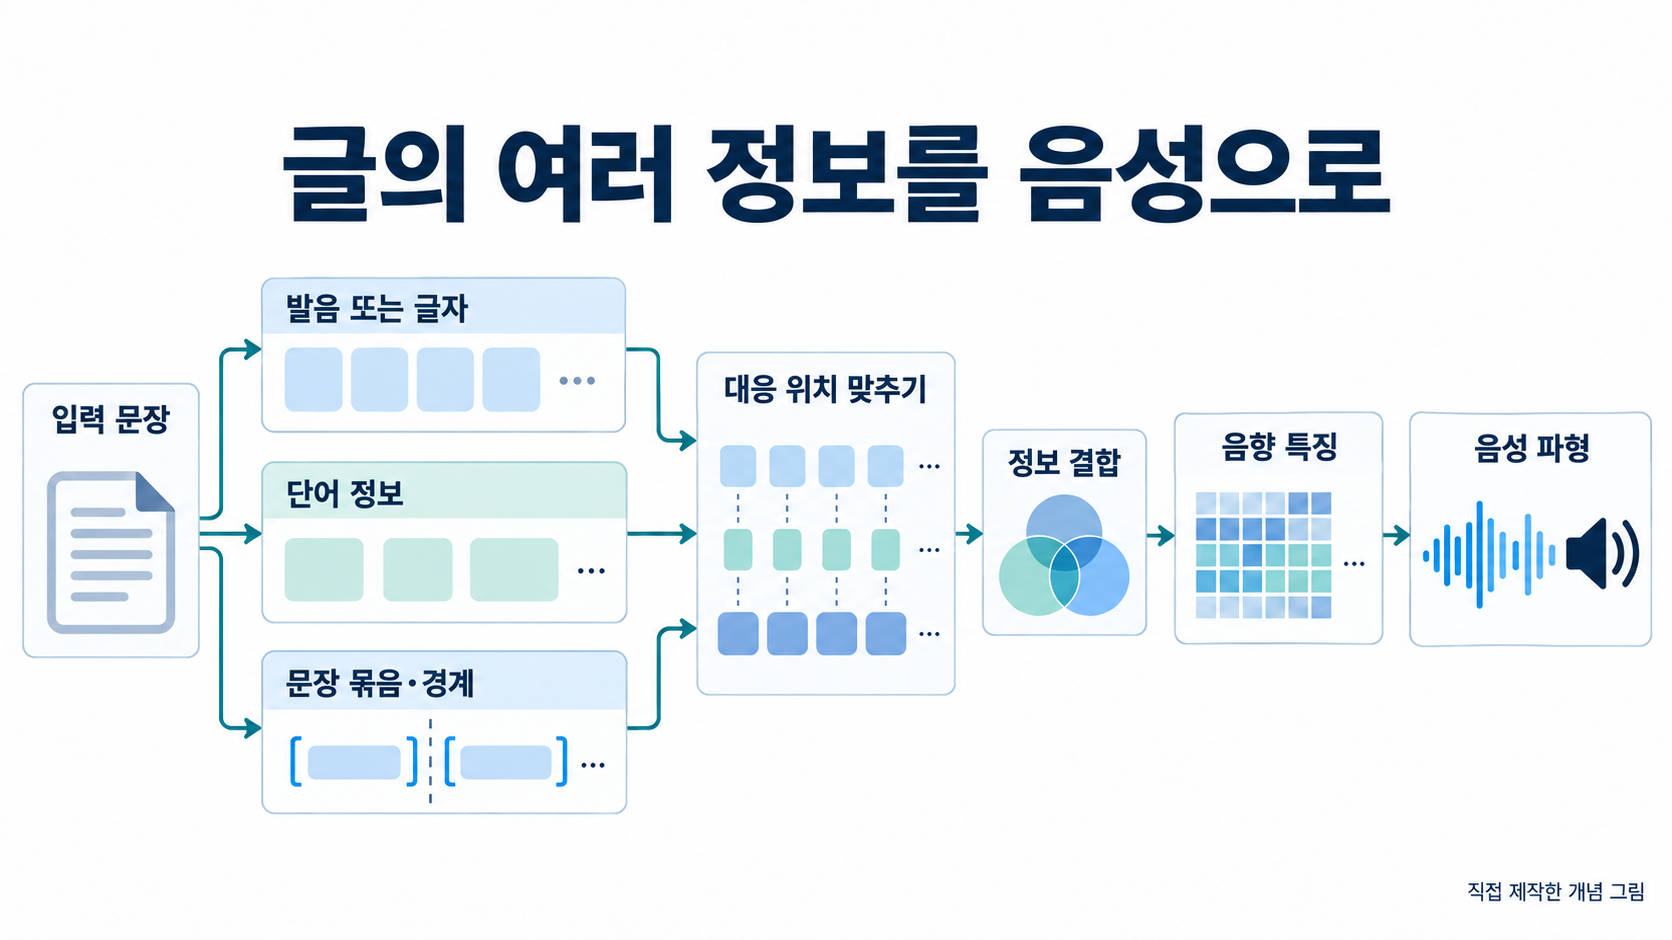
Un aviso hablado debe pronunciarse con claridad y mantener un ritmo coherente. La patente US12094447B2 de Microsoft describe una arquitectura de texto a voz que reúne varios niveles de información lingüística. Un aviso de expedición ficticio permite seguir la alineación de esas entradas hasta la generación de la señal de voz.
1. Un mismo mensaje admite distintas formas de lectura
Supongamos que una tienda en línea reproduce el aviso «Su pedido se expedirá mañana». En pantalla, el mensaje se comprende de inmediato. Al escucharlo, también importan la articulación de las palabras, las pausas y la continuidad de la frase. Un texto fijo no impone una única forma de decirlo.
La conversión de texto a voz, o TTS, genera voz sintetizada a partir de un contenido escrito. No basta con producir sonidos aislados: intervienen la altura tonal, la duración, el acento y las pausas. Estos elementos forman la prosodia, que organiza el ritmo y la entonación del enunciado.
La patente añade información de palabras y de oraciones a la información de fonemas o caracteres. Así, las unidades de pronunciación se procesan junto con representaciones del contexto y de la estructura lingüística. Para comprender la solución técnica conviene identificar de dónde procede cada representación y en qué punto se combina.
El proceso analizado sintetiza un mensaje que ya se ha proporcionado. Elegir una respuesta o redactar un aviso nuevo son operaciones distintas. Aquí se estudia cómo calcular la expresión sonora de un texto determinado.
2. Qué aporta cada nivel de información
Los fonemas permiten distinguir los sonidos del habla, mientras que la información de caracteres sigue la secuencia escrita. El procedimiento descrito puede partir de fonemas o de caracteres; no exige que ambas clases de secuencia se utilicen simultáneamente en todos los casos.
En el nivel de palabra se emplean representaciones aprendidas a partir de datos lingüísticos. Estas recogen información sobre las palabras y sus relaciones. Un aviso de expedición ofrece un contexto diferente del de otro tipo de texto, por lo que las palabras no se tratan como simples números de identificación.
La información de la oración procede de su estructura gramatical. Puede indicar a qué sintagmas pertenece una palabra, si se encuentra en un límite del sintagma y cuál es su posición relativa dentro de él. De este modo, la organización de los grupos de palabras interviene en la síntesis.
Ninguna de estas entradas constituye todavía un sonido terminado. Son representaciones de las unidades de pronunciación, de la información léxica y de la estructura de la oración. Distinguir los tres niveles ayuda a entender por qué deben alinearse y combinarse después.
3. Preparar las palabras y la estructura gramatical
Una representación vectorial de una palabra, o word embedding, expresa una palabra mediante valores numéricos que puede procesar una red neuronal. La patente describe el uso de un modelo de representaciones de palabras previamente entrenado para incorporar a la síntesis conocimientos obtenidos de material lingüístico.
El análisis sintáctico aporta otra representación. Un árbol organiza la oración en sintagmas y palabras. A partir de esa estructura se extraen características como el tipo de sintagma, si una palabra marca el inicio o el final del sintagma y la posición relativa de cada palabra.
En el aviso ficticio pueden distinguirse, a modo de ayuda para la lectura, un grupo que identifica los productos pedidos y otro que expresa su expedición al día siguiente. Se trata de una simplificación ilustrativa. La salida de un analizador real depende de la lengua y del método utilizado.
La estructura gramatical se convierte en características computables asociadas a las palabras. No se añade al aviso una explicación escrita de su gramática. La representación resultante proporciona al modelo de voz información estructural que puede utilizar durante el procesamiento.
4. Alinear secuencias de distinta longitud
La secuencia de palabras suele tener una longitud diferente de la secuencia de caracteres o fonemas, porque una palabra puede contener varios de ellos. Colocar ambas secuencias una junto a otra no aclara por sí solo qué elementos se corresponden.
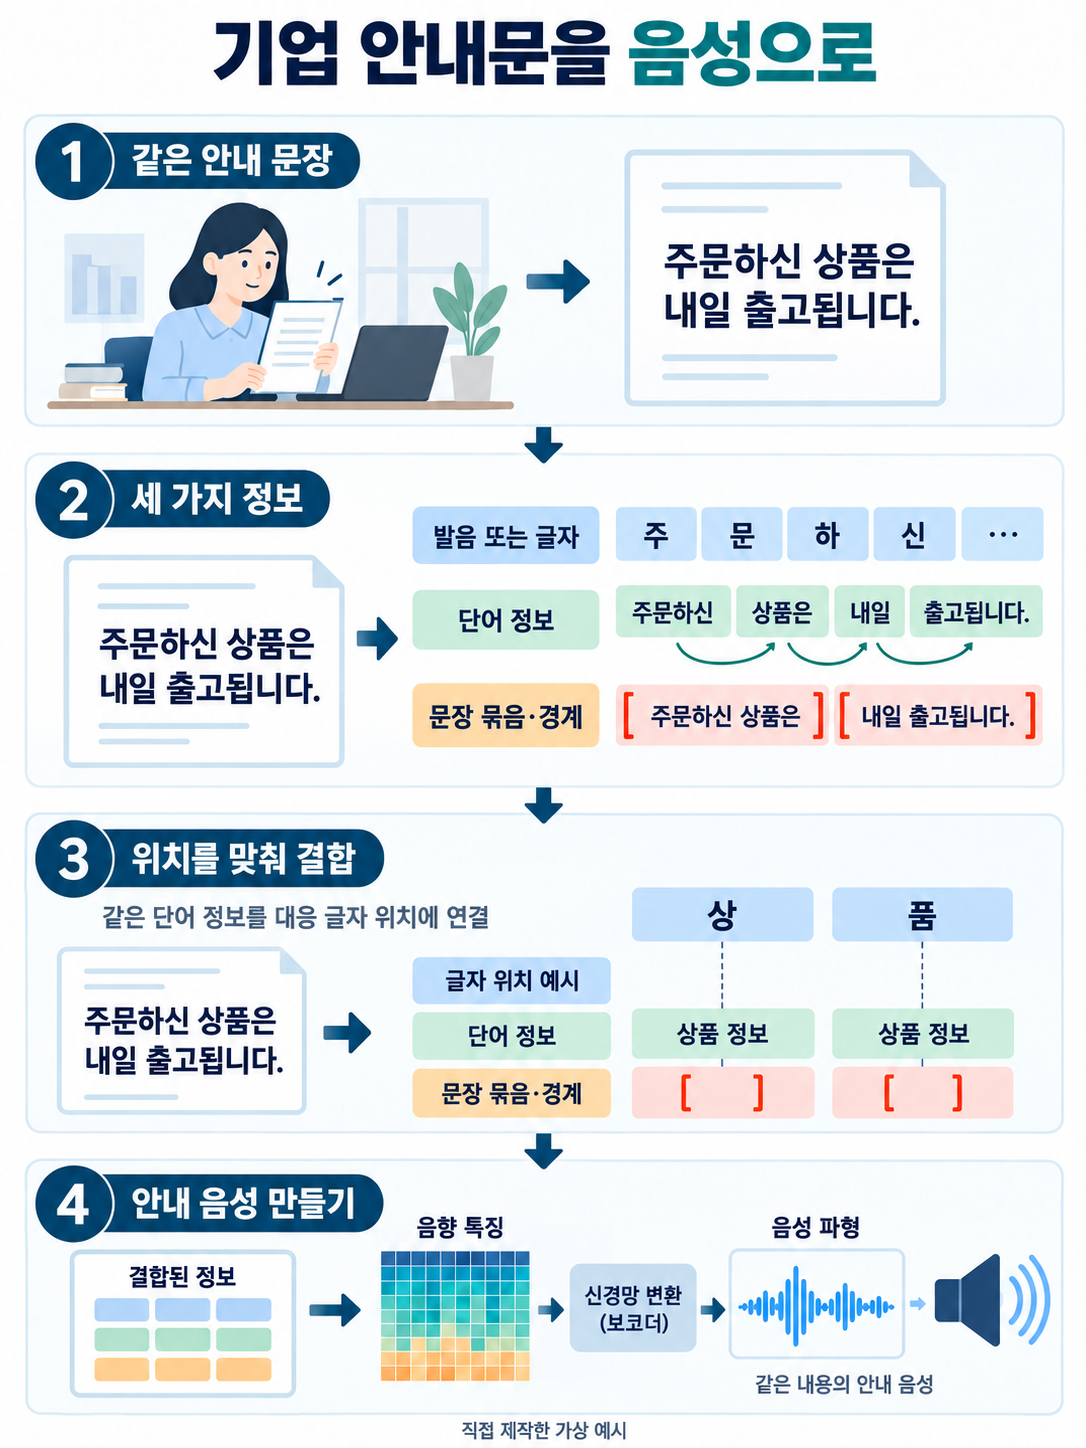
Una de las soluciones descritas repite la información de cada palabra tantas veces como fonemas o caracteres le correspondan. Las características gramaticales de esa palabra se pueden alinear de la misma manera. Este aumento de resolución de la secuencia, denominado up-sampling, lleva la información al nivel más detallado.
El ejemplo coreano de la fuente utiliza una palabra que significa «producto» y contiene dos bloques silábicos escritos. La misma información de palabra se asocia a ambas posiciones. Esto no significa que la palabra se pronuncie dos veces: cada posición consulta la información de la palabra a la que pertenece.
La alineación afecta a representaciones textuales, no a la duración de una grabación ni a la velocidad de reproducción. La evolución temporal de la voz se genera más adelante, una vez combinada la información obtenida del texto.
5. De la información combinada a la señal de voz
Las entradas preparadas llegan a un codificador de múltiples entradas. El codificador transforma los datos en representaciones aprovechables por las etapas neuronales siguientes. En este caso, la información de fonemas o caracteres y la información contextual contribuyen a formar características del texto.
La descripción contempla varios puntos de combinación. Es posible procesar las entradas con redes separadas y concatenar sus resultados, o combinarlas antes de introducirlas en una red. La arquitectura se distingue tanto por la información que recibe como por el lugar en el que la integra.
Un mecanismo de atención y un decodificador transforman las características textuales en características acústicas. La atención vincula información pertinente del texto con el sonido que se está generando. Esta correspondencia es distinta de la alineación previa entre palabras y posiciones de caracteres o fonemas.
Las características acústicas son representaciones intermedias, por ejemplo de aspectos frecuenciales del sonido. Aún no son la señal final que reproduce un altavoz. Un vocoder utiliza esas características para generar la forma de onda de voz y completar el recorrido desde el texto hasta el sonido.
6. El recorrido de un aviso de expedición ficticio
La tienda ya ha decidido comunicar «Su pedido se expedirá mañana». Esa oración constituye la entrada de síntesis. Consultar la fecha real de expedición o comprobar la veracidad del aviso son operaciones ajenas al proceso TTS ilustrado.
Primero se prepara una secuencia de fonemas o caracteres. De la misma oración se obtiene información de palabras y, mediante análisis sintáctico, su organización gramatical. Son representaciones de un único aviso a distintas escalas, no tres mensajes nuevos.
Después se asocian las características léxicas y gramaticales a las posiciones de los fonemas o caracteres correspondientes. Esa base posicional común permite al codificador tratar una unidad de pronunciación junto con la información de su palabra y de la estructura de la oración.
Las características del texto se convierten en características acústicas y el vocoder genera la forma de onda. Al escuchar el resultado, el operador puede valorar la pronunciación de nombres y productos, así como la agrupación de la frase. La ilustración explica el procesamiento; no muestra una pantalla de Azure ni una grabación o medición de un producto real.
7. Azure Speech y el diseño de servicios de voz
Azure Speech de Microsoft ofrece funciones de conversión de texto a voz. La documentación oficial presenta voces neuronales, síntesis mediante SDK y API REST y herramientas para crear contenido de audio. Estas funciones pueden utilizarse para avisos a clientes o lectura de documentos.
El lenguaje de marcado de síntesis de voz, SSML, permite configurar aspectos de la lectura, como la estructura de las oraciones, las pausas, la pronunciación, la velocidad y el tono. Este control de la salida debe distinguirse del procesamiento interno de palabras y oraciones descrito en la patente. La documentación no demuestra que Azure utilice esa arquitectura patentada concreta.
Para el equipo de desarrollo, las diferencias relevantes están en los niveles de entrada y en los puntos de combinación. Conviene documentar si se reciben caracteres o fonemas, si se añaden representaciones aprendidas de palabras, cómo se codifica la gramática y cómo se alinean las secuencias de distinta longitud.
Un documento de diseño resulta más informativo si describe la entrada, las representaciones intermedias, la alineación, la combinación, las características acústicas y la generación de la onda. Afirmar únicamente que la IA lee con naturalidad no identifica el cambio técnico. Ese recorrido permite separar las mejoras de pronunciación de las basadas en información contextual.
Si el objetivo es mejorar la lectura sin alterar el contenido del aviso, el análisis puede comenzar por la forma en que la información de palabras y oraciones llega al modelo de voz. Explicar los pasos entre el texto visible y el resultado audible ofrece una base concreta para comprender la tecnología y examinar sus aspectos de propiedad industrial.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Servicio relacionado: patentes de IA
Conozca la experiencia de IPLEX en patentes de IA y consúltenos sobre las características técnicas de su servicio de voz.
Artículo original en Tistory · Publicación de patente: US12094447B2
Related AI analyses: La patente de traducción visual de Naver: cómo alinear el texto cuando se mueve la cámara · Cómo aborda Baidu los conflictos entre respuestas del modelo y conocimiento recuperado