
Cuando el presupuesto de anotación es reducido, importa tanto qué ejemplos se eligen como cuántos se etiquetan. ActiveLLM encarga la selección a un gran modelo de lenguaje y entrena después un clasificador independiente. La aportación se refiere a la distribución de funciones en el aprendizaje, no a utilizar el LLM para todas las predicciones posteriores.
Arranque en frío y separación de modelos
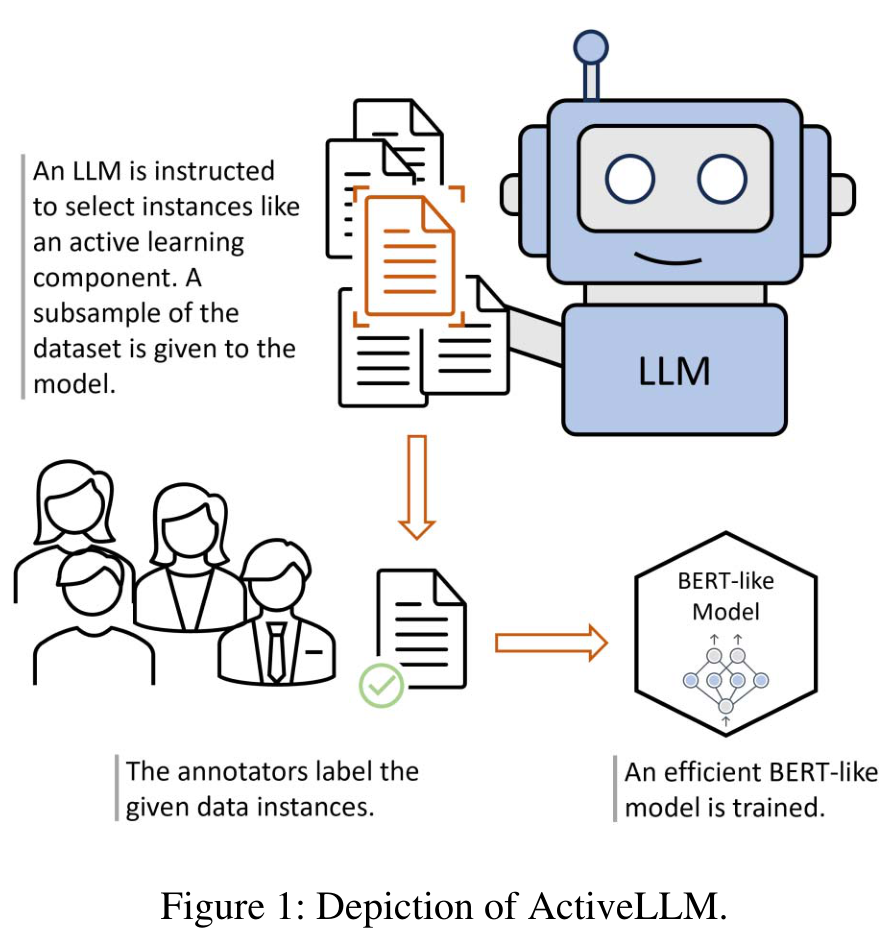
El aprendizaje activo concentra la anotación en ejemplos que pueden aportar más al entrenamiento. Las estrategias basadas en incertidumbre encuentran dificultades al inicio: con pocas etiquetas, el clasificador todavía no estima bien su propia incertidumbre. Reentrenarlo durante la selección también introduce esperas. ActiveLLM utiliza un LLM que sigue instrucciones como modelo de consulta, sin necesitar los parámetros ni las probabilidades del clasificador posterior.
Markus Bayer, Justin Lutz y Christian Reuter, de PEASEC en la Universidad Técnica de Darmstadt, publicaron el trabajo en enero de 2026 en TACL, volumen 14, páginas 1–22, DOI 10.1162/TACL.a.63. Aquí, few-shot significa entrenar el modelo posterior con pocos ejemplos etiquetados; no equivale a incluir unas demostraciones en un prompt de inferencia.
De los candidatos al entrenamiento
El LLM recibe una lista limitada de textos, la función que debe cumplir, el número de ejemplos que seleccionará y el formato de salida. Devuelve identificadores; los ejemplos correspondientes se etiquetan y sirven para entrenar un clasificador de la familia BERT, que se evalúa por separado. El LLM selector no tiene que intervenir en cada clasificación futura.
Presentar 200 candidatos no significa entrenar con 200 ejemplos: la selección puede limitarse a 32. Los experimentos principales muestran 100 o 200 candidatos, no todo el conjunto de datos. Además, las etiquetas existentes simulan al anotador humano. Se evalúa la calidad de selección, sin demostrar que el etiquetado automático sea superior al humano ni que desaparezcan los errores de anotación.
Diseño del prompt y explicaciones
Al seleccionar 32 ejemplos entre 300 candidatos de CTI, el F1 fue 0,6781 con selección aleatoria, 0,7214 con B2 y una instrucción breve de razonamiento por pasos, y 0,6271 con B3, que pedía explicar cada ejemplo. C2, con directrices de anotación, alcanzó 0,7329. Son variantes de la composición del prompt, no una única instrucción que acumula todos los componentes.
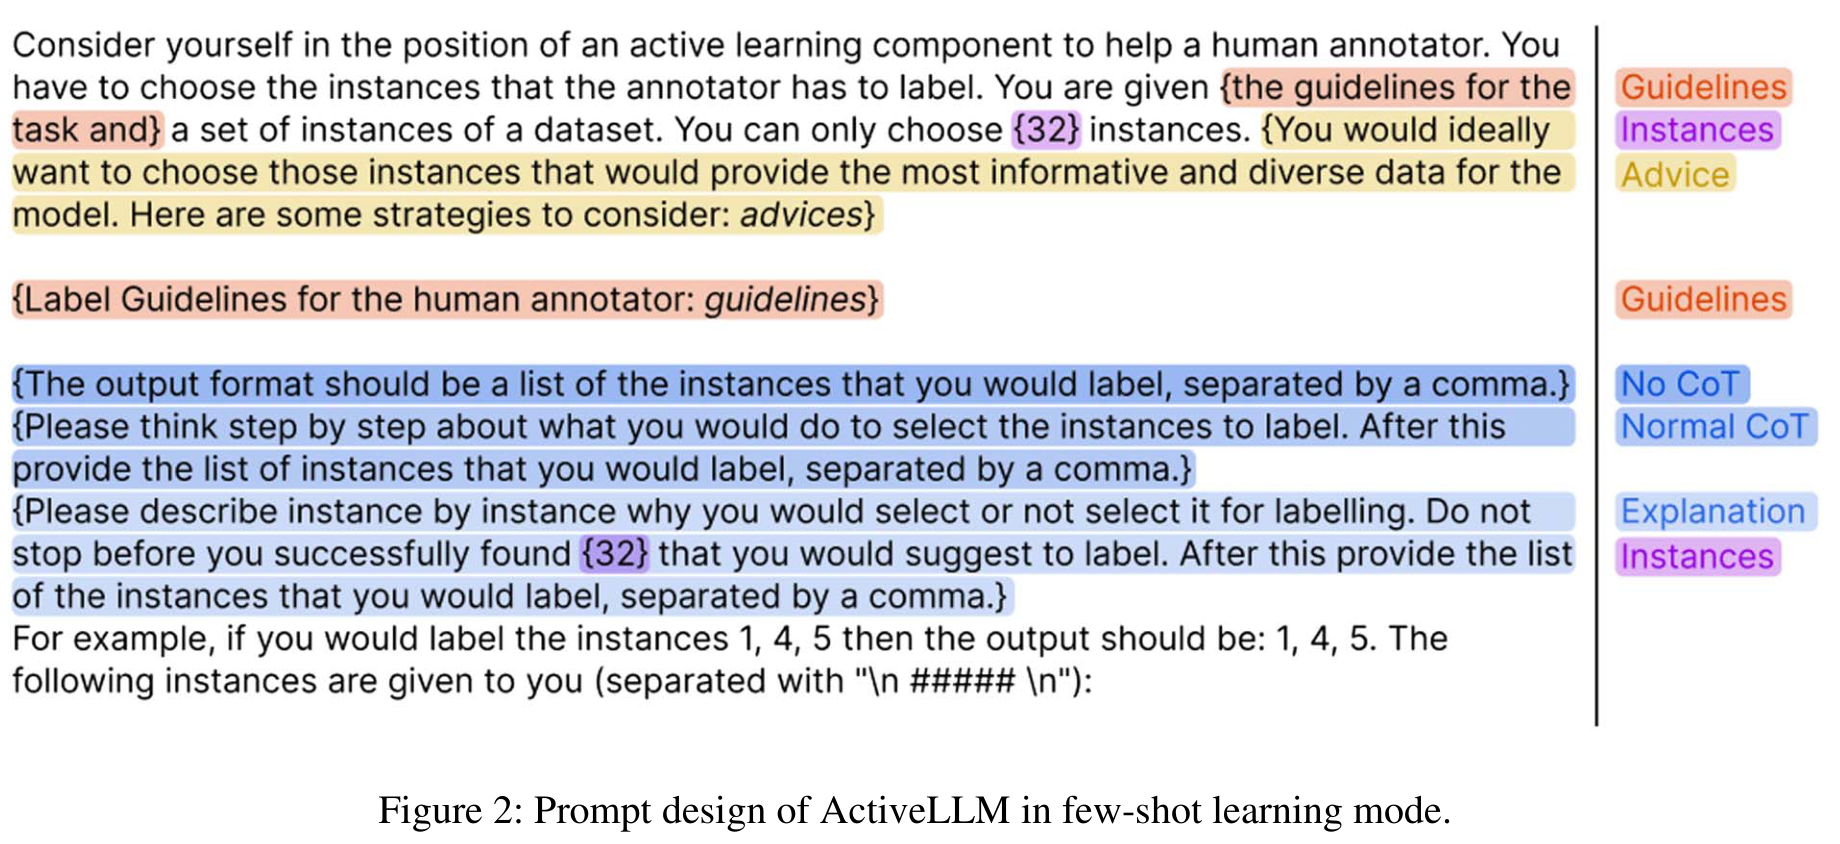
Como muchos conjuntos públicos no incluyen directrices de anotación, la evaluación general utiliza B2 sin consejos adicionales de selección ni esas directrices. Deben quedar claros el objetivo, el número de ejemplos y el formato requerido. Una respuesta más extensa no garantiza una mejor selección, y las explicaciones generadas no acreditan el proceso interno real del modelo.
Condiciones y métricas de evaluación
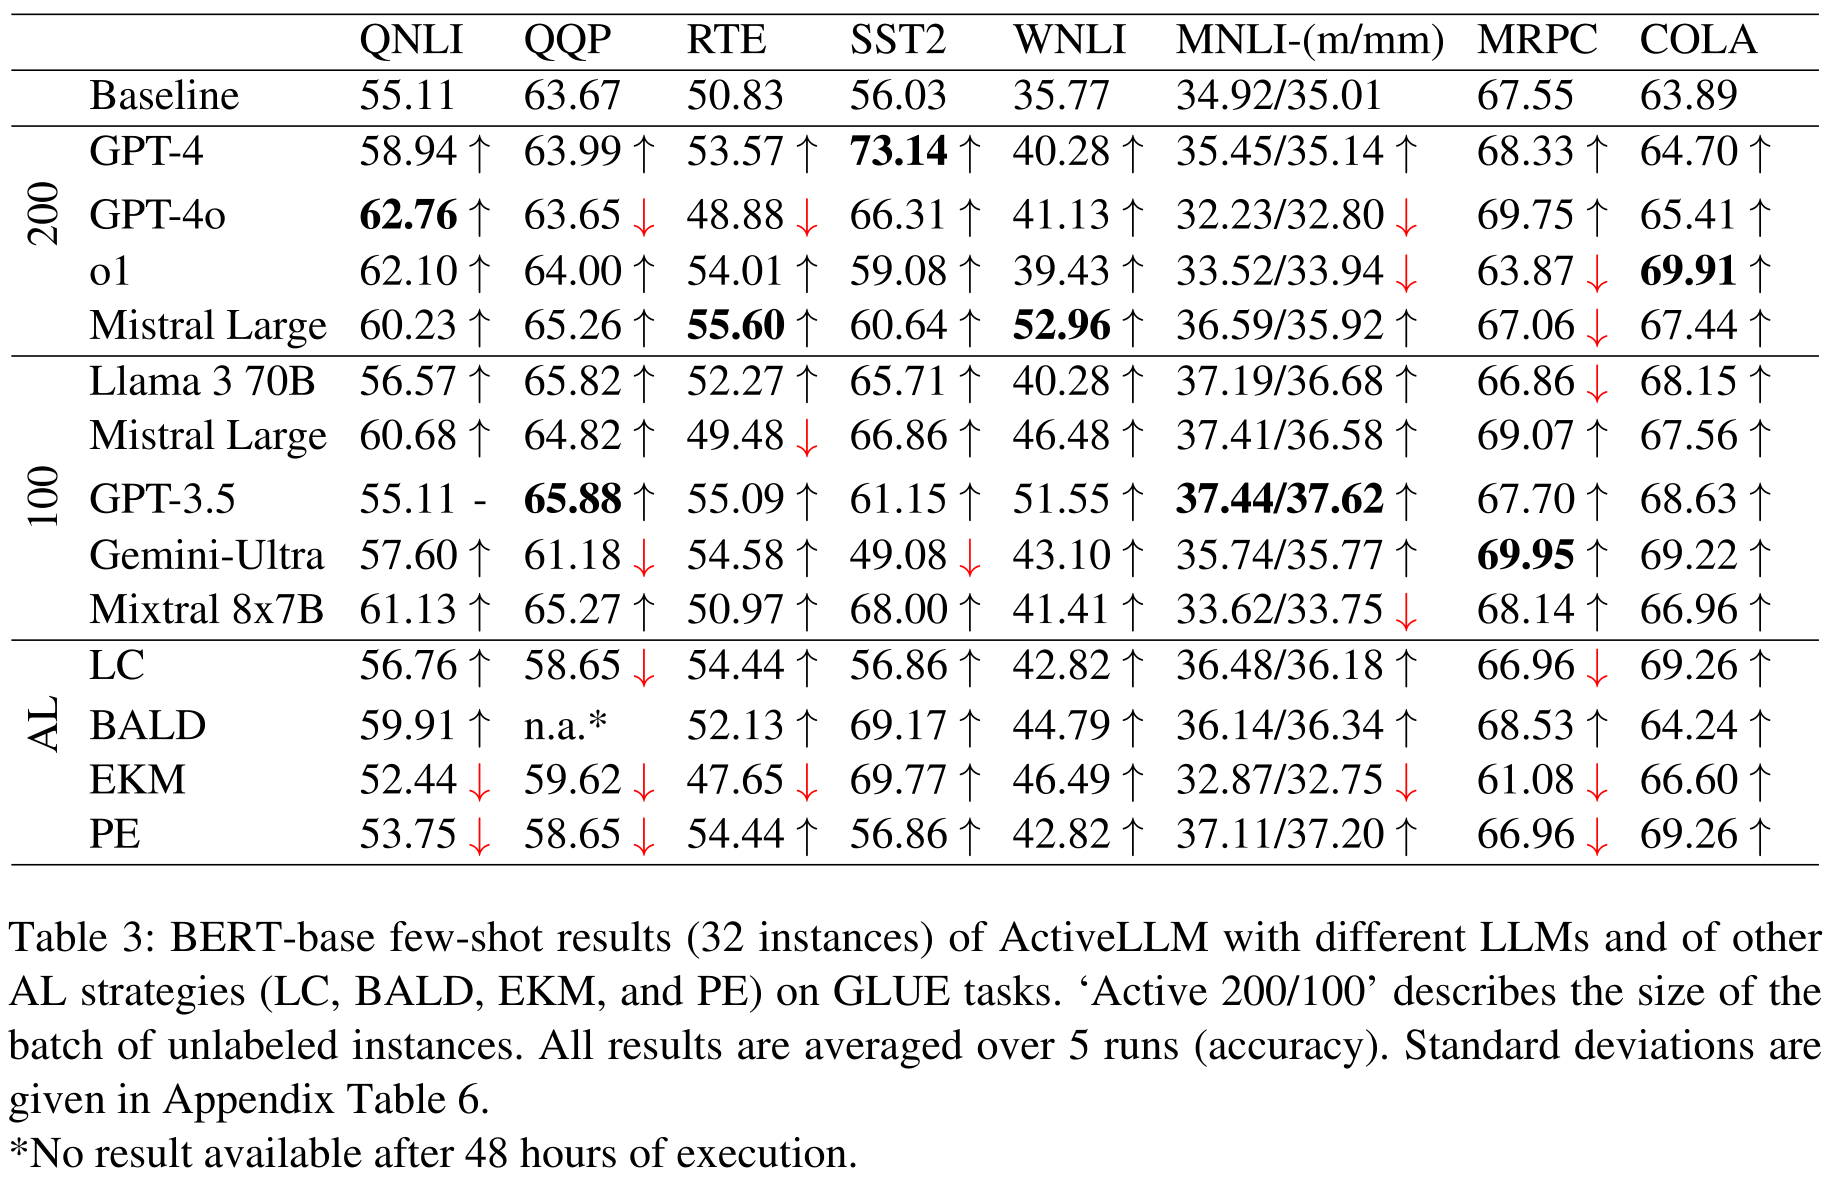
El desarrollo del prompt usa CTI; GLUE aporta tareas de clasificación y relación entre frases. CTI y AG News se evalúan con conjuntos de prueba y GLUE con validación. Las comparaciones de prompts promedian 25 ejecuciones: cinco órdenes de datos y cinco inicializaciones. Los experimentos principales posteriores promedian cinco inicializaciones con un solo orden. La tabla 3 presenta exactitud de BERT-base entrenado con 32 ejemplos, incluida CoLA; no debe confundirse con el F1 de CTI ni con otras métricas habituales de CoLA.
Para 50, 100, 200, 300 y 400 candidatos de CTI, los F1 son 0,7120, 0,7438, 0,7695, 0,7214 y 0,6632, siempre seleccionando 32 ejemplos. Doscientos es el mejor tamaño en ese ensayo, no un óptimo universal. Los métodos convencionales acceden al conjunto completo y repiten entrenamiento y selección; ActiveLLM elige un lote a partir de un subconjunto. Se comparan configuraciones completas, no un único cambio con todas las demás condiciones idénticas.
Mejoras importantes, pero no uniformes
En SST-2, la selección aleatoria obtiene un 56,03% de exactitud y ActiveGPT4 con 200 candidatos un 73,14%: 17,11 puntos porcentuales, no un aumento relativo del 17,11%. En WNLI, Mistral Large alcanza el 52,96% frente al 35,77%, una diferencia de 17,19 puntos. Sin embargo, GPT-4o en RTE queda en el 48,88% frente al 50,83% aleatorio; Gemini Ultra en SST-2, en el 49,08% frente al 56,03%; GPT-3.5 en QNLI iguala el 55,11%.
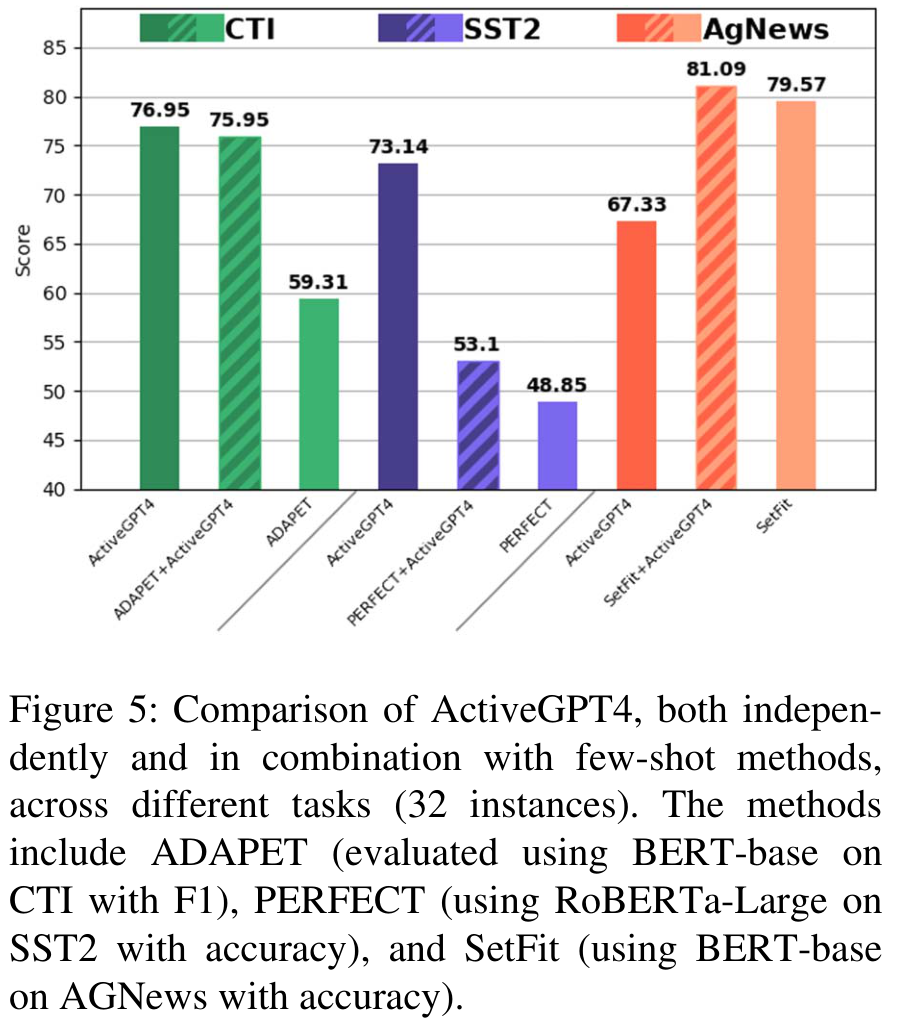
En la figura 5, ActiveGPT4, ADAPET y su combinación obtienen 76,95, 59,31 y 75,95 en CTI, con F1 expresado sobre 100. En SST-2, ActiveGPT4, PERFECT y la combinación alcanzan un 73,14%, 48,85% y 53,10% de exactitud. Las diferencias del método independiente son 17,64 puntos F1 y 24,29 puntos porcentuales. En AG News, SetFit pasa del 79,57% al 81,09% al combinarse, mientras ActiveGPT4 solo logra el 67,33%. ADAPET y SetFit usan BERT-base; PERFECT, RoBERTa-Large. No procede reunir tareas, métricas y arquitecturas diferentes en una sola clasificación.
Tiempo de selección y costes pendientes
La tabla 4 expresa en minutos el tiempo de los métodos convencionales para seleccionar 32 ejemplos en seis iteraciones. BALD no produjo resultado en QQP tras 48 horas; el dato ausente no significa exactitud cero. Al prescindir del reentrenamiento durante la selección y examinar solo un subconjunto, ActiveLLM permite consultas del orden de segundos según el trabajo.
No se ofrece, sin embargo, una comparación controlada de la latencia integral y la facturación API de cada LLM. La tabla no permite calcular un multiplicador preciso de ahorro o velocidad. Una aplicación debe considerar las llamadas, la longitud de entrada, las condiciones de transferencia de datos y el volumen de uso del clasificador posterior.
Más ejemplos y límites de aplicación
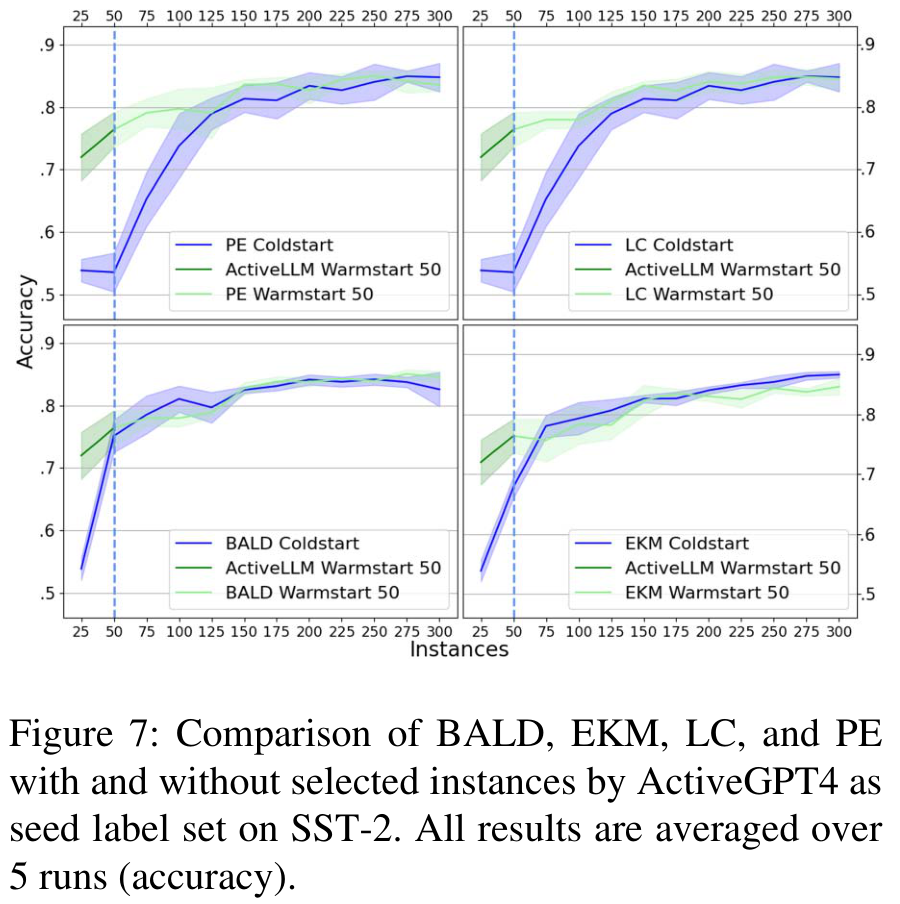
Al seleccionar 25 ejemplos por ronda hasta llegar a 300, la ventaja destaca principalmente por debajo de unos 100; después se aproxima al muestreo aleatorio. Recordar los identificadores ya seleccionados mantiene el historial sin repetir todo el texto. Un conjunto inicial de 50 ejemplos elegidos por ActiveGPT4 mejora LC y PE, pero no reproduce el mismo efecto en EKM y BALD.
La evidencia se centra en clasificadores de la familia BERT y no se generaliza a todo entrenamiento generativo. El prompt se diseñó sobre todo para GPT-4, sin optimizarlo por separado para cada LLM. No se excluye la contaminación de los benchmarks. Textos largos, instrucciones internas del servicio, versiones y configuraciones afectan a la reproducción. Separar el clasificador final tampoco resuelve la confidencialidad del texto enviado al LLM selector.
Lectura técnica desde la práctica de patentes
El problema consiste en seleccionar ejemplos valiosos antes de disponer de un conjunto fiable de etiquetas. El flujo conecta el LLM, el lote de candidatos, las restricciones, los identificadores devueltos, la anotación y el entrenamiento posterior. La separación entre selector y clasificador es central; el tamaño del lote, el formato de identificadores y el recordatorio del historial completan el diseño.
Los efectos dependen del modelo, prompt, conjunto de datos y presupuesto de anotación. Apoyan estudiar el uso de modelos grandes en la selección inicial, dentro de los escenarios evaluados, manteniendo los resultados desfavorables y la reducción de ventajas al crecer los datos. Este análisis de arquitectura no establece novedad ni patentabilidad. La mejora en SST-2 ilustra una contribución concreta, no una promesa universal.
Se conservan las indicaciones y formas originales; el contenido se explica en el texto.
Trabajo analizado: ActiveLLM (TACL 2026)
Conozca la experiencia de Yongduck Kim en IA