
标注预算很少时,选择哪些样本可能与样本数量同样重要。ActiveLLM将选择任务交给大语言模型,再用所选样本的标签训练独立分类器。它讨论的是学习流程的分工,而不是让大模型承担以后每一次预测。
冷启动问题与独立的选择模型
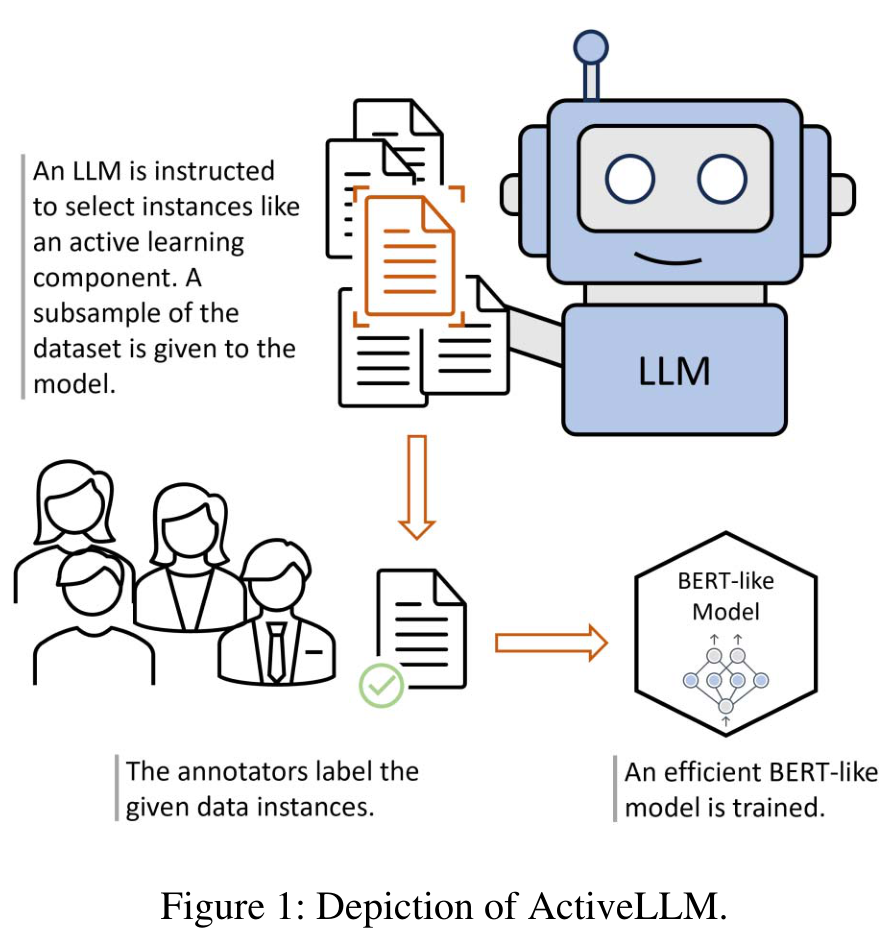
主动学习旨在把标注投入集中到更有训练价值的样本上。传统不确定性策略在初期可能遇到困难:标签太少,分类器本身尚不能可靠判断哪些样本最不确定;选择过程中反复训练也会产生等待。ActiveLLM使用遵循指令的LLM作为查询模型,不依赖后续分类器的内部参数或预测概率。
论文由达姆施塔特工业大学PEASEC的Markus Bayer、Justin Lutz和Christian Reuter撰写,2026年1月发表于TACL第14卷第1—22页,DOI为10.1162/TACL.a.63。这里的少样本是指用少量带标签数据训练后续模型,应与仅在推理提示词中放入几个示例区分。
从候选文本到分类器训练
LLM接收有限的候选列表、选择任务说明、所需样本数和输出格式,并返回样本编号。之后为这些样本提供标签,训练BERT类分类器,再在独立评估数据上测量表现。后续每次分类不必继续调用选择用的LLM。
200个候选与最终选取32个样本是不同概念。主要实验向LLM提供100或200个候选,而非一次输入整个大数据集。实验使用数据集已有的正确标签模拟人工标注,因此检验的是选择质量,不能证明自动标注比人工更准确,也不能证明人工标注错误已经消除。
提示词越详细,选择就越好吗
在CTI中从300个候选选32个样本时,随机选择的F1为0.6781,使用简洁分步思考指令的B2为0.7214,要求逐例说明理由的B3降至0.6271;加入标注指南的C2达到0.7329。这些是改变提示词组成的对照,并非将所有说明同时加入一个提示词。
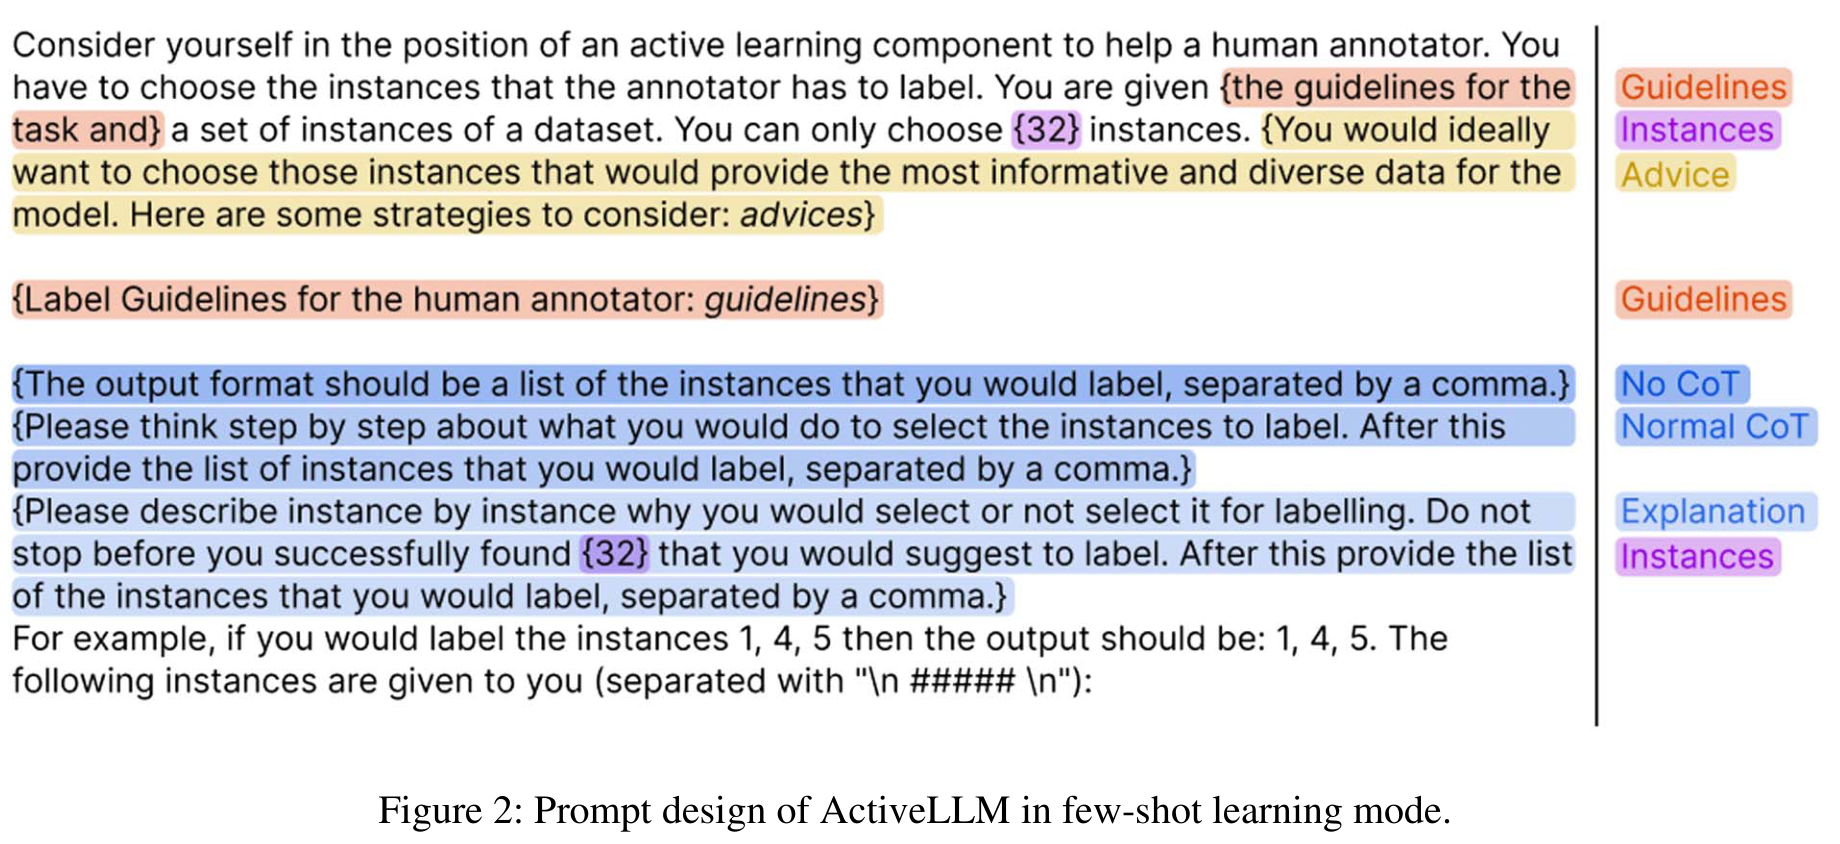
由于公开数据集往往没有可用的标注指南,后续通用评估采用不含额外选择建议和指南的B2。选择数量、任务目标及输出要求需要明确,但较长的回答并不等于更好的选择。模型生成的解释也不能直接视为其内部决策过程的真实记录。
实验预算、数据划分与指标
提示词开发使用CTI,通用文本分类和句对判断使用GLUE;CTI与AG News在测试集评估,GLUE在验证集评估。提示词对比取五种数据顺序和五种模型初始化的25次平均,后续主要实验使用一种顺序和五种初始化。Table 3给出32个样本训练BERT-base后的准确率,其中CoLA也按准确率报告,不能混同CTI的F1或其他资料中的CoLA指标。
候选数量为50、100、200、300、400时,CTI的F1依次为0.7120、0.7438、0.7695、0.7214、0.6632,最终均选32例。200只是该实验中的最佳值。传统主动学习可访问整个候选池并反复训练,而ActiveLLM从子集中一次选取一批样本。因此比较对象是完整配置,并非其他条件完全一致、只替换一个算法的实验。
明显改善与必须保留的反例
SST-2中,随机选择的准确率为56.03%,200候选的ActiveGPT4为73.14%,相差17.11个百分点,不是相对提高17.11%。WNLI中Mistral Large为52.96%,比35.77%高17.19个百分点。但GPT-4o的RTE为48.88%,低于随机的50.83%;Gemini Ultra的SST-2为49.08%,低于56.03%;GPT-3.5的QNLI则同为55.11%。
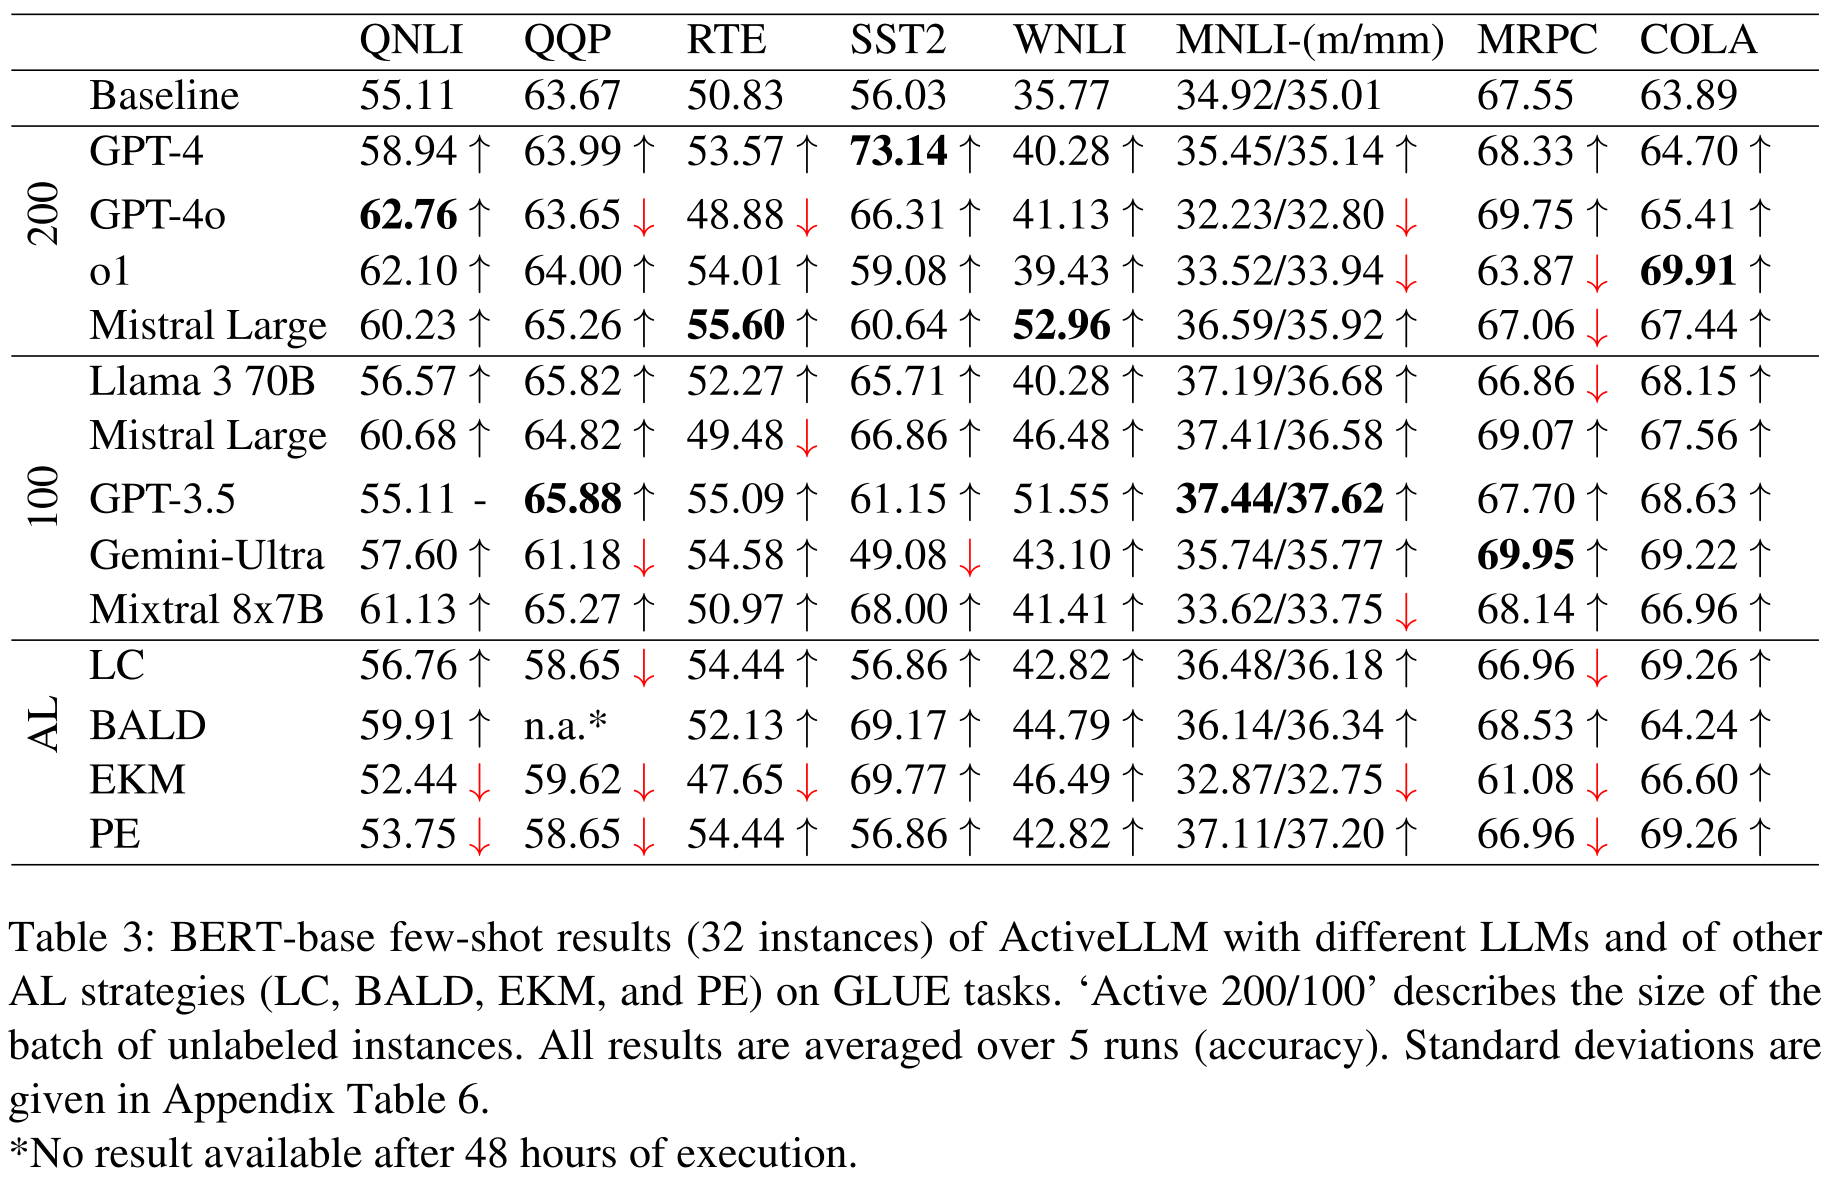
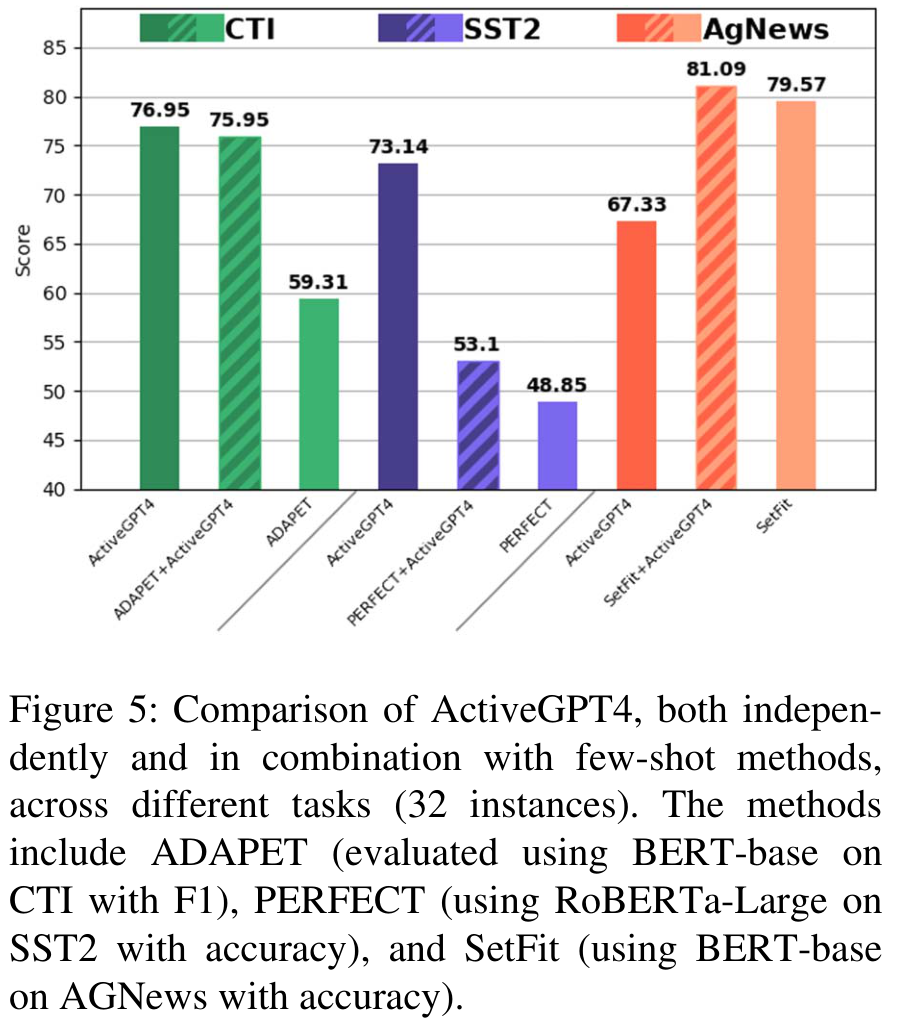
Figure 5中,CTI上的ActiveGPT4、ADAPET及组合分别为76.95、59.31、75.95(F1乘100);SST-2上的ActiveGPT4、PERFECT及组合准确率分别为73.14%、48.85%、53.10%。单独选择方式相对对应方法的差值是17.64个F1点和24.29个百分点。AG News中,SetFit从79.57%提高到组合后的81.09%,而ActiveGPT4单独为67.33%。ADAPET、SetFit使用BERT-base,PERFECT使用RoBERTa-Large,不同任务、指标和架构不能合并为统一排名。
选择耗时与仍然存在的成本
Table 4以分钟列出传统策略经过六轮主动学习选择32例所需的时间。BALD在QQP上运行48小时仍未得到结果,因此该项缺失,并不代表准确率为零。ActiveLLM省去选择阶段的反复训练,只检查部分候选,论文报告其查询耗时可达数秒级。
但这不是在相同条件下逐一列出各LLM端到端延迟和API费用的完整成本表,不能据此计算确切的提速或降本倍数。实际部署还需考虑调用收费、输入长度、数据传输条件及后续分类器的使用量。
样本增加后的表现及适用边界
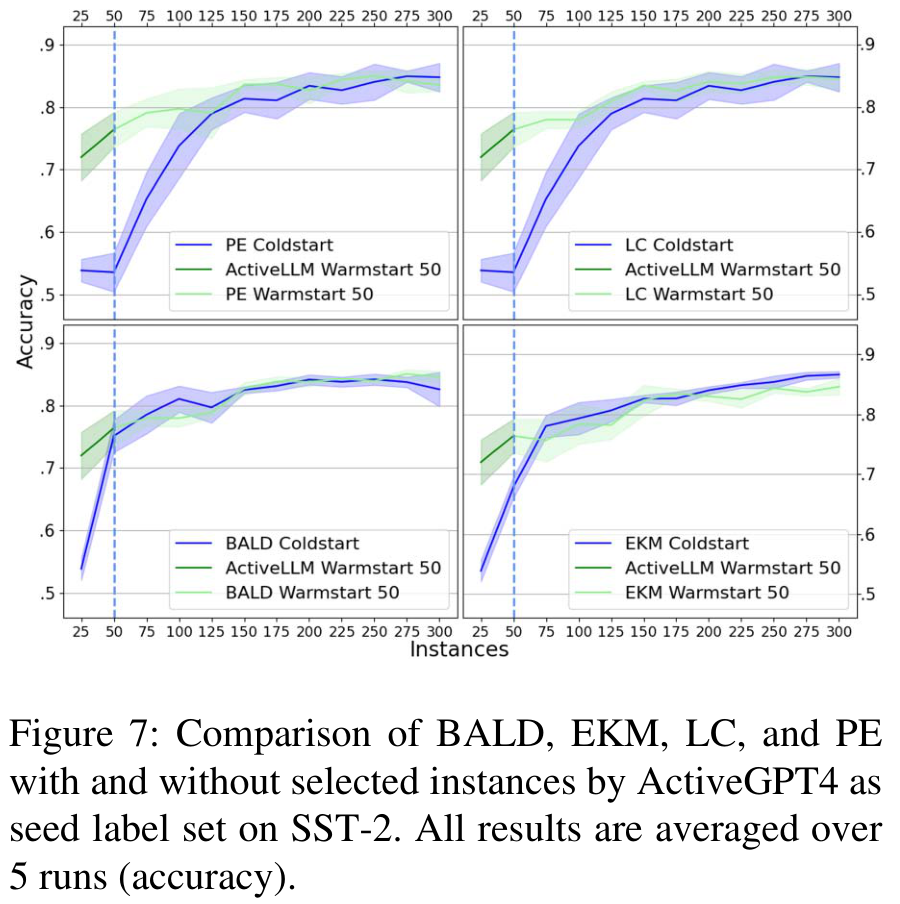
每轮选择25例、累计到300例的实验中,优势主要出现在约100例以下,之后逐渐接近随机选择。再次提供已选样本编号,可以在不重复全文的情况下保留历史。用ActiveGPT4选择最初50例有助于LC和PE,但EKM与BALD没有重现同样收益。
实验主要针对BERT类分类器,不能推广到所有生成模型训练。提示词主要围绕GPT-4设计,并非对每个LLM分别优化;也不能完全排除公开基准进入预训练数据的可能。长候选文本、服务隐藏指令、模型版本和设置影响可复现性。即使后续分类器独立运行,向选择LLM传输原文仍涉及保密问题。
从专利分析角度理解技术结构
技术问题是在缺少可靠标注集的初始阶段选出高价值样本。信息流包括向指令型LLM提供候选批次和选择条件、接收样本标识,再连接标注与后续训练。选择器与训练对象的分离是核心,候选规模、编号格式及历史提示则是相关设计要素。
观察到的效果取决于模型、提示词、数据和标注预算的组合。研究支持在特定少样本任务中利用大模型选择数据,同时必须保留性能下降的组合和样本增多后收益缩小的结果。该结构分析不等于认定技术具有专利新颖性或可专利性,SST-2的改进也不是普遍性能承诺。
图中保留原始标注与形态,相关内容在正文中说明。