
少数の例しかラベル付けできない場合、例の数だけでなく何を選ぶかが学習結果を左右します。ActiveLLMは大規模言語モデルに選択を任せ、選んだ例にラベルを付けて別の分類器を学習させます。大規模モデルを学習工程のどこに配置するかを考える研究です。
コールドスタートと選択モデルの分離
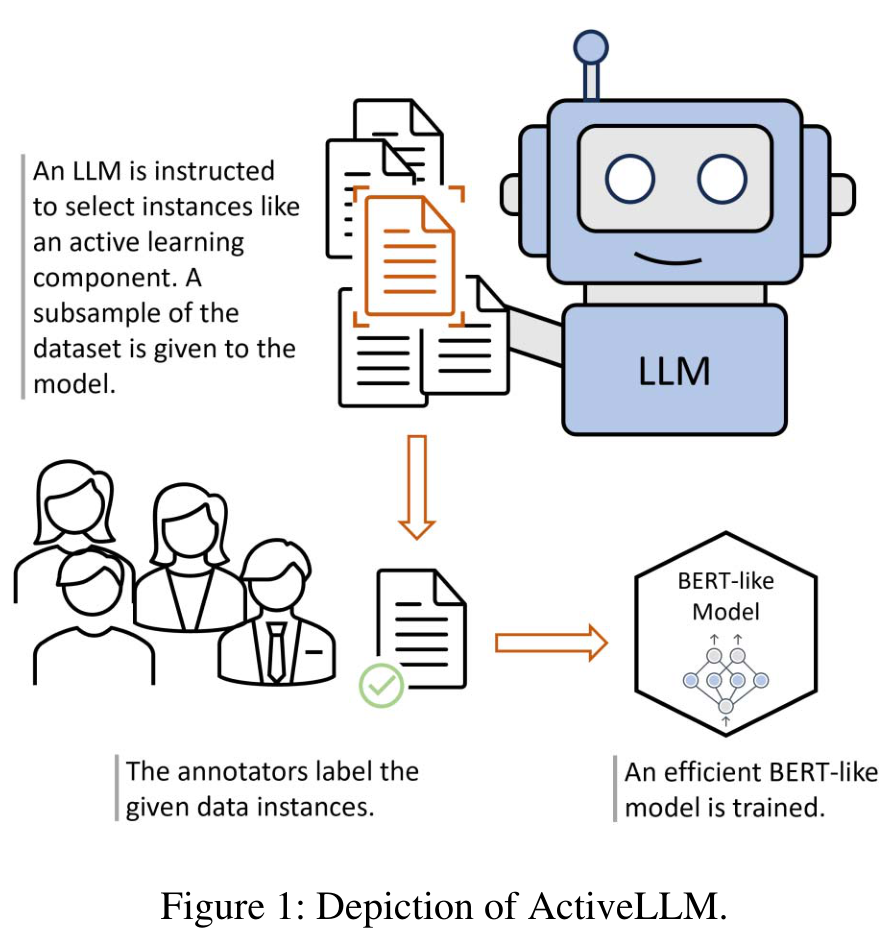
能動学習は、学習に役立つと見込まれる例へアノテーションを集中させます。ただし、不確実性に基づく従来手法は、初期のラベル付きデータが乏しいと分類器の判断自体が不安定になります。選択中の反復学習も待ち時間を生みます。ActiveLLMは指示に従うLLMを選択モデルとして用い、後段の分類器のパラメータや予測確率を必要としません。
対象論文はダルムシュタット工科大学PEASECのMarkus Bayer、Justin Lutz、Christian Reuterによるもので、2026年1月にTACL第14巻1~22頁へ掲載されました(DOI 10.1162/TACL.a.63)。ここでのfew-shotは、少数のラベル付き例による後段モデルの学習を指し、推論用プロンプトに例を並べることとは区別されます。
候補の提示から分類器の学習まで
LLMには候補文の一覧、選択の役割、必要な例の数、出力形式を提示します。返された識別番号に対応する例へラベルを付け、BERT系の分類器を学習させ、別の評価データで測定します。その後の分類を毎回LLMに依頼する構成ではありません。
候補200例と選択32例は別の数値です。主要実験では100例又は200例を提示し、データセット全体を一括入力しません。また、人のアノテーションは既存データの正解ラベルで模擬されています。示されたのは選択の質であり、LLMによる自動ラベル付けが人より正確だとか、人の誤りがなくなるという結果ではありません。
詳しい説明を求めればよいのか
CTIで候補300例から32例を選んだ比較では、無作為選択のF1は0.6781、簡単な段階的思考を促すB2は0.7214でした。例ごとの理由を求めるB3は0.6271に下がり、ラベル付け指針を加えたC2は0.7329となりました。これは指示の構成を変えた比較であり、すべての説明を一つに盛り込んだ実験ではありません。
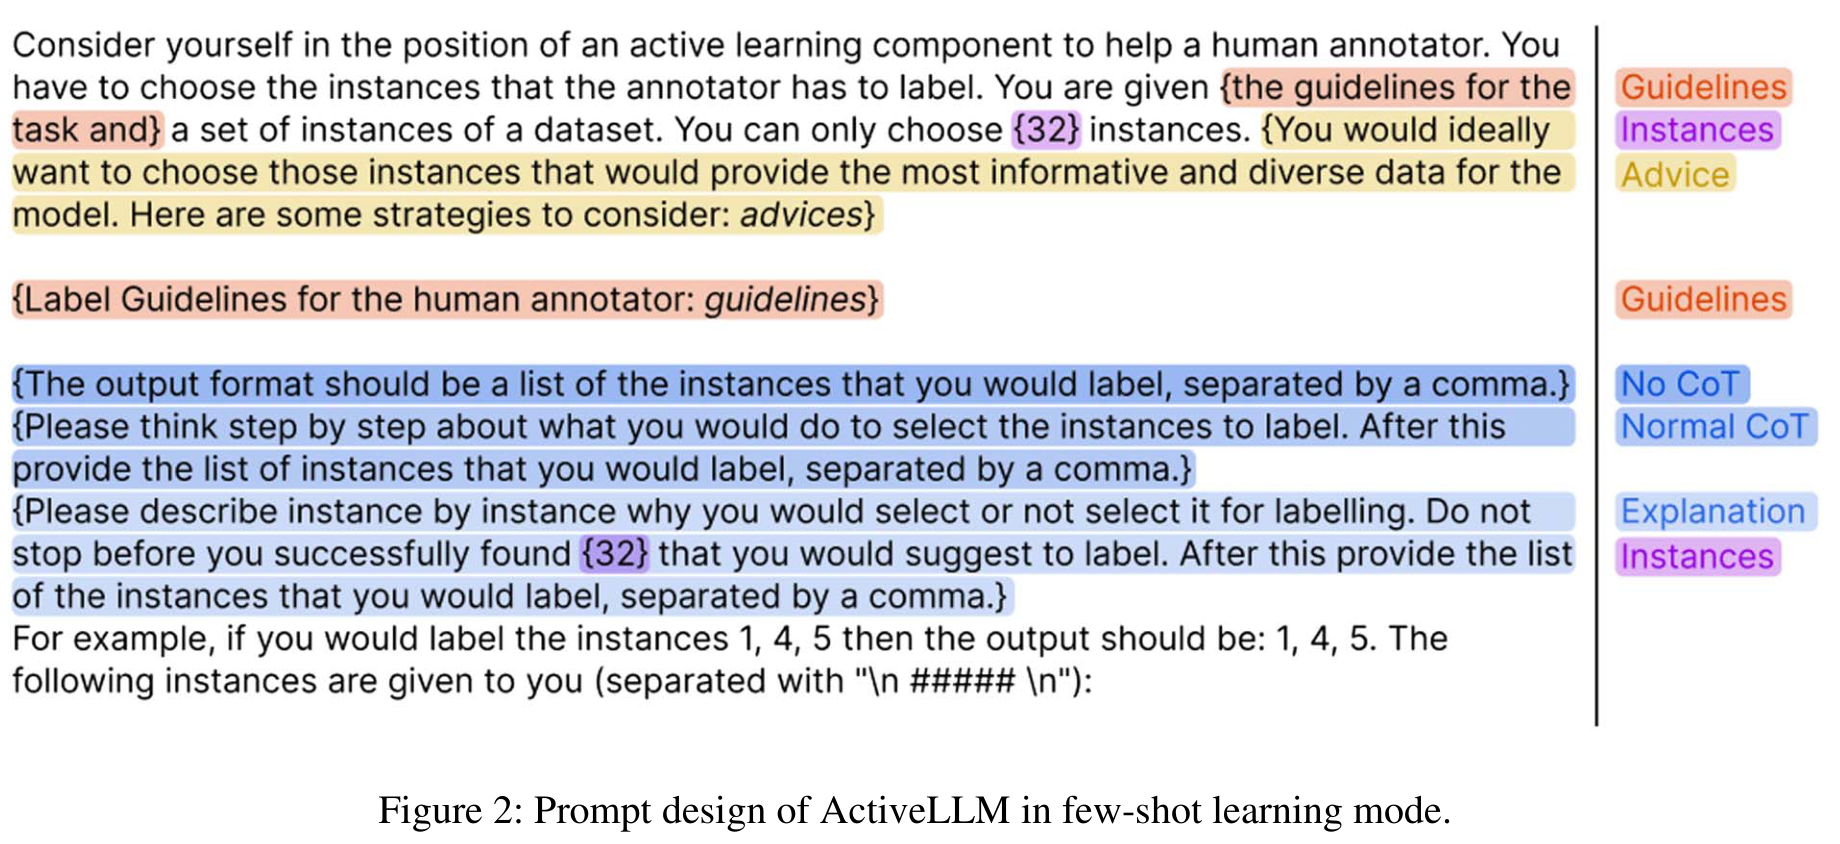
一般の公開データセットでは指針を得られないことも多いため、後続評価では追加助言と指針を除くB2を採用しています。選択数と出力条件を明確にすることは重要ですが、長い説明がよい選択を保証するわけではありません。生成された理由を内部の判断過程そのものと見なすこともできません。
評価条件と指標を分けて読む
プロンプト開発にはCTI、一般的な文分類・文対判定にはGLUEを用い、CTIとAG Newsはテストセット、GLUEは検証セットで評価しました。プロンプト比較はデータ順序5通りと初期値5通りの25回平均、主要な後続実験は一つの順序と5初期値の平均です。Table 3は32例で学習したBERT-baseの正解率で、CoLA列もこの論文では正解率です。CTIのF1や他のCoLA報告と混同できません。
CTI候補数50・100・200・300・400に対するF1は順に0.7120・0.7438・0.7695・0.7214・0.6632で、選択数はいずれも32です。200例が最良なのはこの実験条件に限られます。従来の能動学習は全候補へアクセスして学習を繰り返す一方、ActiveLLMは一部候補から一括選択します。構成全体の比較であり、単一要素だけを同条件で置き換えた実験ではありません。
大きな改善と改善しない組合せ
SST-2では無作為選択56.03%に対し、候補200例のActiveGPT4は73.14%で、差は17.11パーセントポイントです。17.11%の相対改善ではありません。WNLIのMistral Largeは52.96%で、35.77%に対し17.19ポイント高い一方、GPT-4oのRTEは48.88%対50.83%、Gemini UltraのSST-2は49.08%対56.03%と低下し、GPT-3.5のQNLIは55.11%で同率でした。
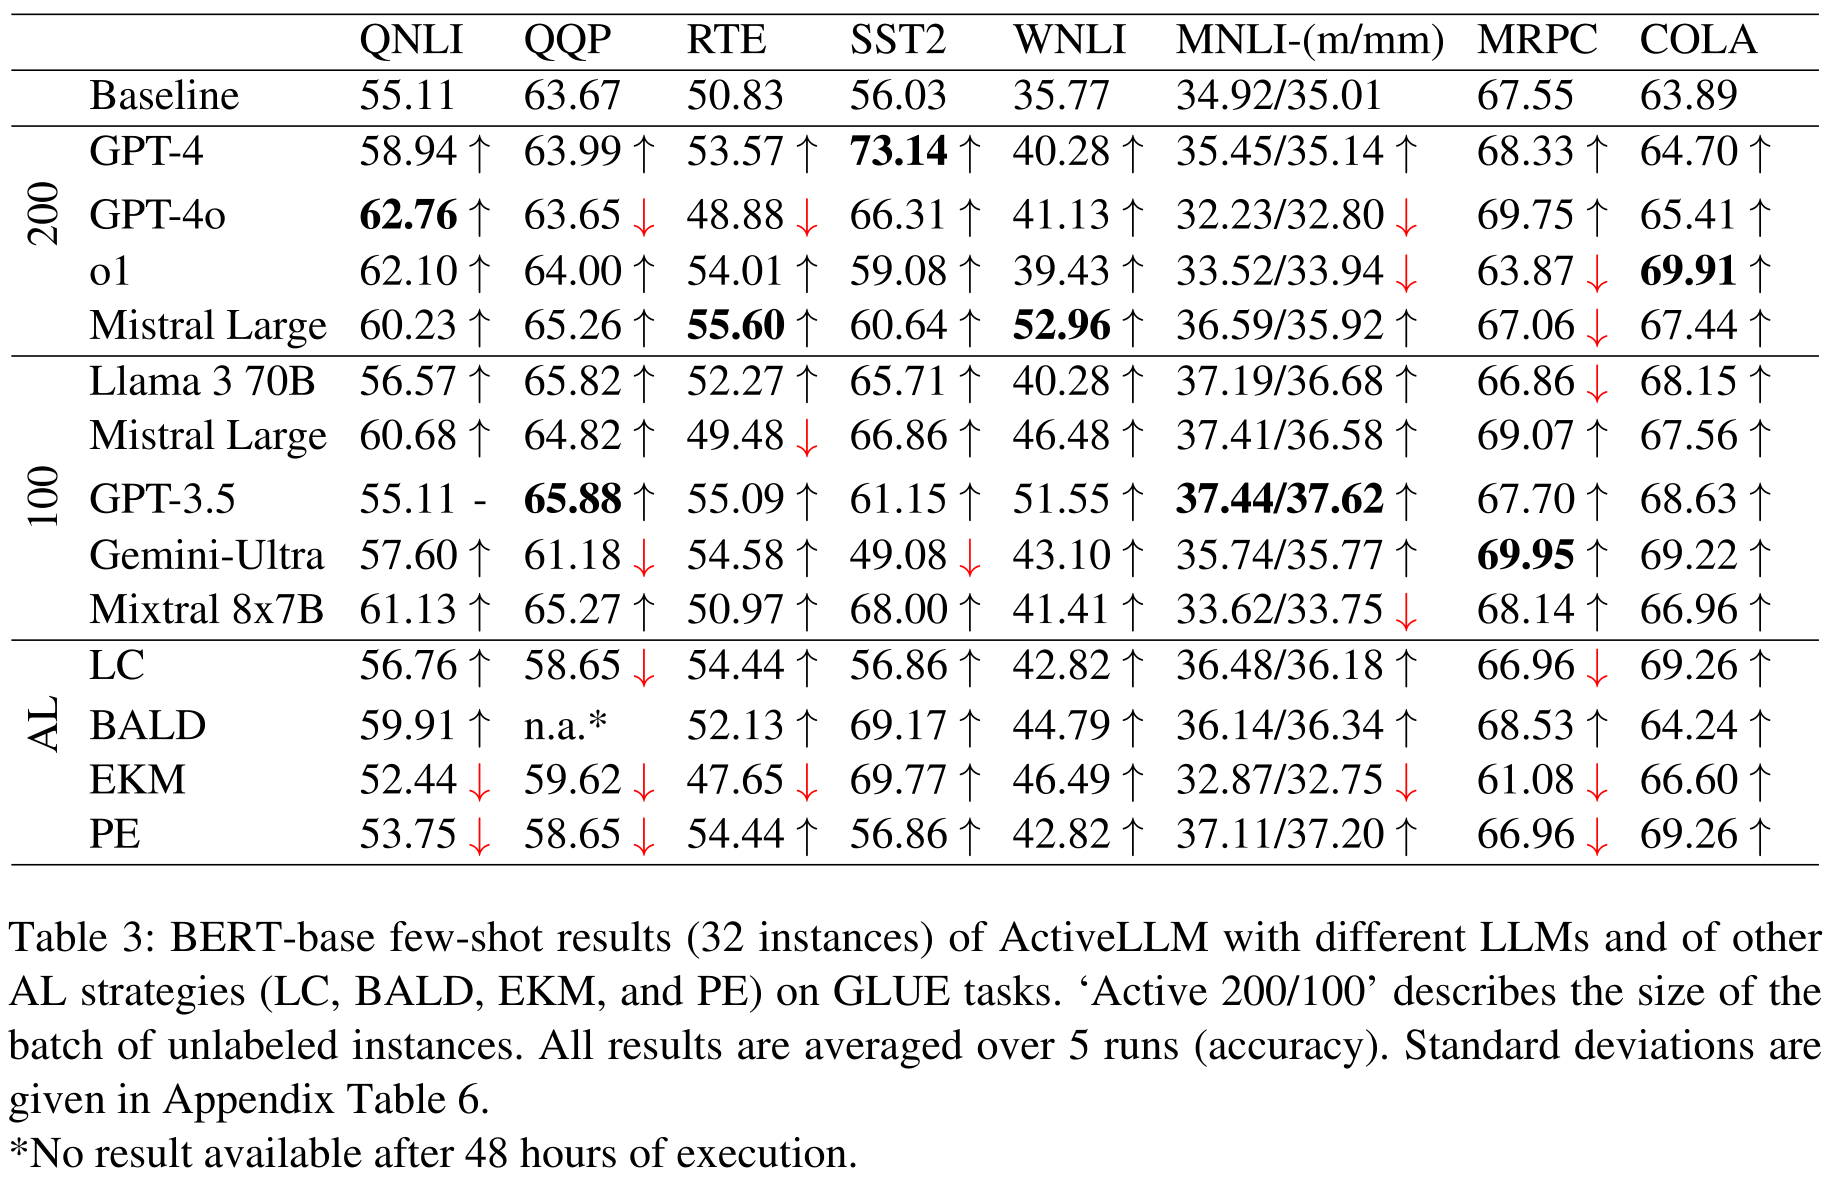
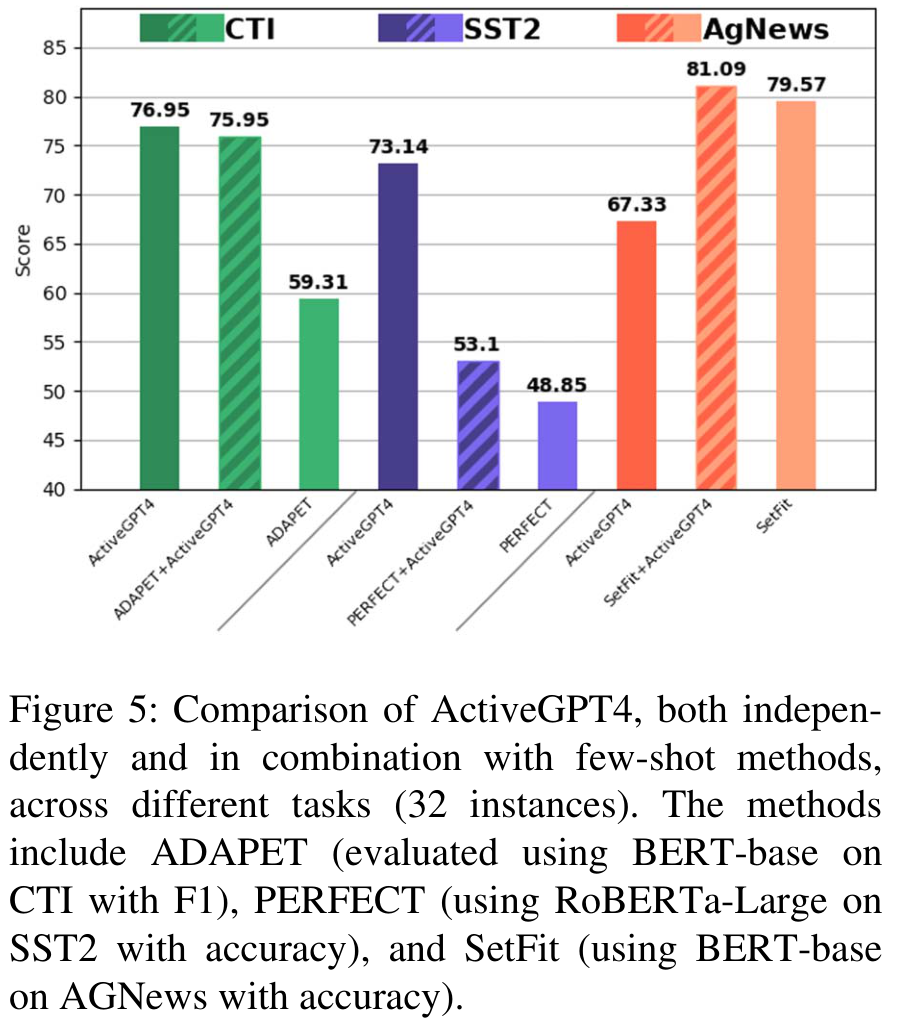
Figure 5のCTIではActiveGPT4・ADAPET・結合型が100点換算のF1で76.95・59.31・75.95、SST-2ではActiveGPT4・PERFECT・結合型の正解率が73.14%・48.85%・53.10%です。単独方式との差は17.64 F1点、24.29パーセントポイントです。AG NewsではSetFit79.57%が結合で81.09%となり、ActiveGPT4単独は67.33%でした。ADAPETとSetFitはBERT-base、PERFECTはRoBERTa-Largeを使うため、課題・指標・モデルを無視した一つの順位表にはできません。
選択時間と残る費用
Table 4は従来手法が6回の能動学習反復で32例を選ぶまでの時間を分単位で示します。BALDのQQPでは48時間でも結果が得られず欠測となっていますが、正解率ゼロという意味ではありません。ActiveLLMは選択中の反復学習を省き、一部候補のみを検討することで数秒程度の問い合わせ時間を報告しています。
ただし、各LLMの全処理時間とAPI料金を同一条件で並べた費用比較ではありません。この表だけから正確な高速化率や費用削減倍率を算出することはできません。実装では呼出し料金、入力長、データ送信条件、後段分類器の利用量を合わせて検討する必要があります。
例を増やした場合と実用上の限界
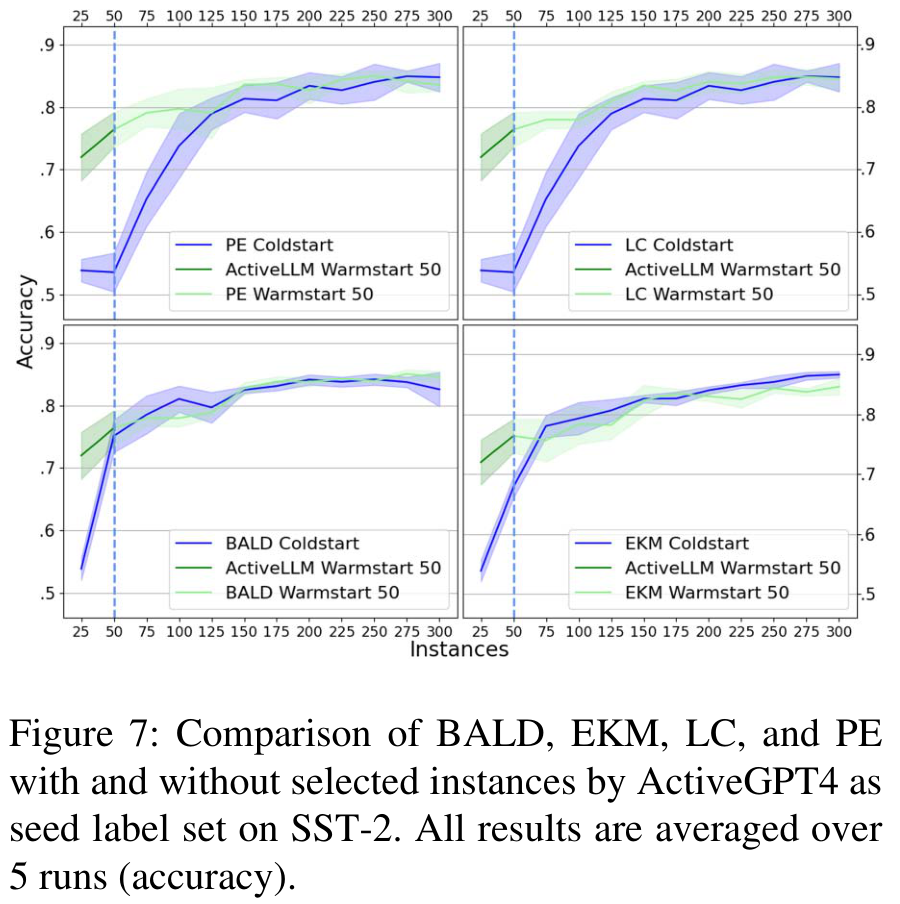
1回25例、最大300例まで選ぶ実験では、おおむね100例以下で利点が目立ち、その後は無作為選択に近づきました。既選択例の番号を再提示する方法は、全文を繰り返さず履歴を保つ手段です。最初の50例をActiveGPT4で選ぶ初期化はLCとPEを改善しましたが、EKMとBALDでは同じ効果を再現していません。
主な対象はBERT系分類器であり、生成モデルのすべての学習へ一般化はできません。プロンプトは主にGPT-4向けに設計され、モデルごとに最適化した比較ではありません。ベンチマークの学習データ混入、長い候補文、サービス内の非公開指示、モデル版や設定も再現性に関係します。後段モデルを分離しても、選択LLMへ送る原文の機密性が解決するわけではありません。
特許分析で着目する情報の流れ
技術的課題は、十分な正解データがない初期段階で学習価値の高い例を選ぶことです。候補群と選択条件をLLMへ与え、返された識別番号をラベル付けと後段学習へ接続します。選択モデルと学習対象モデルの分離を中心に、候補数、番号形式、過去の選択履歴の提示が組み合わされています。
効果はモデル、プロンプト、データ、ラベル数に依存します。特定の少数例分類での改善と、大規模モデルをデータ選択へ配置する設計上の示唆を読み取れますが、失敗した条件やデータ増加後の利点の縮小も残ります。この構成分析は新規性や特許性を確定するものではなく、SST-2の改善も普遍的な性能保証ではありません。
原図の表記と形状を保持しています。資料の内容は本文で説明しています。