
При небольшом бюджете разметки важны не только количество, но и состав примеров. ActiveLLM поручает выбор большой языковой модели, а затем обучает отдельный классификатор на отобранных размеченных данных. Работа посвящена распределению ролей в обучении, а не обязательному использованию LLM для каждого последующего предсказания.
Холодный старт и отдельная модель отбора
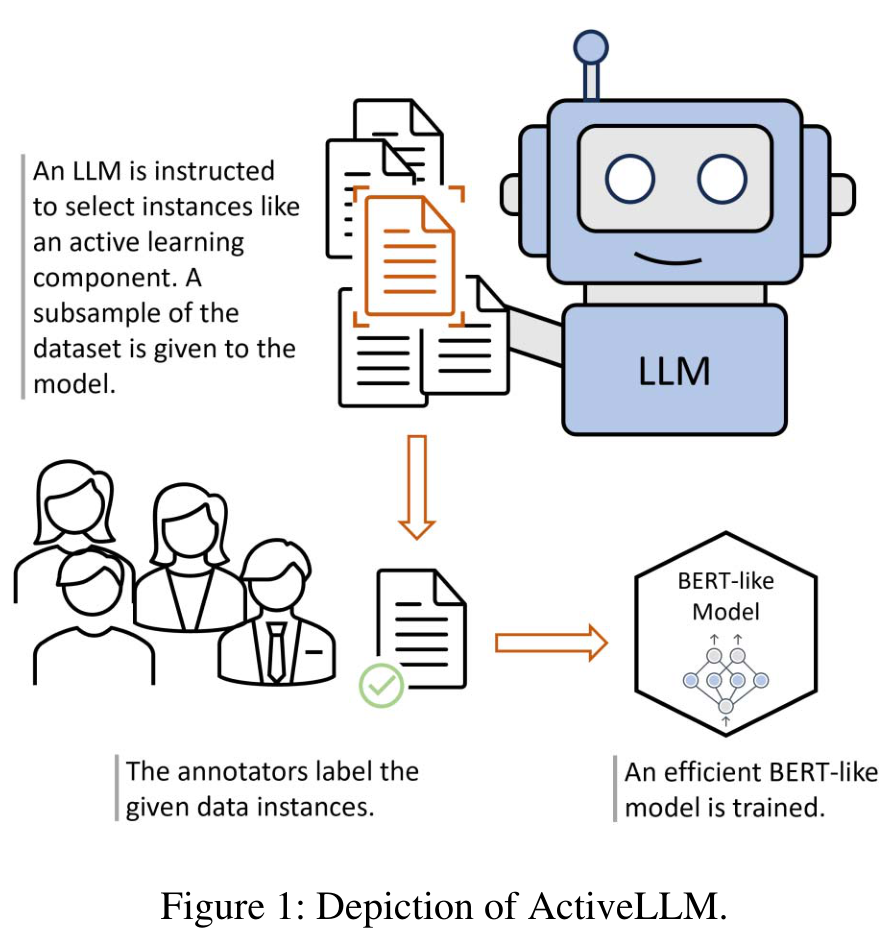
Активное обучение направляет усилия разметчиков на наиболее полезные для обучения примеры. Однако оценка неопределенности на старте ненадежна, если у классификатора еще мало размеченных данных. Повторное обучение во время отбора также создает задержки. ActiveLLM применяет LLM, следующую инструкциям, как модель запросов и не требует доступа к параметрам или вероятностям последующего классификатора.
Работа Markus Bayer, Justin Lutz и Christian Reuter из PEASEC Дармштадтского технического университета опубликована в январе 2026 года в TACL, том 14, с. 1–22, DOI 10.1162/TACL.a.63. Под few-shot здесь понимается обучение последующей модели на небольшом размеченном наборе, а не только включение нескольких демонстраций в запрос при выводе.
От списка кандидатов к классификатору
LLM получает ограниченный список текстов, описание задачи отбора, необходимое число примеров и формат ответа. Она возвращает идентификаторы; выбранные тексты размечаются и используются для обучения классификатора типа BERT, который оценивается отдельно. При дальнейшей классификации обращаться к модели отбора каждый раз не требуется.
Двести кандидатов и 32 выбранных примера обозначают разные величины. В основных экспериментах показываются 100 или 200 кандидатов, а не весь корпус. Роль человека-разметчика моделируется готовыми правильными метками набора данных. Поэтому проверяется качество отбора, а не превосходство автоматической разметки над человеческой или устранение ошибок разметчиков.
Инструкции и подробность объяснений
При выборе 32 примеров из 300 кандидатов CTI значение F1 составило 0,6781 для случайного отбора, 0,7214 для B2 с простой пошаговой инструкцией и 0,6271 для B3, требующего объяснить каждый пример. Вариант C2 с руководством по разметке достиг 0,7329. Сравнивались разные составы запроса, а не одна инструкция, объединяющая все возможные указания.
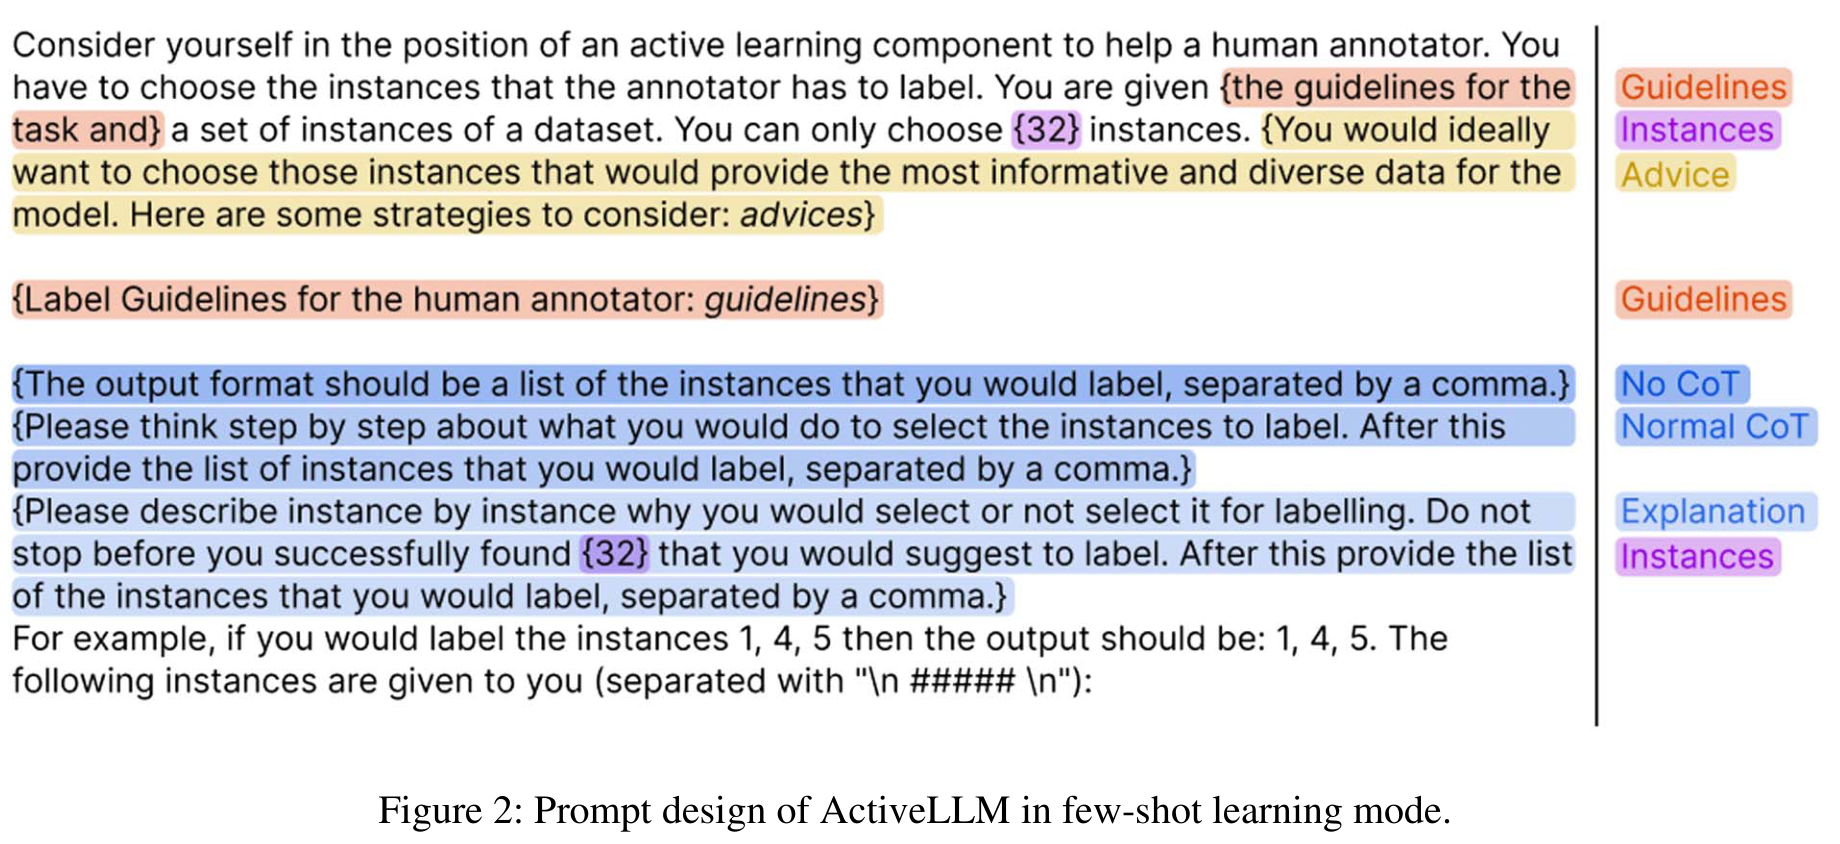
Поскольку общедоступные наборы часто не содержат руководств по разметке, дальнейшая общая оценка использует B2 без дополнительных советов и руководства. Цель, число примеров и формат должны быть понятны, но более длинный ответ не гарантирует лучший отбор. Сгенерированные объяснения также не доказывают, что именно так проходило внутреннее рассуждение модели.
Условия экспериментов и метрики
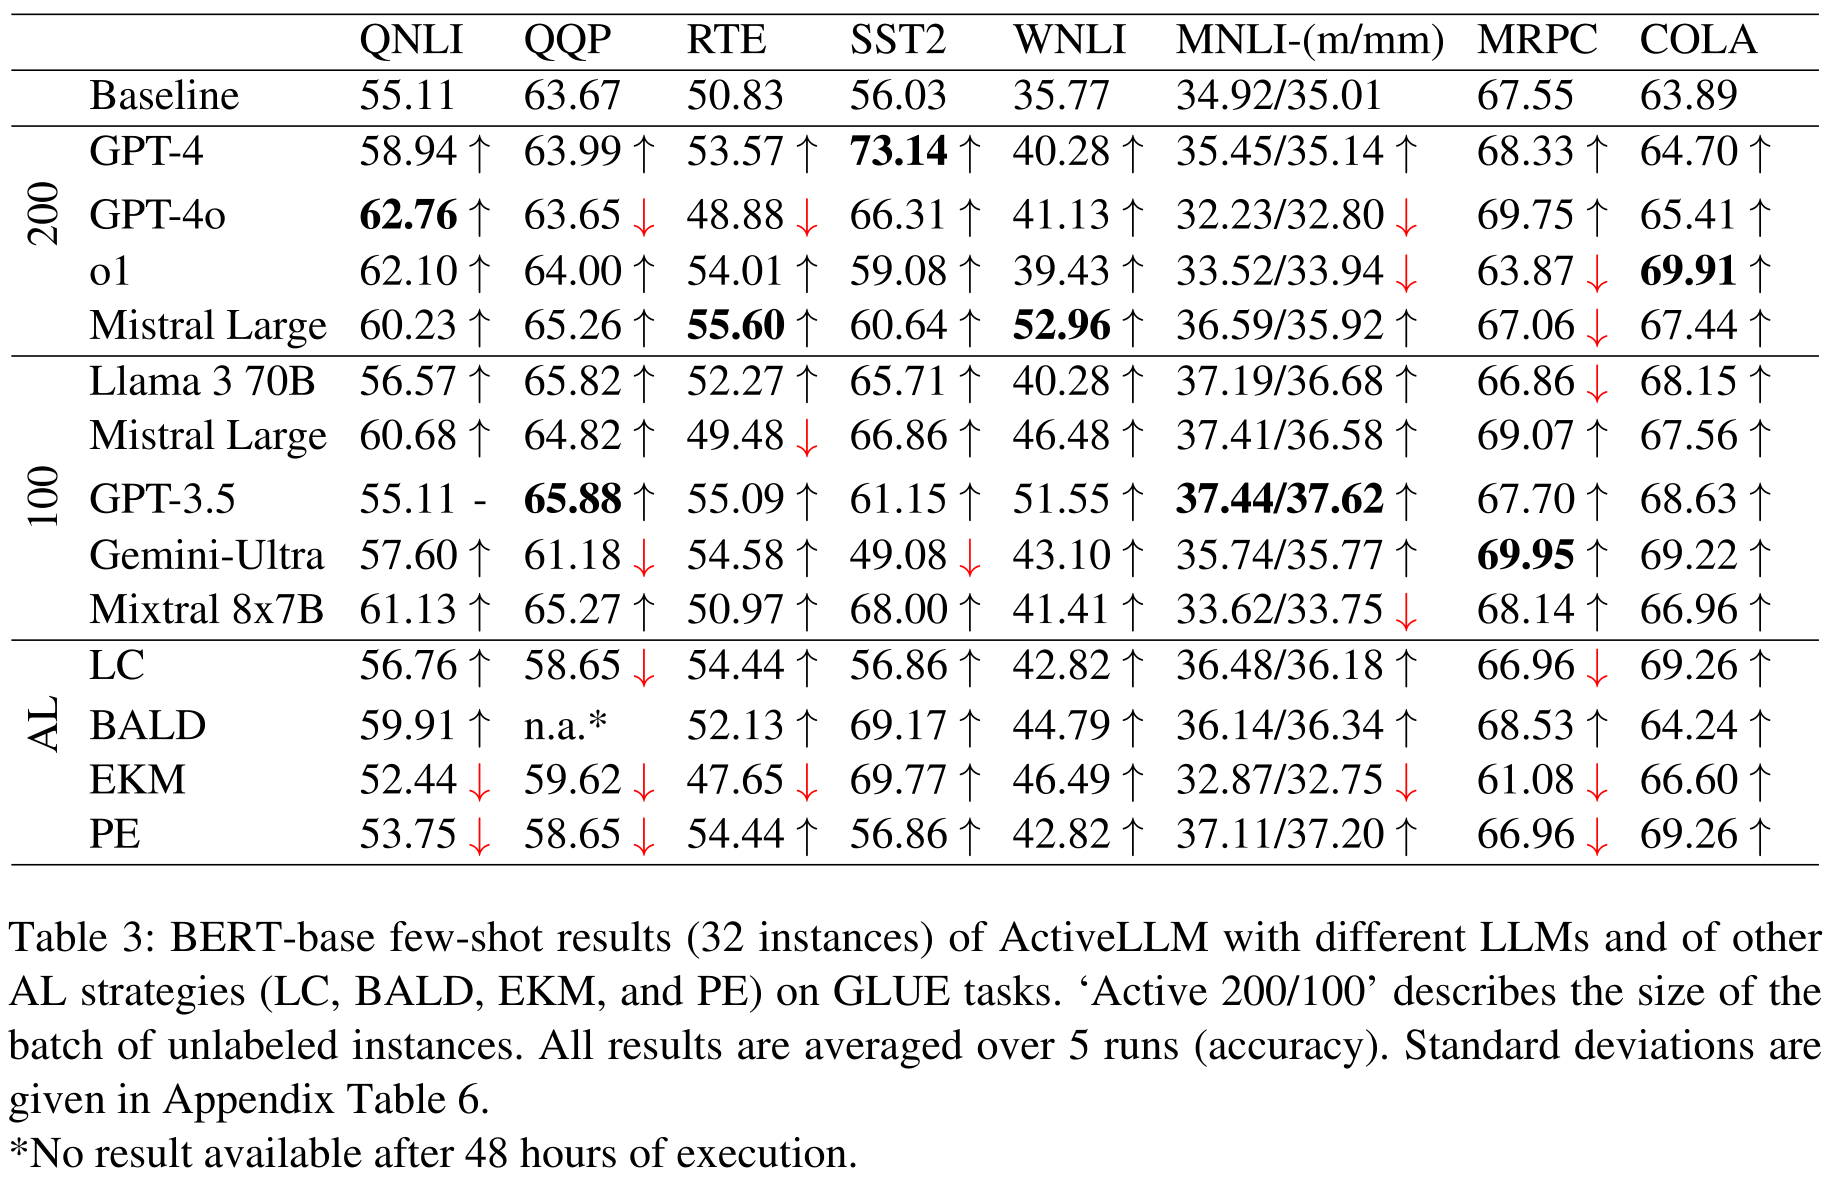
Запрос разрабатывался на CTI, а GLUE использовался для классификации и сопоставления предложений. CTI и AG News оценивались на тестовых данных, GLUE — на валидационных. Сравнение запросов усредняет 25 запусков: пять порядков данных и пять инициализаций. Основные дальнейшие результаты усредняют пять инициализаций при одном порядке. Таблица 3 показывает долю правильных ответов BERT-base после обучения на 32 примерах, включая CoLA; ее нельзя смешивать с F1 на CTI или привычными метриками CoLA в других работах.
Для 50, 100, 200, 300 и 400 кандидатов CTI получены F1 0,7120, 0,7438, 0,7695, 0,7214 и 0,6632 при неизменном отборе 32 примеров. Двести кандидатов оптимальны лишь в этом опыте. Традиционные стратегии обращаются ко всему пулу и повторяют обучение, тогда как ActiveLLM выбирает пакет из подмножества. Сопоставляются целые конфигурации, а не единственный измененный алгоритм при полностью одинаковых остальных условиях.
Выигрыши и отрицательные результаты
На SST-2 случайный отбор дает 56,03%, а ActiveGPT4 с 200 кандидатами — 73,14% правильных ответов: разница 17,11 процентного пункта, а не относительный рост на 17,11%. На WNLI Mistral Large достигает 52,96% против 35,77%, то есть плюс 17,19 пункта. Но GPT-4o на RTE показывает 48,88% против случайных 50,83%, Gemini Ultra на SST-2 — 49,08% против 56,03%, а GPT-3.5 на QNLI лишь повторяет 55,11%.
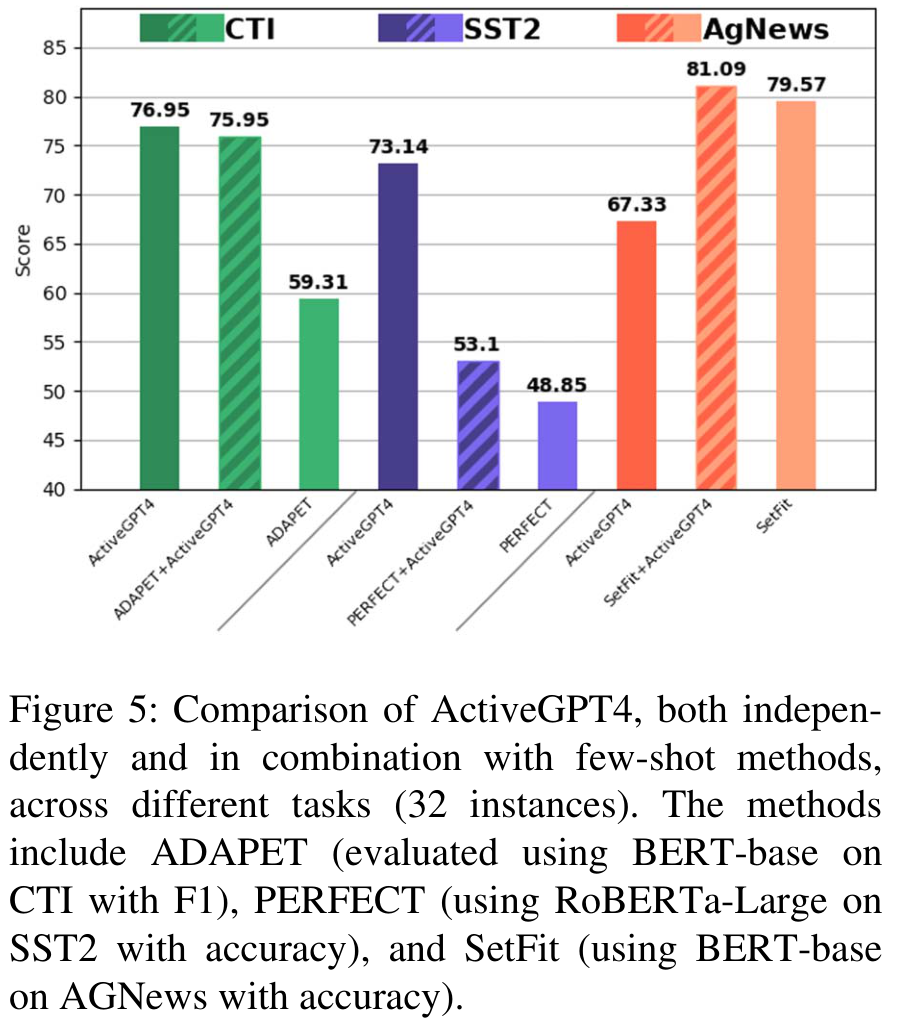
На рисунке 5 для CTI ActiveGPT4, ADAPET и их сочетание дают 76,95, 59,31 и 75,95 по шкале F1, умноженной на 100. На SST-2 ActiveGPT4, PERFECT и сочетание достигают 73,14%, 48,85% и 53,10%. Различия самостоятельного метода составляют 17,64 пункта F1 и 24,29 процентного пункта. На AG News SetFit улучшается с 79,57% до 81,09% при сочетании, а самостоятельный ActiveGPT4 дает 67,33%. ADAPET и SetFit используют BERT-base, PERFECT — RoBERTa-Large. Разные задачи, метрики и архитектуры нельзя свести к одному рейтингу.
Время отбора и сохраняющиеся затраты
Таблица 4 приводит время традиционных стратегий в минутах для выбора 32 примеров за шесть итераций активного обучения. BALD на QQP не дал результата за 48 часов; отсутствие значения не означает нулевую точность. Исключая повторное обучение классификатора во время отбора и рассматривая только часть кандидатов, ActiveLLM, по данным авторов, достигает времени запроса порядка секунд.
Однако работа не содержит полностью сопоставимой таблицы сквозных задержек и расходов API для каждой LLM. Из нее нельзя вывести точную кратность ускорения или экономии. При внедрении учитываются стоимость запросов, длина ввода, условия передачи данных и нагрузка на последующий классификатор.
Рост выборки и границы применимости
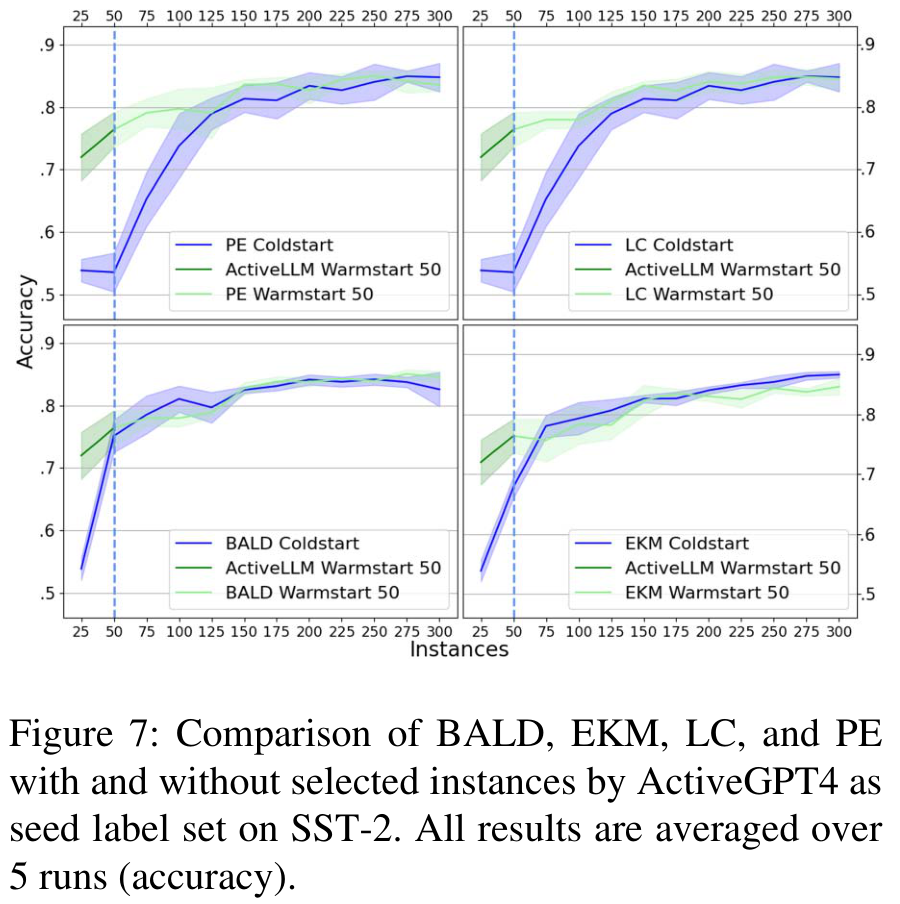
При отборе по 25 примеров за раунд до 300 преимущество заметнее примерно до 100 примеров, затем результат сближается со случайным отбором. Повторная передача идентификаторов уже выбранных примеров сохраняет историю без повторения всех текстов. Начальные 50 примеров от ActiveGPT4 помогают LC и PE, но аналогичного улучшения для EKM и BALD не получено.
Основная доказательная база относится к классификаторам семейства BERT, а не ко всем способам обучения генеративных моделей. Запрос разрабатывался преимущественно для GPT-4 и не оптимизировался отдельно под каждую LLM. Нельзя полностью исключить попадание бенчмарков в предобучение. Длинные тексты, скрытые инструкции сервиса, версии и настройки влияют на воспроизводимость. Отдельный конечный классификатор не устраняет вопрос конфиденциальности исходных текстов, переданных модели отбора.
Техническая структура с точки зрения патентного анализа
Задача состоит в выборе полезных примеров до появления надежного размеченного набора. Поток информации связывает LLM, пакет кандидатов, ограничения отбора, возвращаемые идентификаторы, разметку и последующее обучение. Центральна независимость селектора от обучаемого классификатора; размер пакета, формат номеров и напоминание истории дополняют эту конструкцию.
Эффекты зависят от сочетания модели, запроса, данных и бюджета разметки. Работа показывает смысл применения большой модели на этапе первоначального отбора в исследованных условиях, сохраняя отрицательные результаты и ослабление преимущества при росте выборки. Анализ архитектуры сам по себе не устанавливает новизну или патентоспособность. Улучшение на SST-2 — конкретный пример вклада, а не универсальная гарантия.
Сохранены исходные обозначения и формы; содержание раскрыто в тексте.
Рассмотренная работа: ActiveLLM (TACL 2026)
Опыт патентного поверенного Ким Ёндока в области ИИ