
Este artículo explica dos técnicas para mejorar los modelos de aprendizaje profundo: el entrenamiento Mixup y el suavizado de etiquetas.
Si hace clic en la imagen, puede ver el texto completo.
1) Entrenamiento de mezclas y 2) Lable suavizado descrito en este trabajo puede mejorar el rendimiento del aprendizaje profundo sin cambiar la arquitectura de aprendizaje profundo..
[Entrenamiento de Mixup]
Mixup Training extrae aleatoriamente dos datos de muestra de múltiples datos de aprendizaje para crear nuevos datos de aprendizaje. Tecnología relacionada con el aumento de datosLo es.
Tareas de clasificación de imágenes para gatos y perrosPor ejemplo, para ser más específico, véase a continuación.
Los datos de imagen del gato para aprender es "Esta imagen es un gato" etiqueta(ex. [0,1] se adjunta, y los datos de imagen del perro en el entrenamiento son "Esta imagen es un perro" etiqueta(ex. [1, 0], pero es común etiquetar datos de aprendizaje de esta manera.
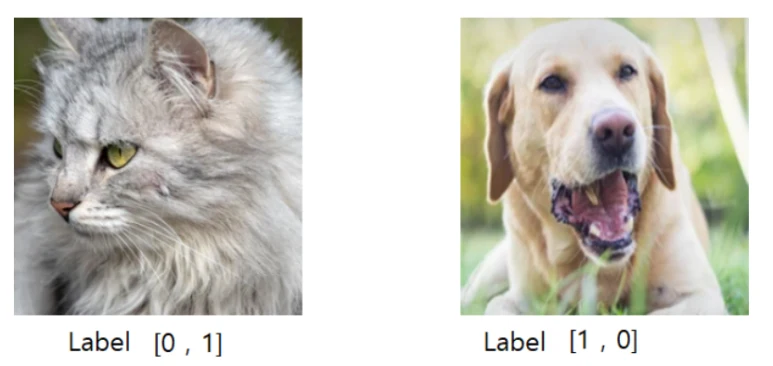
Formas comunes de etiquetar datos de aprendizaje
Formación de mezclasUtilizando los métodos descritos anteriormente, Cómo atar dos muestras para aprenderLo es.
Después de mezclar los datos de aprendizaje para cada perro y gato en parejas, es un entrenamiento de mezcla para utilizar los datos de mezcla como los datos de aprendizaje reales.
Al realizar el entrenamiento de mezcla, no sólo mezcla dos imágenes, sino que también mezcla etiquetas.Hagámoslo. Toma. lamda es un valor para lo que dos imágenes se mezclan enLo es. La probabilidad de que el valor de la lamba se configura a 0,5 es baja y los datos de aprendizaje se pueden configurar para que una imagen particular generalmente tome una proporción mayor. El valor de lamda se utiliza aleatoriamente por distribución beta.Hagámoslo.
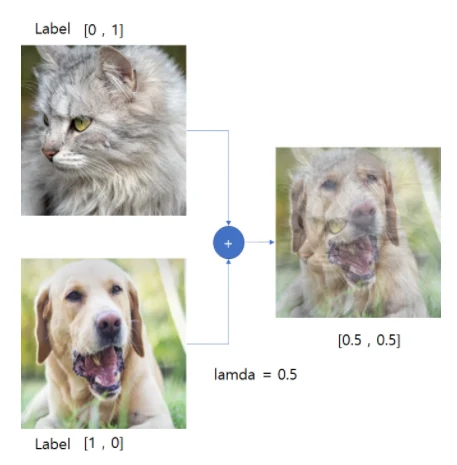
Formación de mezclas
Como se puede ver en el ejemplo anterior, las dos imágenes de aprendizaje se mezclan en la mitad, que puede parecer un poco incómodo. Sin embargo, a los ojos del perro, esta imagen se etiqueta como "un gato y un perro" (ex. [0.5, 0.5] para aprender. Evite el exceso de adaptaciónPuedes hacerlo. Y no sólo en términos de datos. A medida que aumenta el número de datos de aprendizaje, también lo hace el rendimiento.
[Label Smoothing].
Label Smoothing es una técnica para suavizar etiquetas para mejorar el rendimiento de la generalización. La gran diferencia con el entrenamiento de Mixup es que solo suaviza la etiqueta sin cambiar la imagen de entrenamiento.
Específicamente, digamos que hay varias hojas de datos de imagen y tres clases.
Si los datos de imagen son los datos de imagen tomados por el perro, es común dar a la clase de perro un valor de probabilidad de 1 y el resto de la clase un valor de probabilidad de 0, que se llama el método de etiqueta dura.
| Perro | Gato | Año Nuevo | |
| Datos de imagen 1 | 1 | 0 | 0 |
| Datos de imagen 2 | 0 | 1 | 0 |
| Datos de imagen 3 | 1 | 0 | 0 |
"El Label Duro"
Por otro lado, si los datos de imagen son los datos de imagen tomados por el perro, entonces la clase de perro no da 1, el resto de la clase 0. Dar un cierto valor de probabilidad a una clase que no sea la clase correcta.Esto se llama etiqueta suave.
| Perro | Gato | Año Nuevo | |
| Datos de imagen 1 | 0.9 | 0.05 | 0.05 |
| Datos de imagen 2 | 0.05 | 0.9 | 0.05 |
| Datos de imagen 3 | 0.9 | 0.05 | 0.05 |
Posts Tagged 'Label Smoothing'
El método de suavizado de etiquetas permite a la imagen disfrutar de un efecto de normalización sin hacerlo sobreconfiado cuando se da una imagen.Además, dado que el etiquetado de datos es generalmente realizado por una persona misma, puede haber datos que sean etiquetados incorrectamente por una persona. En este caso, la colocación de alta confianza en una clase particular para un dato particular puede causar una variedad de problemas. De este lado. Label suavizar suaviza las etiquetas de entrenamiento para mejorar la generalización.Lo es.
El entrenamiento de mezcla y el tabaquismo de etiquetas son similares a asegurarse de que el modelo no es sobreconfiado.
Este artículo del archivo refleja la situación en su fecha de publicación. Contacte con el despacho para analizar su caso.