
В статье рассматриваются два метода повышения эффективности глубокого обучения: обучение с Mixup и сглаживание меток.
Если вы нажмете на изображение, вы сможете увидеть полный текст.
1) Смешанное обучение и 2) Описанное в настоящей статье сглаживание поддающихся сглаживанию может повысить эффективность глубокого обучения без изменения архитектуры глубокого обучения..
[Тренировка миксов]
Mixup Training случайным образом извлекает два образца данных из нескольких обучающих данных для создания новых обучающих данных. Технология, связанная с расширением данныхТак и есть.
Задачи классификации изображений для кошек и собакНапример, если быть более конкретным, см. ниже.
Данные изображения кошки для обучения - это ярлык «Это изображение - кошка» (ex). [0,1] прикреплено, и данные изображения собаки в тренинге являются «Это изображение является собакой» этикетка (ex). [1, 0], но обычно маркировать данные обучения таким образом.
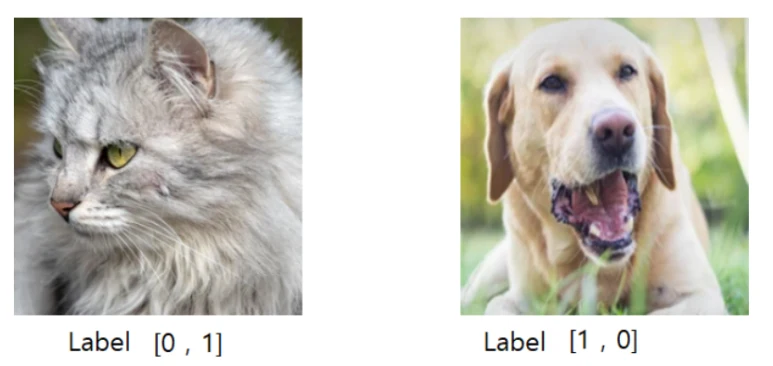
Общие способы маркировки данных обучения
Тренировка MixupИспользуя описанные выше методы, Как связать два образца для обученияТак и есть.
После смешивания данных обучения для каждой собаки и кошки в парах, это обучение смешиванию, чтобы использовать данные смешивания в качестве фактических данных обучения.
При выполнении обучения смешиванию вы не только смешиваете два изображения, но и смешиваете ярлыки.Давай сделаем это. Вот. lamda - это значение того, в чем смешиваются два изображения.Так и есть. Вероятность того, что значение lamba установлено на 0,5, является низкой, и данные обучения могут быть сконфигурированы таким образом, чтобы конкретное изображение, как правило, занимало большую долю. Значение lamda используется случайным образом бета-распределением.Давай сделаем это.
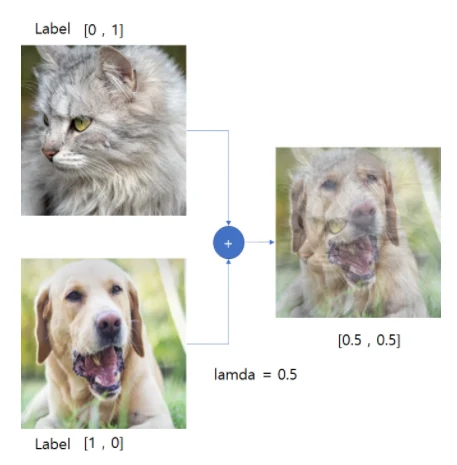
Обучение миксупа
Как видно из приведенного выше примера, два обучающих изображения перемешаны пополам, что может показаться немного неловким. Однако в глазах собаки это изображение помечено как «кошка и собака» (например). [0.5, 0.5] Учиться. Избегать чрезмерногоТы можешь это сделать. И не только с точки зрения данных. По мере увеличения количества обучающих данных увеличивается и производительность.
[Клеймо сглаживается]
Label Smoothing - это метод сглаживания этикеток для повышения производительности обобщения. Большая разница с обучением Mixup заключается в том, что он сглаживает только ярлык, не изменяя тренировочный образ.
В частности, предположим, что существует несколько листов данных изображений и три класса.
Если данные изображения являются данными изображения, взятыми собакой, обычно дают классу собаки вероятностное значение 1 и остальной части класса вероятностное значение 0, которое называется методом жесткой метки.
| Собака | Кошка | Новый год | |
| Данные изображения 1 | 1 | 0 | 0 |
| Данные изображения 2 | 0 | 1 | 0 |
| Данные изображения 3 | 1 | 0 | 0 |
«Твердый ярлык»
С другой стороны, если данные изображения являются данными изображения, взятыми собакой, то класс собаки не дает 1, остальную часть класса 0. Дать определенное значение вероятности классу, отличному от правильного класса.Это называется мягкой этикеткой.
| Собака | Кошка | Новый год | |
| Данные изображения 1 | 0.9 | 0.05 | 0.05 |
| Данные изображения 2 | 0.05 | 0.9 | 0.05 |
| Данные изображения 3 | 0.9 | 0.05 | 0.05 |
Материалы о сглаживании меток
Метод сглаживания меток позволяет изображению наслаждаться эффектом нормализации, не делая его слишком самоуверенным, когда изображение дается.Кроме того, поскольку маркировка данных обычно выполняется самим человеком, могут быть данные, которые неправильно помечены человеком. В этом случае высокий уровень доверия к определенному классу для конкретных данных может вызвать множество проблем. С этой стороны. Сглаживание этикеток смягчает учебные этикетки для улучшения обобщения.Так и есть.
Обучение смешиванию и курение этикеток аналогичны тому, чтобы убедиться, что модель не слишком самоуверенна.
Материал отражает ситуацию на дату публикации. Обратитесь в IPLEX, чтобы обсудить обстоятельства вашего дела.